
设备管理
1 设备引入*
典型的系统架构:通用 I/O 总线和多个外围总线用于连接设备
- 物理和成本:总线速度越快,长度就必须越短
- 需要高性能的设备更靠近 CPU
现代系统通常使用专用芯片组来提高性能
I/O 设备大体可以分类为:
- 块设备
- 以固定大小的块存储信息
- 传输单位为整个块
- 字符设备
- 传递或接受字符流
- 不可寻址,没有任何寻址操作
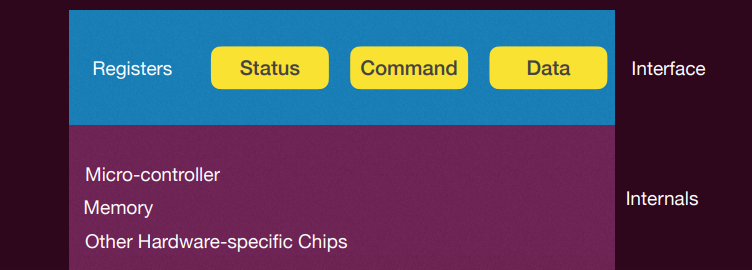
一个典型设备有两个重要组成部分
- 向系统其余部分呈现的硬件接口
- 内部结构
设备接口由几个寄存器组成
- 状态寄存器:读取以查看设备的当前状态
- 命令寄存器:指示设备执行特定任务
- 数据寄存器:将数据传递给设备或从设备获取数据
CPU 和设备的通信:与控制器交互,以两种方式访问寄存器:
- 端口映射 I/O:提供额外的 I/O 指令
- 每个控制寄存器被分配一个 I/O 端口号
- 使用特殊的 I/O 指令(
in、out) - 这些指令通常是特权指令
- 内存映射 I/O:将所有控制寄存器映射到内存空间中
- 每个控制寄存器被分配一个唯一的内存地址
- 为了访问特定的寄存器,操作系统发出一个
load指令(读取)或store指令(写入)该地址 - 然后硬件将
load/store指令指向到设备而不是主存储器
Loop: test memory_mapped_io_arddress //check the status of device
      jz ready // if it is 0, go to ready
      goto loop // otherwise, continue testing
ready:
- 第一次 test 这个 address 的值会被缓存到 cache 中
- 之后的轮训 test 是直接从 cache 中取值,无法反映设备的真正状态
- 因此一般要禁掉相应内存地址的缓存
在发出与设备通信的指令后,操作系统需要获知状态(完成/错误),两种方法:
- 轮询:操作系统定期检查设备特定的状态寄存器
- 开销低(没有切换),但如果是低速的设备上会浪费 CPU 周期
- I/O 中断:设备在需要服务时生成中断
- 不会浪费 CPU 周期,但是开销高(伴随切换)
一般来说两种混合
由 CPU 来控制:
- 即 Programmed I/O
- 直接通过处理器的
in/out或load/store传输每个字节 - 优点:硬件简单,易于编程
- 消耗与数据大小成比例的处理器周期(因为每个数据的
in/out都要一个指令) - 此外,CPU 会一直接收到中断,速度变慢
由直接内存访问(DMA)控制
- 给控制器访问内存和总线的权限
- 要求它直接在内存和控制器之间传输数据块
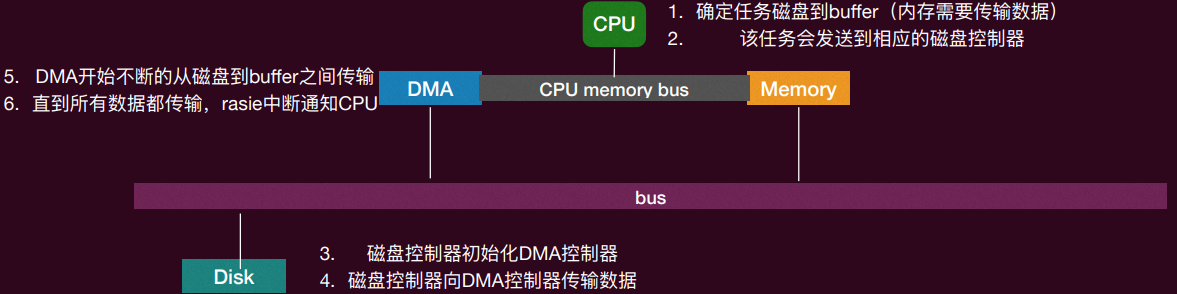
计算机系统内部不只是有通用的 CPU
- 专门负责
memcpy()的 CPU:DMA - 专门负责解析和显示图形的 CPU:GPU
- 很多设备都有自己的逻辑处理芯片(比如磁盘)
- I/O 管理可以看成是中央芯片(CPU)和外部芯片的交流
人手一个通用 CPU?通用性增加了很多设计以及与之而来的功耗
2 硬件抽象 —— 设备驱动程序
设备驱动程序是操作系统和物理硬件之间沟通的 “桥梁”
世界上有成千上万种硬件设备,它们由不同的厂商制造。操作系统不可能(也不应该)把所有硬件的具体控制细节都内置在内核中。因此,操作系统通过设备驱动程序来与这些硬件进行交互。
- 操作系统创建了一个分层的存储视图
- 分层方法允许更低层部分容易更改
- 例如,文件系统的实现独立于磁盘类型
- 管理 I/O 设备的代码在内核设备驱动程序中
- 设备驱动程序是内核错误的最常见来源
- 这是由于给定的驱动程序可能只被少数系统使用,所以它不会被高度使用或仔细检查
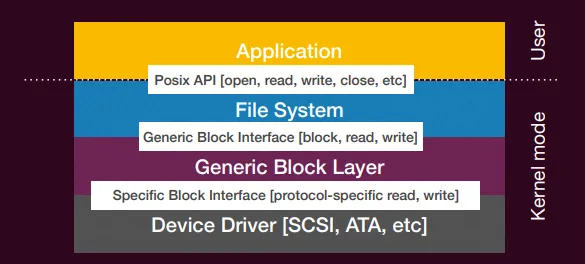
设备驱动程序通常分为两部分:
- 上半部分:在系统调用的调用路径中访问
- 实现一组标准的、跨设备的调用,如
open()、close()、read()、write() - 这是内核与设备驱动程序的接口
- 上半部分将启动设备的 I/O 操作,可能会让线程休眠直到完成(同步和异步I/O)
- 实现一组标准的、跨设备的调用,如
- 下半部分:作为中断例程运行
- 获取输入或传输下一块输出
- 如果 I/O 现在完成,可能会唤醒休眠的线程
一次 IO 请求的生命周期如下
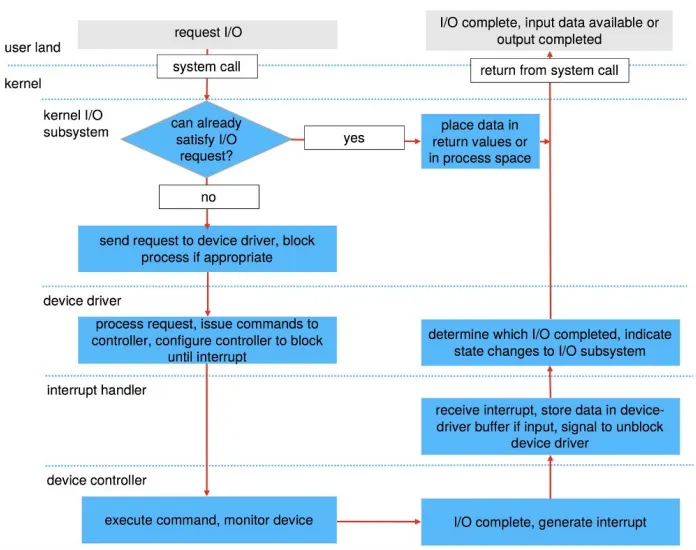
3 磁盘
将数据磁性地储存在与玻璃、陶瓷或铝等材料的旋转盘上粘合的薄金属膜上
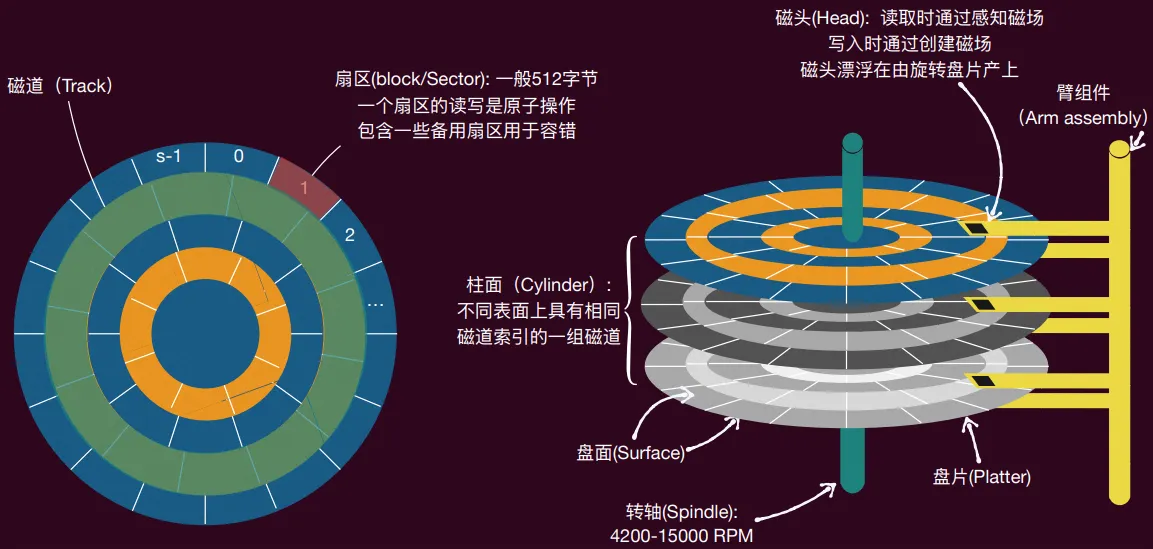
3.1 磁盘读写
- 磁头移动到适当的磁道
- 寻道时间
- 稳定
- 启用适当的磁头
- 等待扇区出现在磁头下
- 旋转延迟
- 读取/写入扇区
- 传输时间
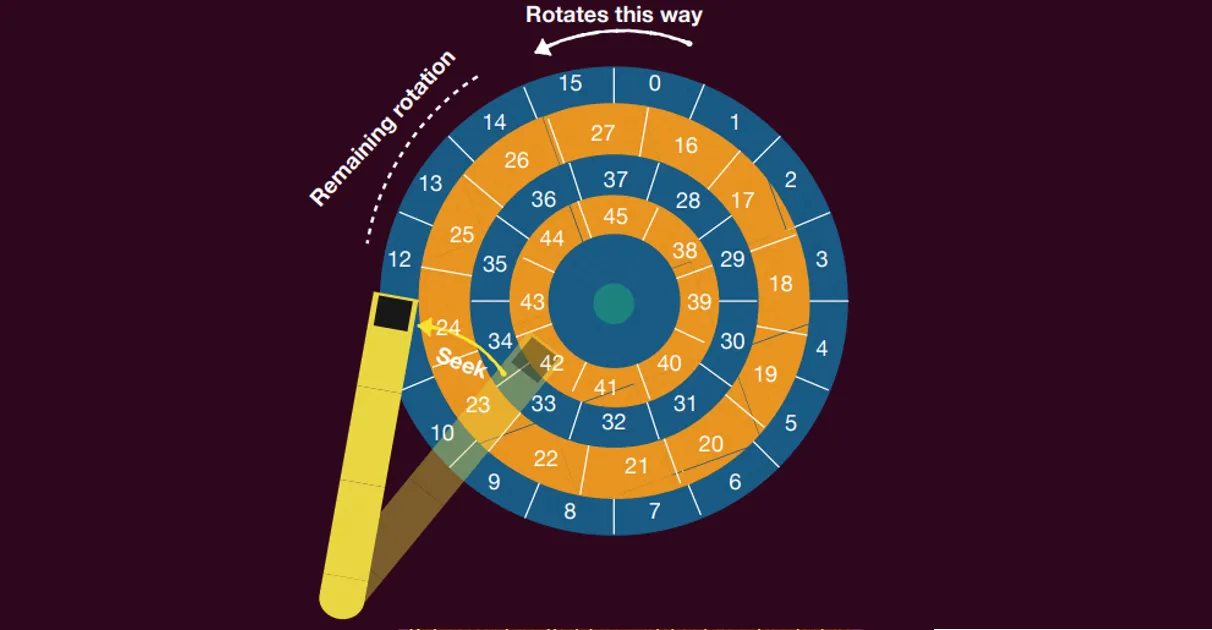
- 磁盘访问时间:\(T_{I/O} = T_{seek} + T_{rotation} + T_{transfer}\)
- 磁盘传输速率:\(R_{I/O} = \dfrac{Size_{transfer}}{T_{I/O}}\)
- 在顺序工作负载中传输 100 MB 数据
- \(T_{seek} = 4\ \text{ms}\) (average seek)
- \(T_{rotation} = 2\ \text{ms}\) (average rotation)
- \(T_{transfer} = 0.8\ \text{s}\)
- \(R_{I/O} = 100\ \text{MB} / 0.806\ \text{s} = 124\ \text{MB/s}\)
磁道偏移:确保在跨越磁道边界时能够正确处理顺序读取
- 从一个磁道切换到另一个磁道时,磁盘需要时间重新定位磁头
- 如果没有这样的偏移,磁头会被移动到下一个磁道,但所需的下一个数据块已经旋转到磁头后面了(得重新转一圈才能读到)
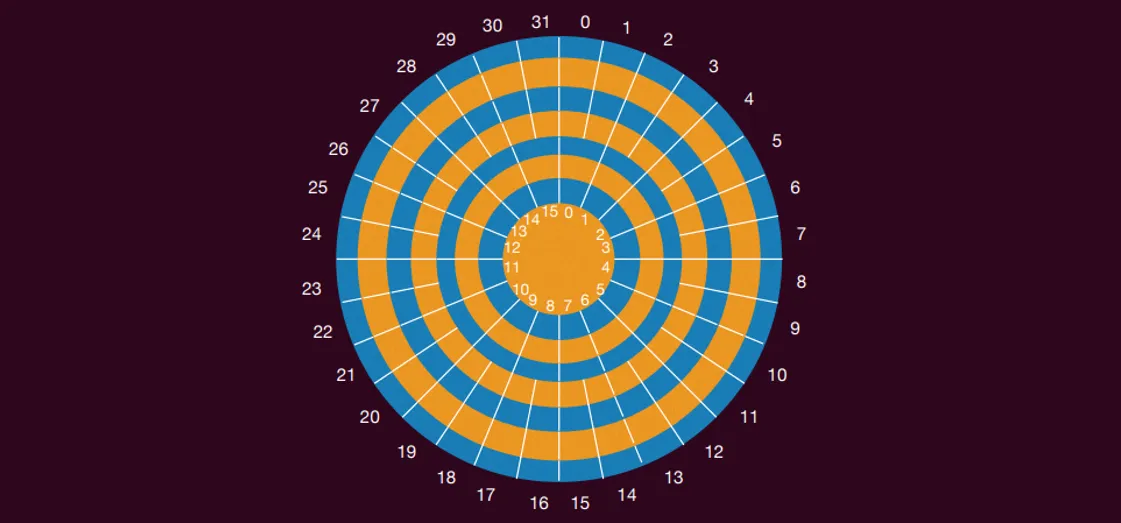
多区域磁盘驱动器:外部磁道比内部磁道有更多的扇区
- 磁盘被组织成多个区域,每个区域是表面上一组连续的磁道
- 每个区域的每条磁道的扇区数相同
- 现代磁盘支持逻辑块寻址(不考虑磁盘几何结构)
缓存(磁道缓冲区):一些小容量的内存,用于存储从磁盘读取或写入到磁盘的数据
- 读取扇区时,会读取该磁道上的所有扇区
- 写入时,有两种写入策略:当数据被放入缓存时(写回,write back)或数据实际写入磁盘后(直写,write through)才确认写入
- 缓冲区在磁盘的逻辑板上
3.2 磁头调度
目标:通过磁头调度来最小化磁头移动,从而最大化磁盘 I/O 吞吐量
3.2.1. 先到先服务(FCFS)
按请求到达的顺序处理磁盘请求
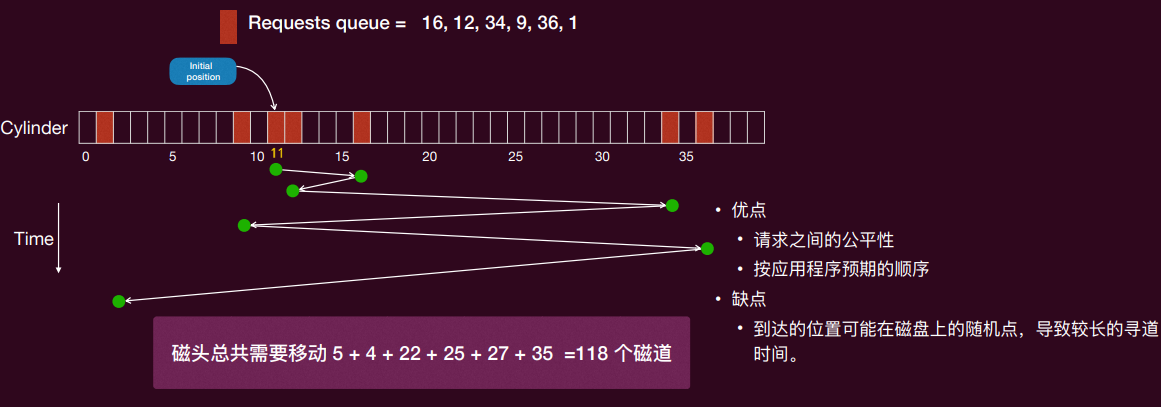
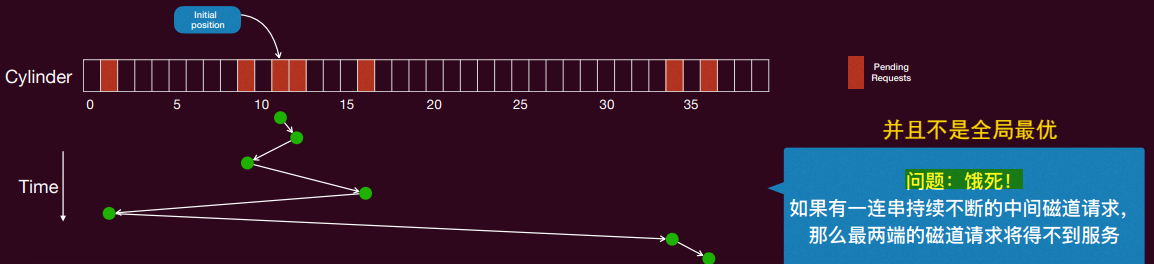
3.2.2. 最短寻道时间优先(SSTF)
按磁道顺序排列 I/O 请求队列,优先处理最接近磁道的请求。
- 最小化寻道时间
- 假设当前磁头位置在内轨道上,则依次处理请求 35(中间),然后再处理请求 6(外部)
假设第一个请求是磁道(柱面)11,随后依次有新请求进入,分别是磁道 1、36、16、34、9 和 12
- 最短寻道时间优先:1 + 3 + 7 + 15 + 33 + 2 = 61 个磁道
3.2.3. 电梯算法(扫描算法,SCAN)
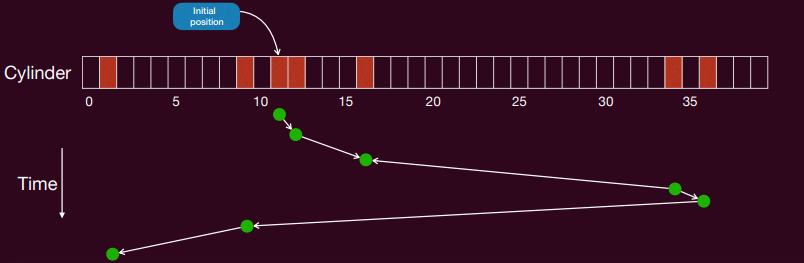
简单地在磁盘上来回移动,按顺序跨磁道处理请求(像电梯一样运行)
- 从磁盘的一端(从外轨到内轨或从内轨到外轨)的单次通过称为一次扫描
- 磁臂移动距离为:1 + 4 + 18 + 2 + 27 + 8 = 60 个磁道
有多种变体可用:
- F-SCAN:在执行扫描时暂时冻结要处理的队列(避免远距离请求的饥饿)
- C-SCAN:只从外轨到内轨扫描,然后重置到外轨重新开始
- 更平均的等待时间,即对内轨和外轨更公平
3.2.4. 最短定位时间优先(SPTF)
同时考虑寻道时间和旋转时间
- 假设当前磁头位置在第 42 扇区(内轨),那么是处理请求 32(中间)还是请求 13(外轨)?
- 如果寻道时间远高于旋转延迟,那么最短寻道优先(SSF)是好的选择
- 但如果寻道速度比旋转快得多,那么应先处理请求 13
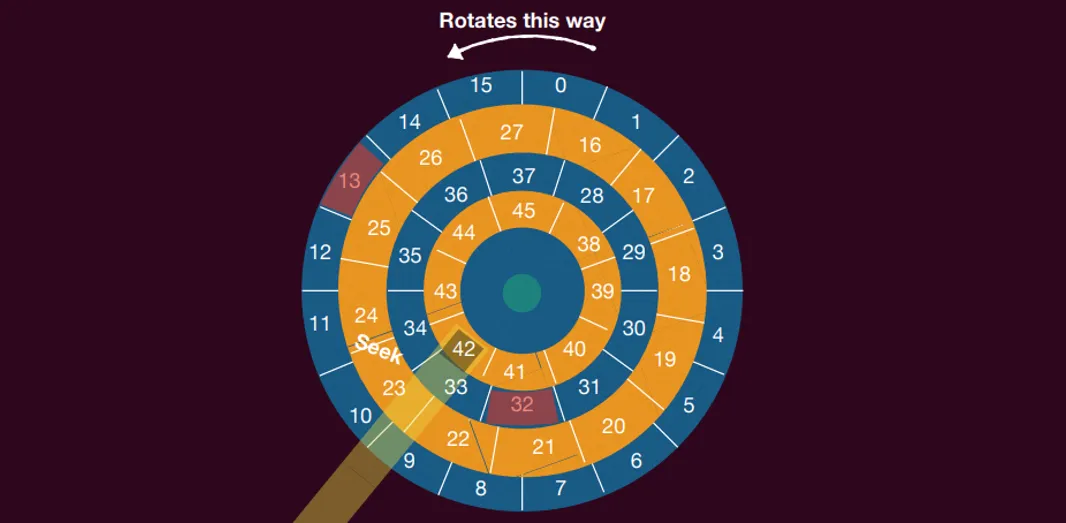
在操作系统中实现这一点很困难,因为操作系统通常不清磁头当前的具体位置
- 各种设备驱动程序就是为了实现统一的接口
- 另外一个视角:I/O 就是各个 CPU(通用和专用)的交流,驱动程序就是解释器
标题:设备管理
作者:Zwing
创建于:2026-08-09 00:07:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/持久化-设备管理.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可