
地址空间
1 内存管理
有了进程抽象,内存就有了 “语义”:当前进程的 “状态”,而这个 “状态” 应该遵循状态机(即进程)的规约而改变
早期操作系统直接使用物理内存:
- 使用装载器/链接器:在程序加载到内存时转换为绝对地址(静态重定位)
- 一个程序中的 bug 会导致其他程序也 crash,程序也没有被禁止访问其他进程的地址
- 添加保护位,进程访问一块内存时 CPU 检查进程 Key 与内存 Key 是否匹配
- 需要太多寄存器,不现实
- 利用基址和界限来保护各自内存
- 超出则抛出异常
使用物理内存的缺点:
- 一个应用会因其他应用的加载而受到影响(加载器压力骤增)
- 一个应用可通过自身的内存地址,猜测出其他应用的加载位置
1.1 虚拟内存抽象
以虚拟内存抽象为核心的内存管理:
- CPU:支持虚拟内存功能,新增了虚拟地址空间
- 通过 MMU 翻译为物理地址
- 操作系统: 配置并使能虚拟内存机制
- 所有软件: 均使用虚拟地址,无法直接访问物理地址
每个应用程序拥有独立的虚拟地址空间
- 应用程序认为自己独占整个内存(透明性)
- 应用程序不再看到物理地址
- 应用加载时不用再为地址增加一个偏移量
1.2 地址翻译
翻译就是一个函数 f: 其将 <pid, virtual address> 映射到物理地址
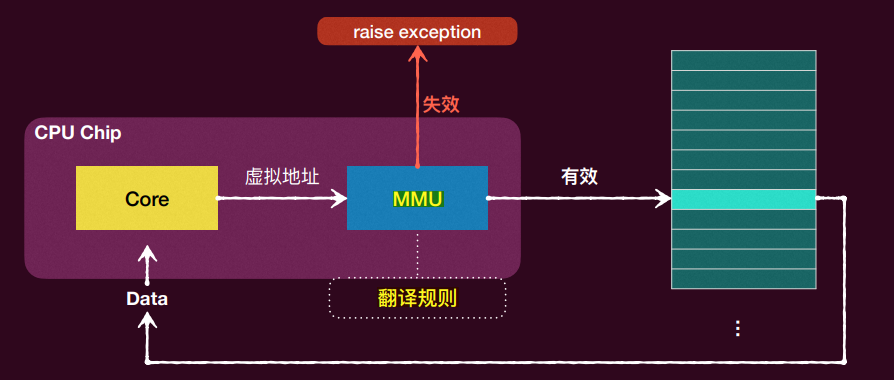
优点:可以很自然地提供保护、重定位、数据共享、连续空间假象
- 保护:让不同的进程映射到不同的区域即可(即两个进程的映射函数的值域不相交)
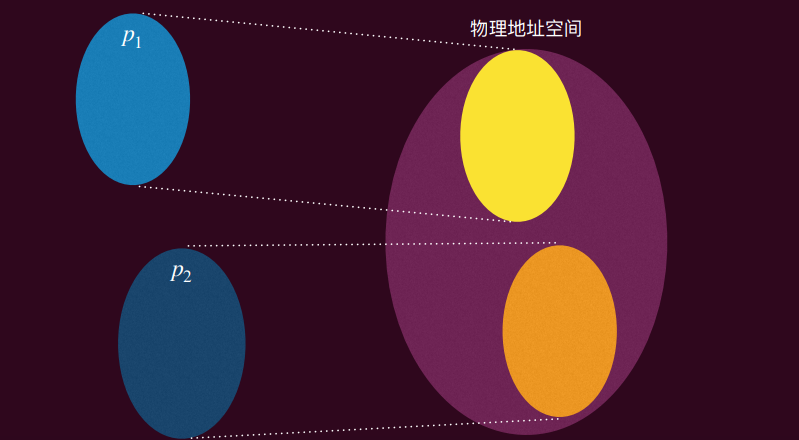
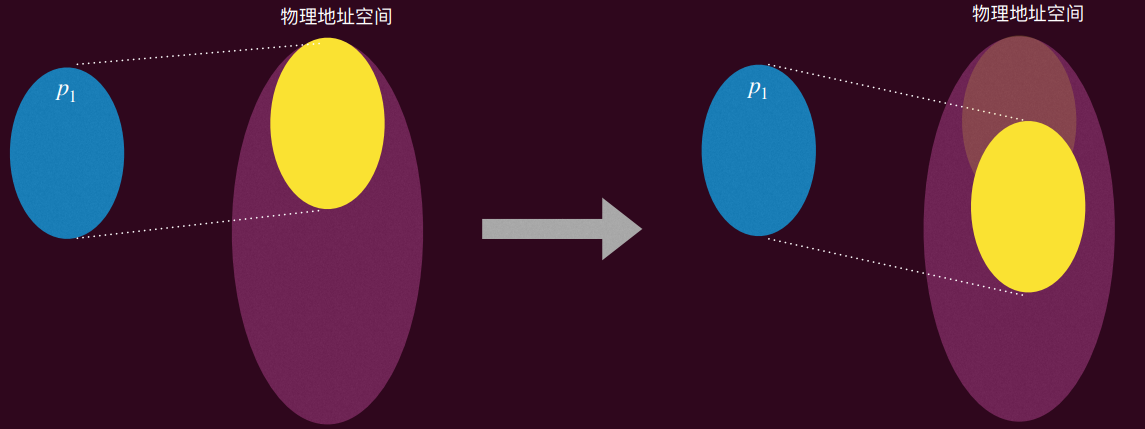
- 重地位:进程被映射到的物理地址可以在运行时不断变化(运行时,不是编译时,因此是动态重定位
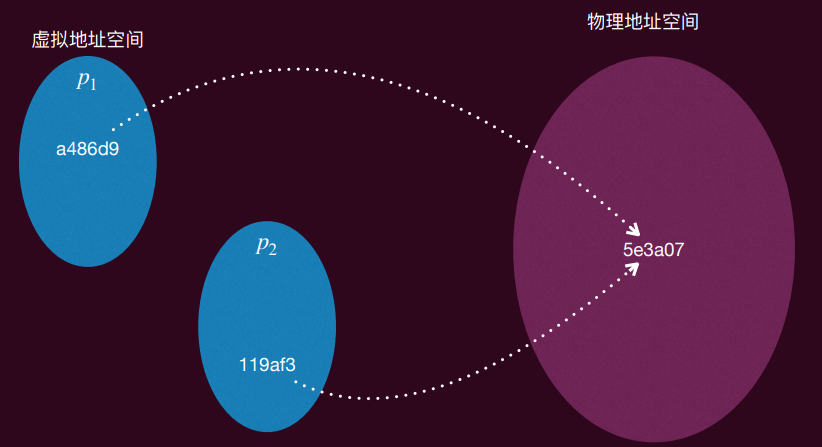
- 数据共享:将不同进程的不同虚拟地址映射到同一个物理地址
- 构建连续空间假象:虚拟地址中的连续地址空间(编程友好),映射到物理内存可以不必连续
2 连续内存分配*
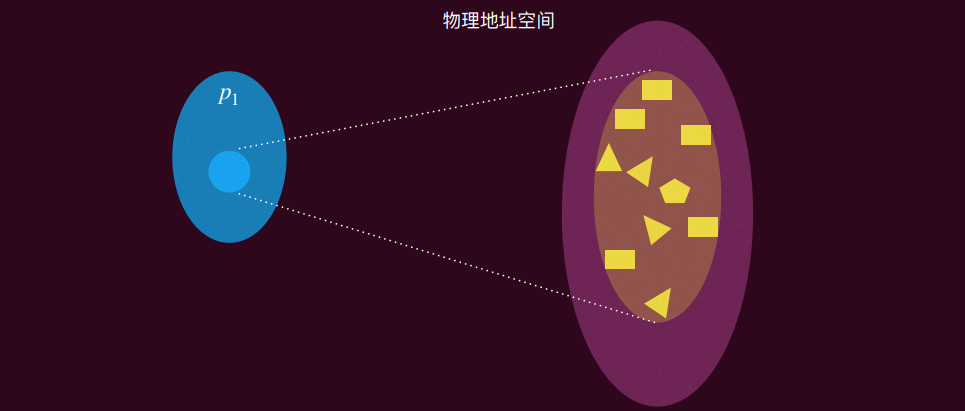
进程(包括操作系统内核)被分配一个连续的物理内存地址
- 利用基址和界限机制隔离用户进程之间的地址空间,以及防止用户进程修改操作系统的代码和数据
多个进程时需要将物理内存进行分割,每个进程占据一个连续的物理内存分区,有两种分割方式
2.1 可变分区
物理内存一开始就被分为 “固定” 大小的区域,各个区域的大小可以相同,也可以不同,一个进程选择一个空闲区域进行分配。固定分区的问题:
- 无法放下所需空间过大的进程
- 内部碎片
- 固定分区数限制了进程数
可变分区:物理内存区域大小和数量是可变的,根据进程的具体需要分配相应的空间
- 当进程需要加载到内存时,操作系统从一个足够大的空闲块分配内存
- 当进程终止时释放其分区,并且与相邻的空闲分区合并
- 鉴于大多数进程在运行时会增长,在加载进程时会分配一些额外的内存
- 如果给进程所分配的区域用完,那么该进程将可能:
- 被移动到一个有足够空间的空闲区域中
- 被交换出内存(至磁盘),直到能够创建一个足够大的空洞
- 或者直接被终止
2.2 碎片
无法被分配的未使用内存
- 外部碎片(空洞):由于分散的小的不连续的空闲空间导致的内存浪费,发生在分区之间,通常是由于进程的不断加载和释放造成
- 内部碎片:由于分区大小和加载的进程大小之间的差异(即进程小于分配的分区)导致的内存浪费,发生在分区内
2.3 外部碎片的处理方法
内部碎片只能靠好的分配策略解决
- 进程终止或暂时交换出磁盘,可以释放内存,可能会合并一些碎片形成大的可分配区域
- 通过紧缩减少外部碎片化
- 重排内存内容以将所有空闲内存放在一起
- 时间复杂度较高(一般在系统实在没有内存的情况下才会做)
2.4 空闲内存管理
为了实现动态可变分区内存分配,操作系统应维护以下信息:
- 已分配的分区
- 空闲的分区(空洞)
一种简单的办法:位图
- 内存被划分为分配单元(几字节到几千字节)
- 每个分配单元对应位图中的一位,如果该单元空闲则该位为 0,如果被占用则该位为 1
必须搜索位图以找到 k 个连续的 0 位来加载一个k单元的进程
- 一个更加常用的做法:空闲内存链表
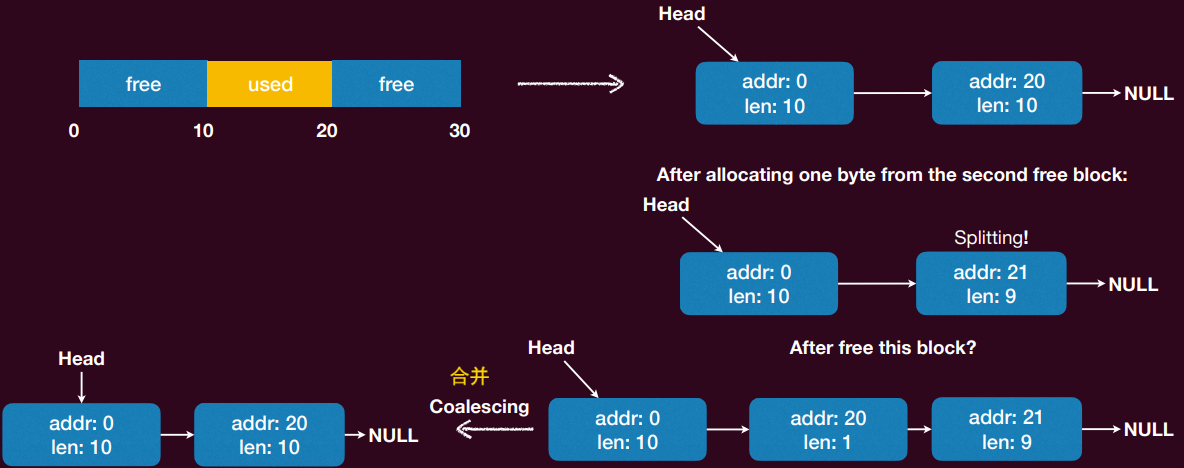
还需要跟踪已分配区域的大小,这样 free(*p) 时才能正确的返回一个正确的空闲结点
- 方法:
malloc时多分配一点空间记录元信息
2.5 基本分配策略
不同的策略会影响分配和回收的性能和有效性(比如碎片数量)
- Best-fit:分配最小的足够大的空闲区域(尽可能物尽其用),需要遍历整个列表
- 但可能导致产生微小且无用的外部碎片
- Worst-fit:分配最大的空闲区域
- 剩余的部分最大,可以为其他进程所占用,而不是形成碎片,但同样遍历整个列表
- First-fit:分配第一个足够大的空闲区域(尽可能少搜索)
- Next-fit:跟踪上次适配的位置,并从上次搜索结束的地方开始搜索(尽可能均匀的搜索整个空间)
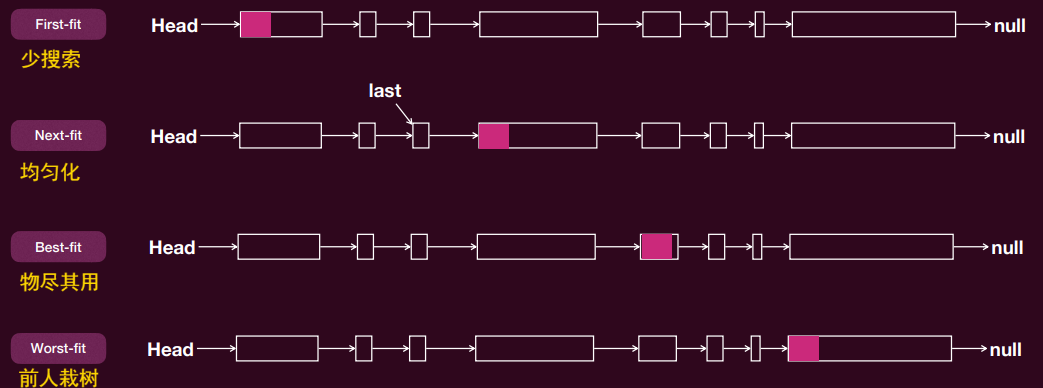
- 链表查找还是低效的,使用红黑树会更好
free后的合并?
- 链表空闲节点按地址进行链接,
free时扫描整个链表- 更高效的合并:伙伴系统
2.6 伙伴系统
使用 2 的幂分配器分配内存
- 按 2 的幂大小单位满足请求:请求向上舍入到下一个最高的 2 的幂
- 当需要比可用空间更小的分配时,当前块被分割为两个下一个较低 2 的幂的伙伴
- 持续进行直到有适当大小的块可用
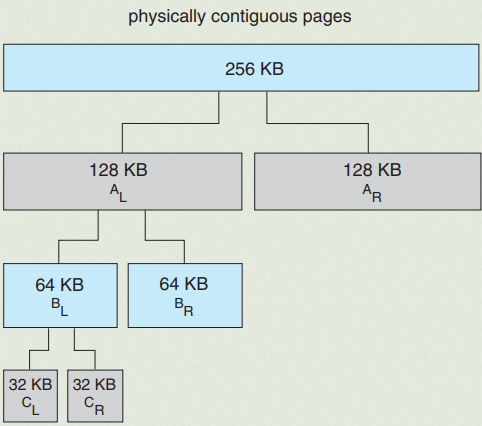
- 合并效率高:一个块被归还后,检查其伙伴是否空闲,若是则合二为一,并递归上溯
- 伙伴的地址非常容易得到
- 只有一位不同,这一位决定了它们在整个伙伴树中的层次
- 大小为 \(2^k\) 的块的地址是 \(2^k\) 的倍数(右边有 \(k\) 个零)
- 比如一个 \(2^5\) 的地址:
xxx...xx00000 - 分割之后,两个伙伴块大小为 \(2^4\),地址分别为:
xxx...xx0000xxx...xx1000
内部碎片问题无法解决
2.7 Slab 分配器
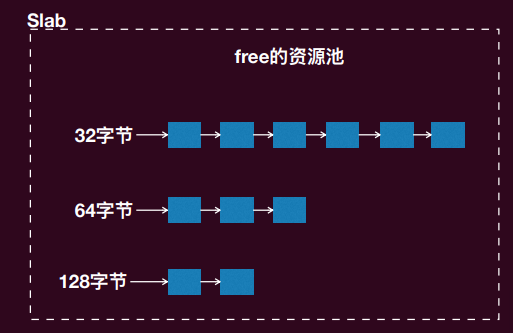
经验观察:系统频繁分配的对象大小相对比较较小且固定 目标:快速分配小内存对象
- 从伙伴系统获得大块内存
- 进一步细分成固定大小的小块内存进行管理
- 块大小通常是 \(2^n\) 个字节(一般来说,\(3 \le n \le 12\))
- 可以额外增加特殊大小(频繁使用的数据结构大小)如 198 字节从而减小内部碎片
- 对于每个固定块大小,Slab 分配器都会使用独立的内存资源池进行分配
- 采用 best fit 定位资源池
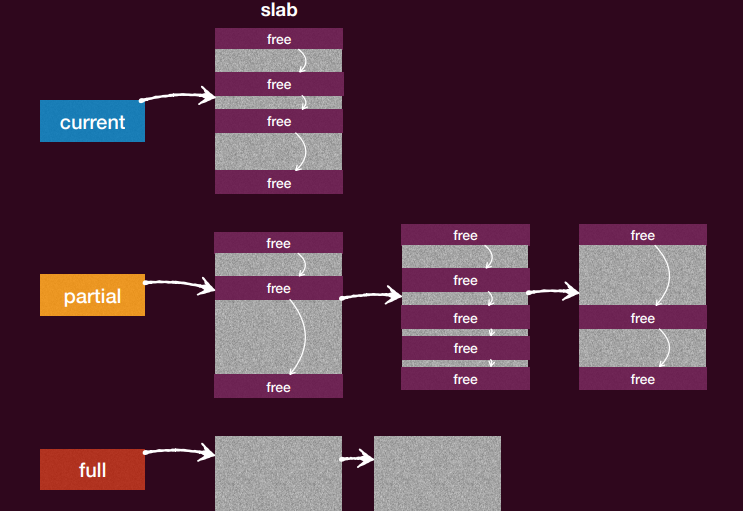
三个指针:
- current 仅指向一个 slab
- partial 指向未满 slab 链表
- full 指向全满 slab 链表
分配使用 current slab (per-cpu)
- 若满:移动到 full slab
- 从 partial 里申请一个
释放时放到对应的 slab
- 若是 full,移到 partial
- 如果 partial 全是 free,则还给 buddy system
- Fast path:Per CPU 从当前 slab 中取出一个适合大小的块
- low path:需要从一个全局的 partial 里去找一个作为当前的 slab,不巧的话(paritial 里也没空闲内存),甚至需要从 buddy system 里重新分配连续空间,再次分割为可用的 slab
kmalloc 是内核运行时申请内存的通用 slab
2.8 连续内存分配的问题
- 如果直接分配给进程内存的话,stack 和 heap 中间的部分都被浪费了
- 内部碎片无法避免
- 无法和其他进程共享内存(比如代码和共享库)
- 主要是保护机制粗糙,整体空间的保护,没有精细到具体的部分内存
3 分段*
用户视角的内存管理
- 将程序视为一组段
- 段是虚拟内存空间中连续区域的一个逻辑单元
- 例如代码段、栈、堆等
- 每个段独立映射到物理内存中的一组连续地址
- 没有特定的顺序
- 不需要映射未使用的虚拟地址
- 可以消除内部碎片
- 不同的段可以独立增长或缩减
3.1 分段底层机制
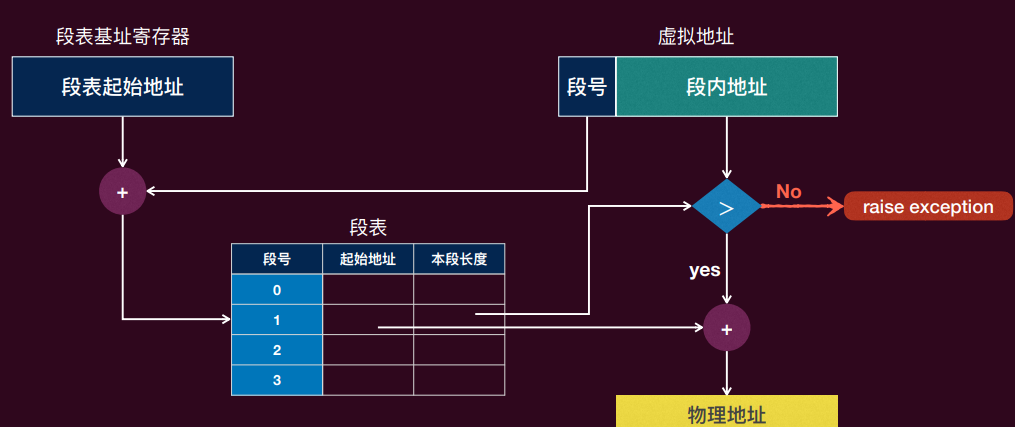
- 虚拟地址空间分成若干个不同大小的段
- 段表(每个进程一个)存储着每个分段的信息(由段号索引),可供 MMU 查询
- 段基址:段在内存中所在的起始物理地址
- 段界限:段的大小
- 虚拟地址分为: 段号 + 段内地址(偏移)
- 物理内存也是以段为单位进行分配
- 虚拟地址空间中相邻的段,对应的物理内存可以不相邻
3.2 支持共享
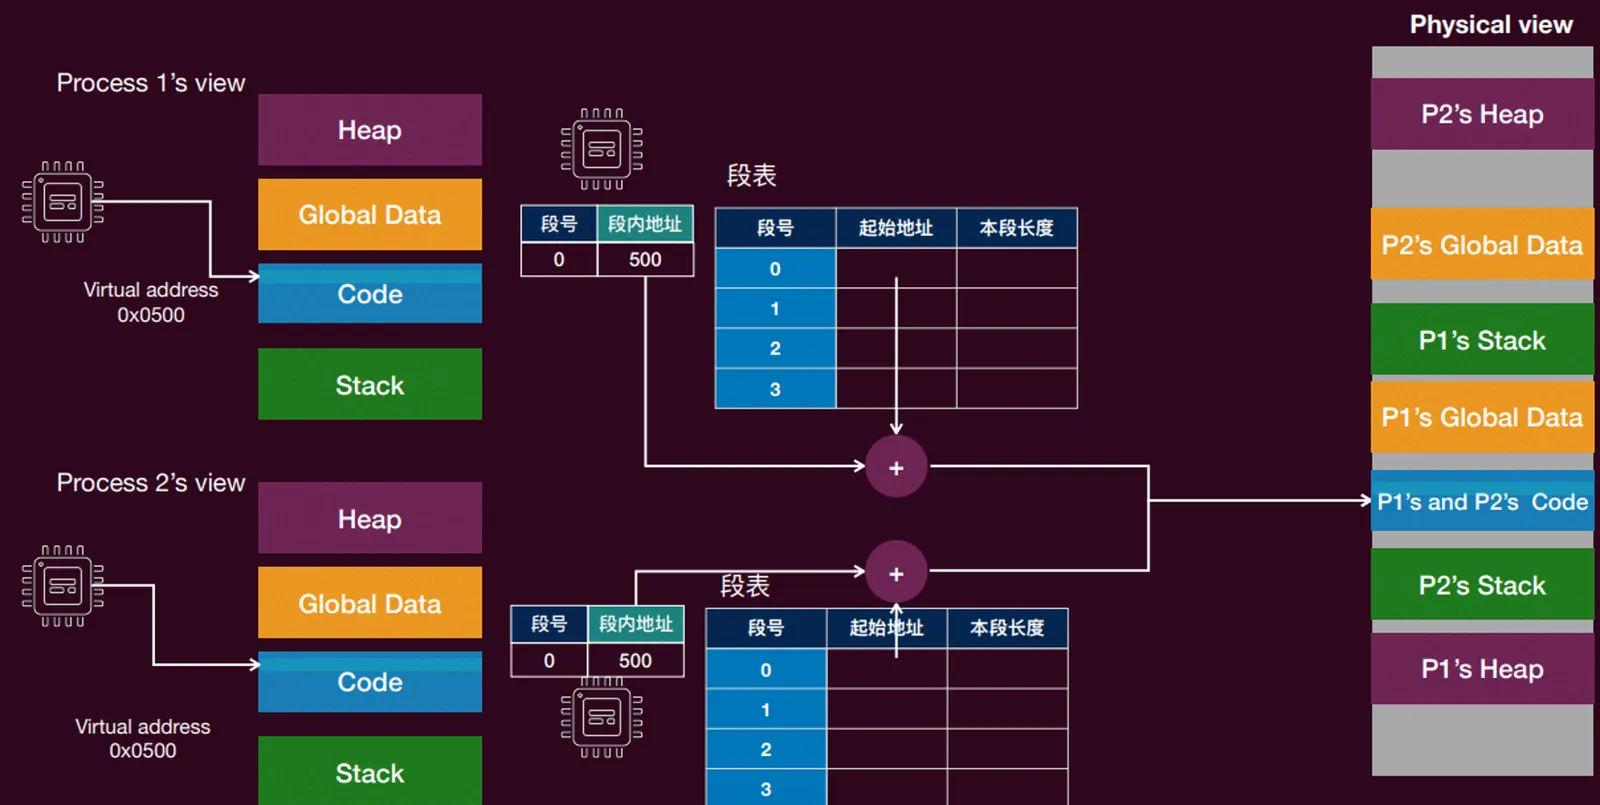
- 多个虚拟地址空间可以映射到内存中的同一物理段
- 如:只读代码的一个副本在进程间共享,一个可执行文件被加载多次
- 也可以用作进程间通信
- 段表需要增加保护位
- 指示程序是否具有相应段的读/写/执行权限
- 每个进程仍然认为它在访问自己的私有内存(透明性)
3.3 OS 对段表机制的支持
- 操作系统应在上下文切换时保存和恢复段表(指向段表的寄存器)
- 当段增长或缩小时,操作系统应进行交互(更新段表)
- 创建新的地址空间时,操作系统应在物理内存中为其段找到空间
- 操作系统维护着空闲内存块
- 由于段的长度各不相同,内存分配是一个动态内存分配问题
- 需要分割和合并
4 分页
更细粒度的内存管理
- 物理内存被划分成连续的、等长的物理页(也叫帧 frame)
- 大小一般为 2 的幂,比如默认是 4KB (\(2^{12}\) Byte)
- 虚拟内存也被划分为相同大小的虚拟页(page)
- 任意虚拟页可以映射到任意物理页
- 没有外部碎片:都是按照页为单位分配内存
4.1 分页机制
每个进程都有一个页表,每个页表项包含一个物理页号,指示每个页在物理内存中的基地址
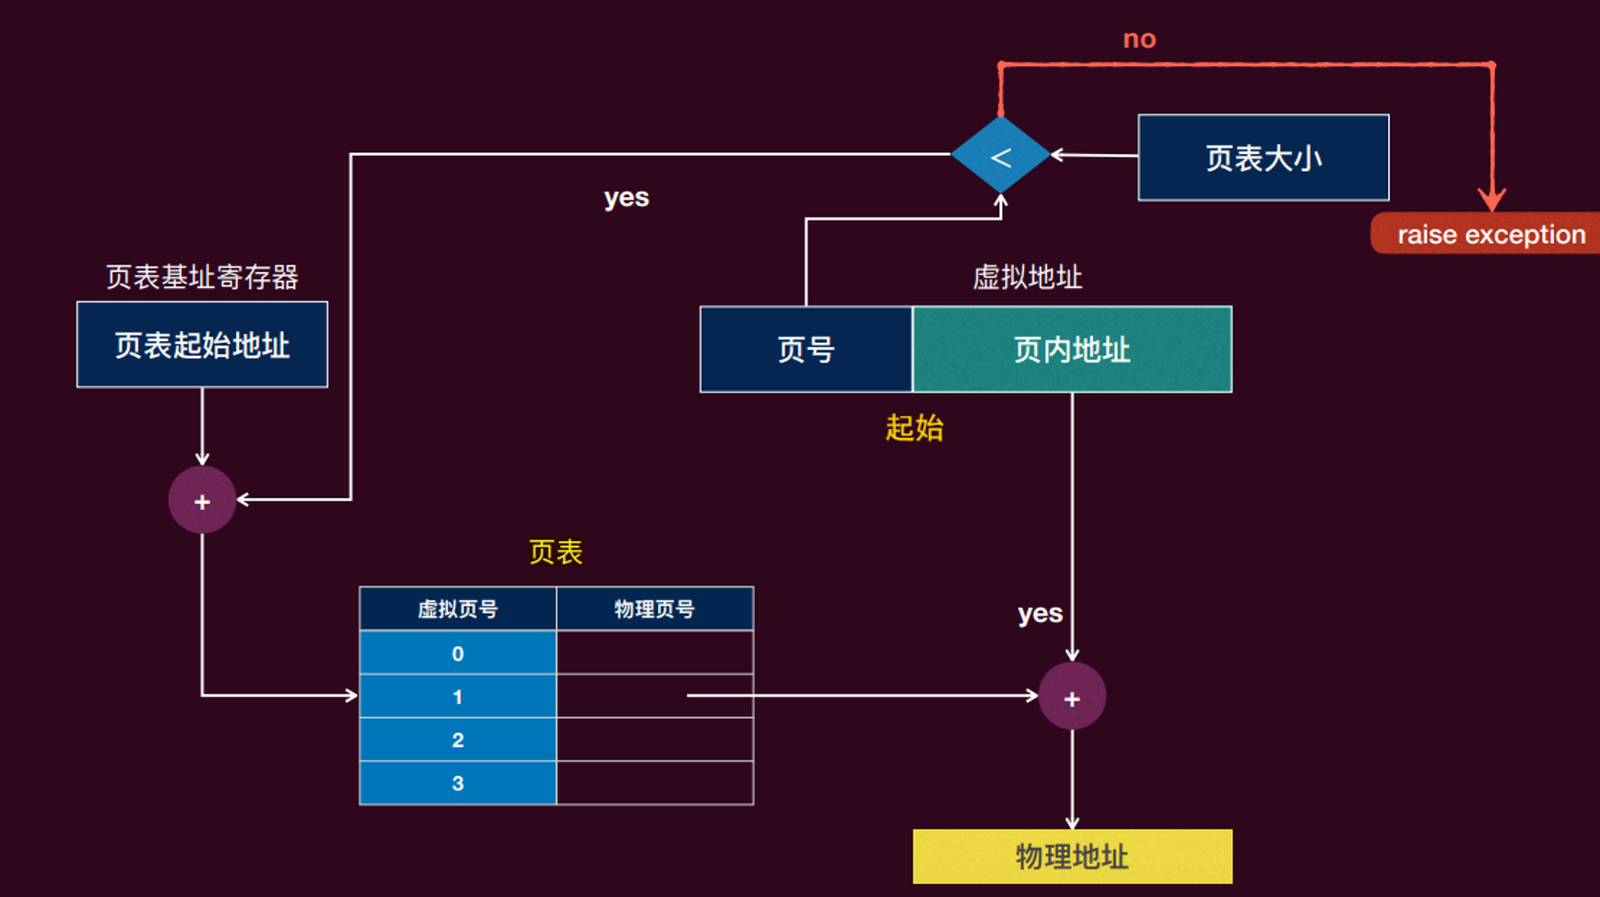
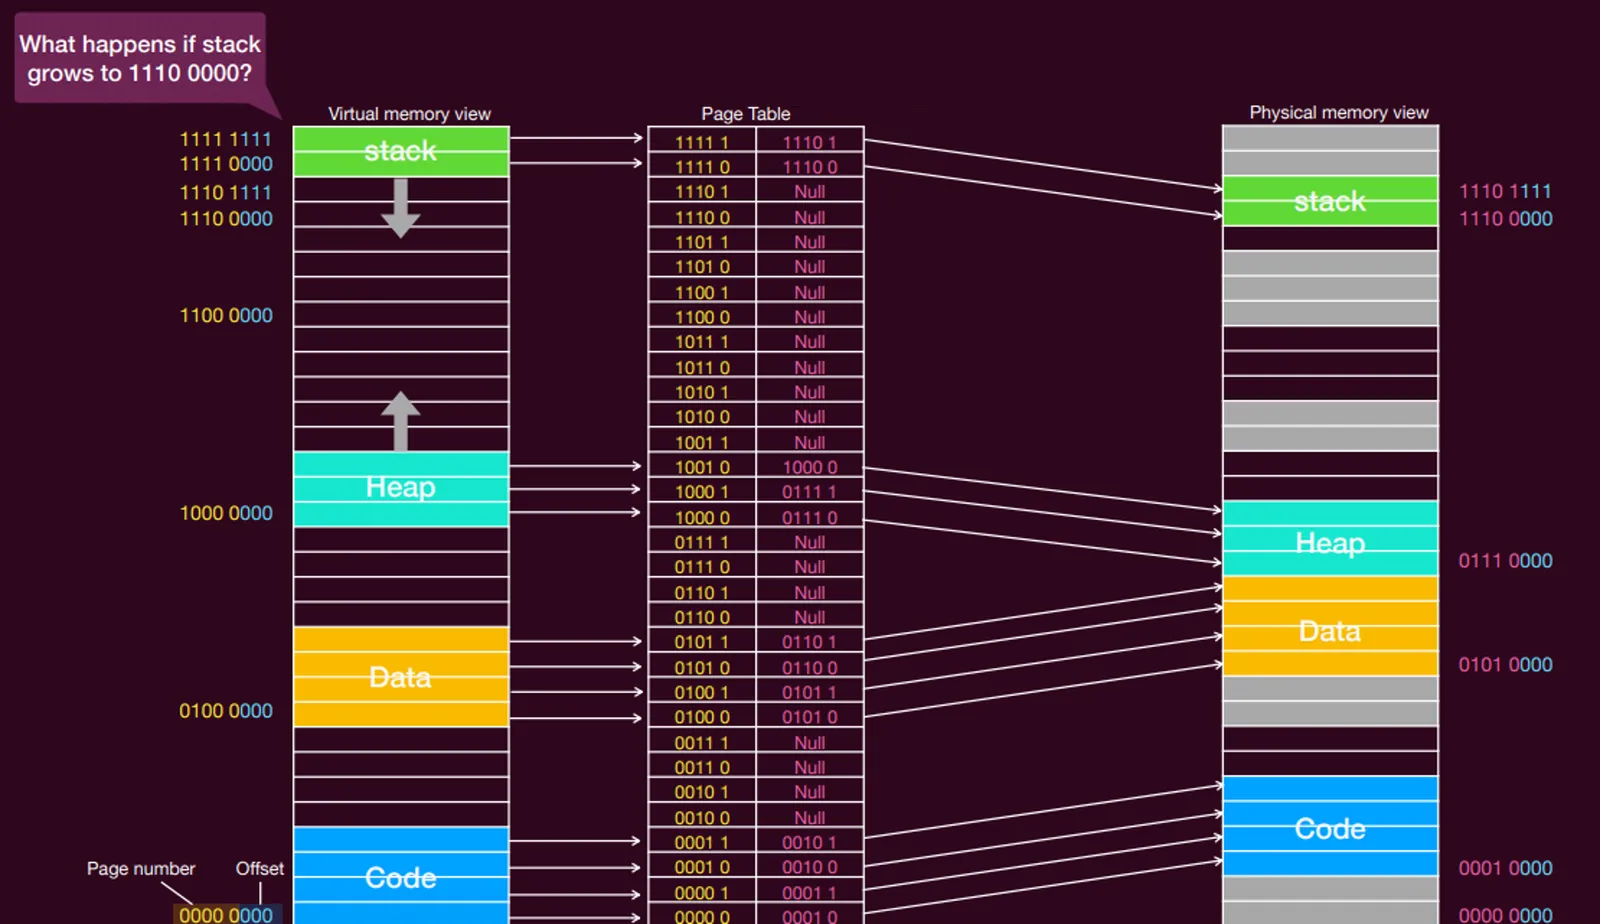
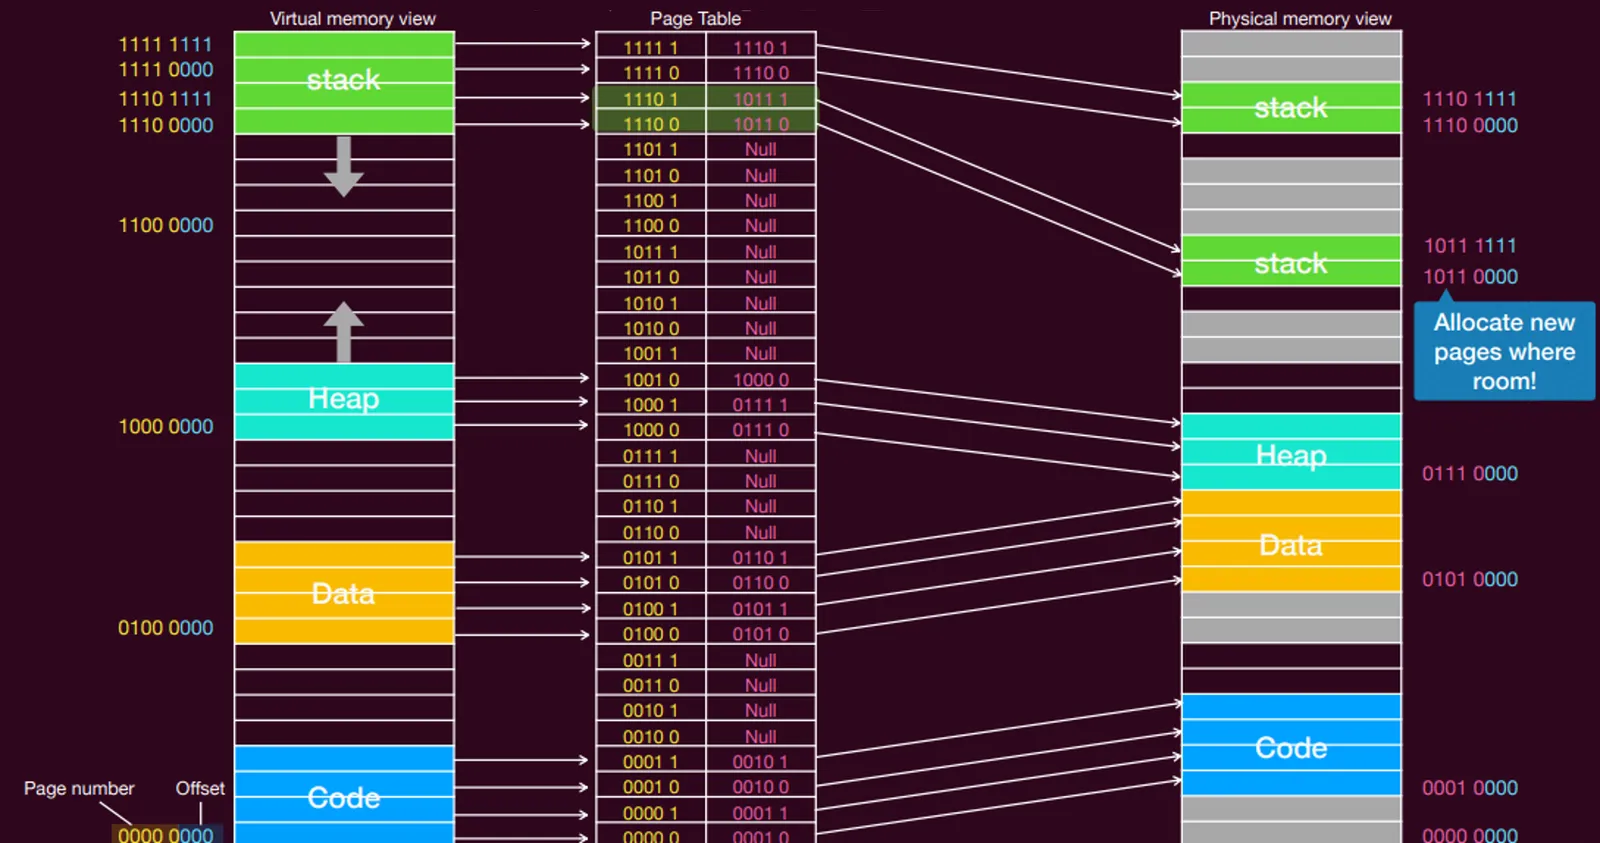
页表使能:CPU 启动流程,上电后默认进入物理寻址模式,系统软件配置控制寄存器,使能页表,进入虚拟寻址模式
4.2 页表
页表最简单的形式称为线性页表,存储在物理内存中
- 页表项(PTE)的具体布局高度依赖于机器
- 需要足够的位来标识物理页
- 应包括一些控制位
页表项中的常见控制位:
- 有效位:转换是否有效(某些地址需保留)
- 存在位:页面是否实际存储在内存中
- 保护位:页面是否可以被读取、写入或执行
- 引用位:页面是否已被访问(内存紧张切磁盘)
- 脏(修改)位:页面自被载入内存以来是否已被修改(从磁盘调出,修改了内存,需写回磁盘)
4.3 支持共享
共享相同的物理页面:在两个页表中的条目指向相同的页帧(带有某些保护位)
fork()通过完全复制父进程来创建一个新进程- 父进程和子进程是相同的,除了
fork的返回值(共享大量内存) - 复制父进程的页表
- 所有共享的页面都标记为 “只读”
- 如果任何一方修改了页面中的数据,就会引发异常,并创建该页面的完整内存副本
4.4 多级页表
若使用单级页表结构,一个页表有多大?
- 32 位地址空间,页 4K,页表项 4B,
- 页表大小: \(\displaystyle \frac{2^{32}}{4K} \times 4 = 4\text{MB}\)
- 64 位地址空间,页 4K,页表项 8B,
- 页表大小: \(\displaystyle \frac{2^{64}}{4K} \times 8 = 33,554,432\ \text{GB}\)
这还只是一个进程的页表
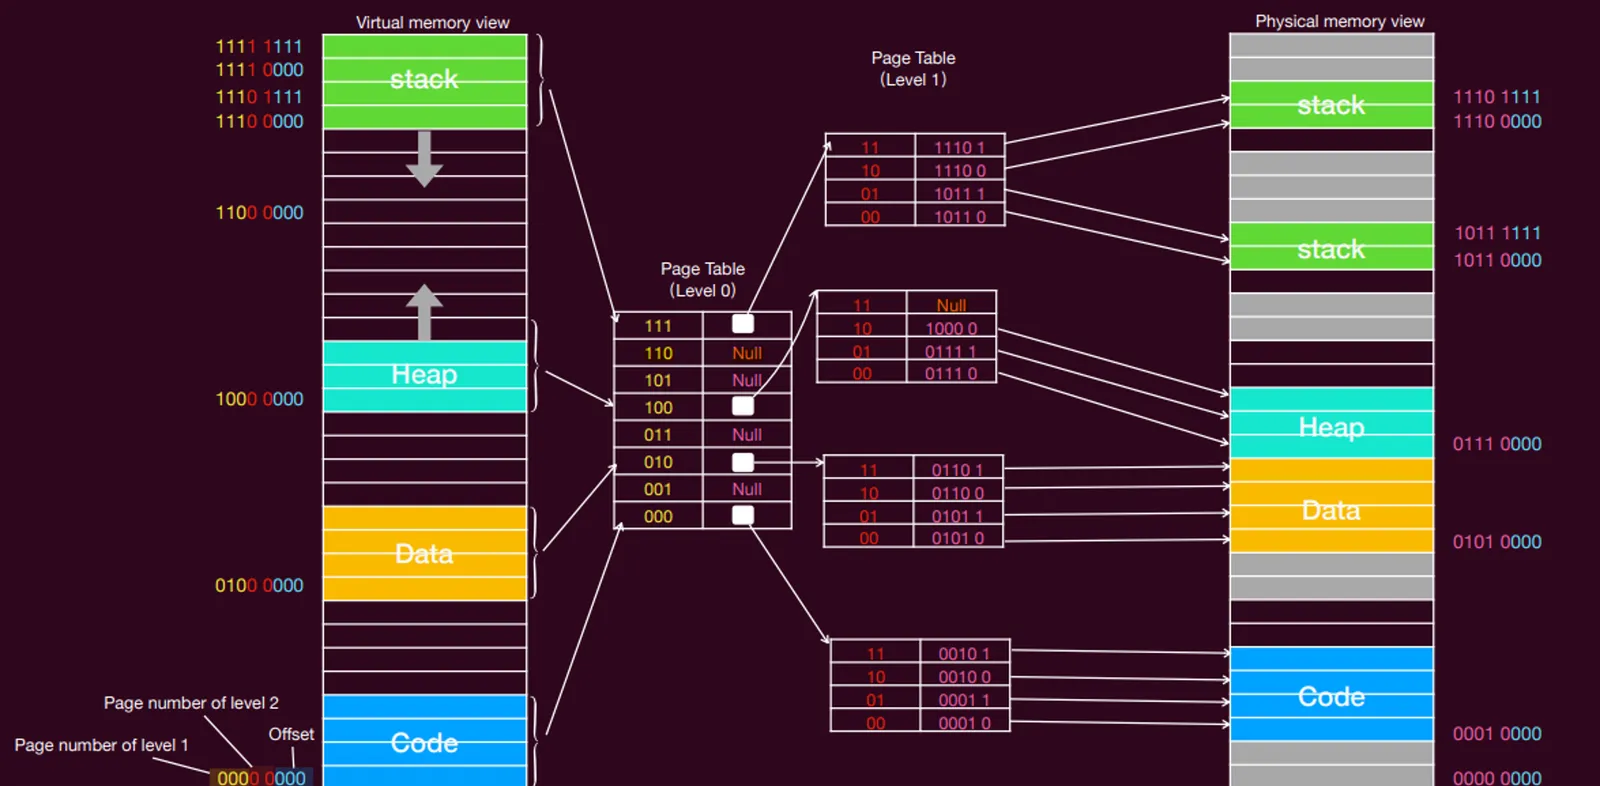
使用多级页表减少空间占用
- 若某级页表中的某条目为空,那么对应的下一级页表无需存在
- 实际应用的虚拟地址空间大部分都未被使用,因此无需分配页表
4.5 倒排页表*
- 每级页表有若干离散的页表页
- 每个页表页占用一个物理页
- 第 0 级(顶层)页表有且仅有一个页表页
- 页表基地址寄存器(TTBR)存储的就是该页的物理地址
- 每项为 8 个字节
- 即总共 4096/8 = 512 项,用于存储物理地址和权限
- 可以不只是两级的页表
一个问题是:太多虚拟页了!而物理页是少的!
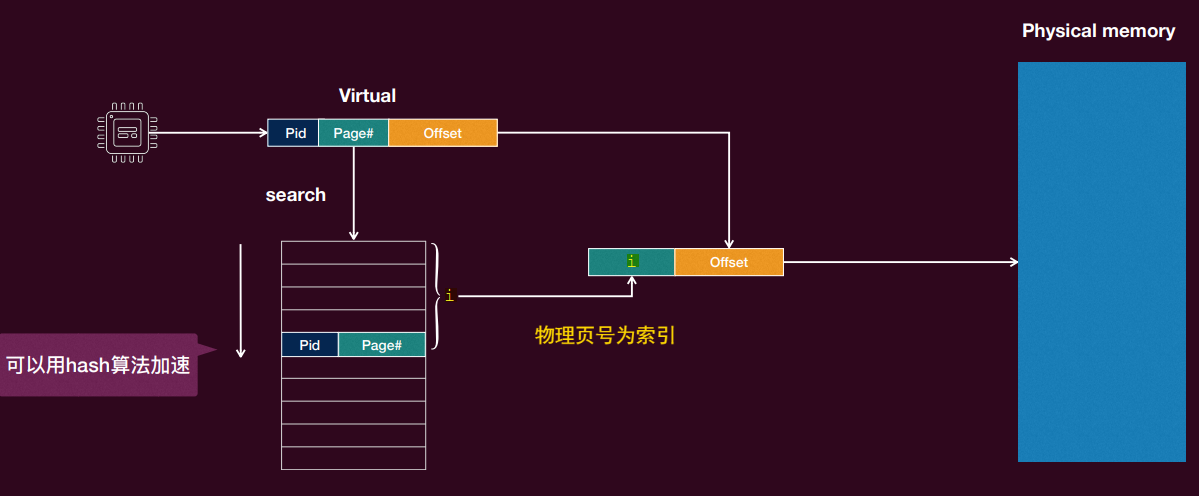
解决方案:倒排页表,不再为每个进程分别维护多个页表,而是保留一个单一的页表,每个物理页对应一个条目(物理页映射回虚拟页)
- 每个页表条目包括:
- 使用该物理页的进程(Pid)
- 该进程的哪个虚拟页映射到该物理页
- 减少了存储页表所需的内存,但增加了在发生页引用时查找表所需的时间
- 使用哈希表来加速查找
- 此外一个问题就是无法共享(哈希冲突)
| 方法 | 优点 | 缺点 |
|---|---|---|
| 分段 | 快速上下文切换(段映射由CPU维护) | 外部碎片 |
| 单级页表 | 无外部碎片 快速且易于分配 | 表的规模巨大,内部碎片 |
| 多级页表 | 表大小约为虚拟内存中的需要用的页面数量 快速且易于分配 | 每次页面访问涉及多次内存引用 |
| 倒排页表 | 表大小约为物理内存中的页面数量 | 需要复杂的哈希函数,页表没有缓存局部性 |
段页:虚拟地址 = 段号 + 虚拟页号 + 偏移,段号定位段表以得到 Base、Bound,页逻辑同上
(多级)页表不是完美的
- 多级页表的设计是典型的用时间换空间的设计
- 增加了访存次数(逐级查询,级数越多越慢)
- 即使是单级页表,也需要访存两次才能真正得到物理内存上的数据
4.6 TLB:地址转换旁路缓冲
TLB 应用了局部性原理
- 缓存最近地址转换
- 如果 TLB 命中,直接应用转换(fast path)
- 如果 TLB 未命中,则在页表中查找映射(页表遍历),并更新 TLB(slow path)
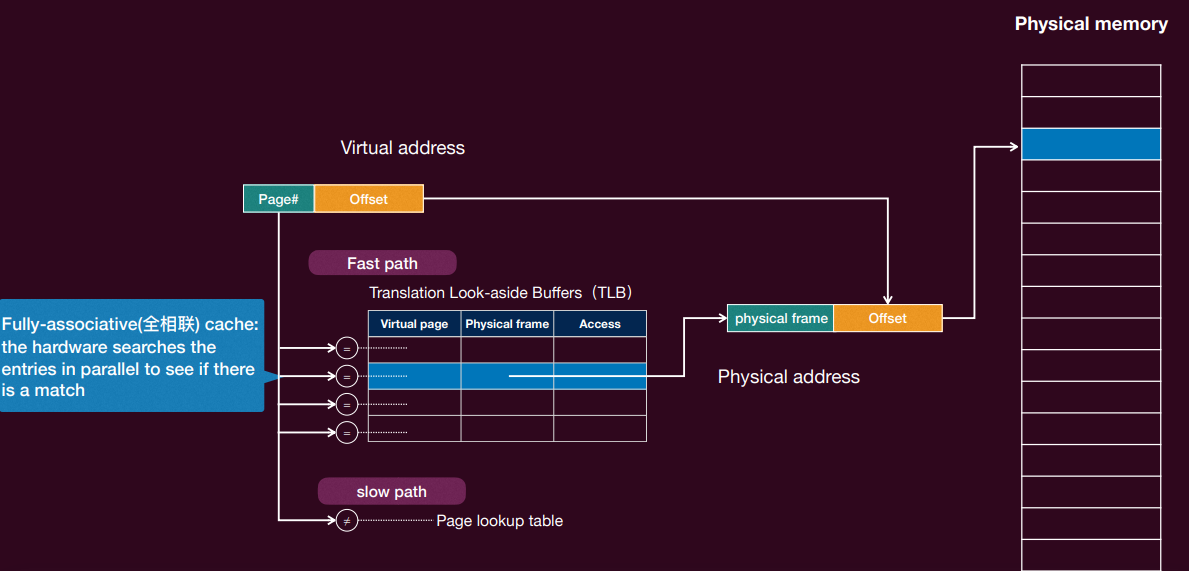
一个典型的 TLB 缓存的项包括
- 页号及其对应的帧号
- 有效位:条目是否有有效的转换
- 保护位:页面的访问方式
- 脏(修改)位:页面是否已被修改
- TLB:进程上下文切换时,旧进程的虚拟地址映射对新进程无效,会清空 TLB,将其所有条目的有效位置 0
- 页表项:表示是否已经被真正加载到了内存中,若 0 则缺页异常
TLB 通常很小,包含 64 到 1024 个条目
- 存储最可能被多的选中的地址翻译才能高效发挥 TLB 的作用
- 支持某些条目可以固定下来以便永久快速访问
有效访问时间(EAT):
- 命中率(\(\alpha\)):在 TLB 中找到页号的百分比
- 内存访问时间(\(t\))
- TLB 查找时间(\(\varepsilon\))
处理 TLB Miss
在 TLB 缺失时,值被加载到 TLB 中,以便下次更快地访问
但如果 TLB 已满,应该替换谁呢?
- 先来先出
- 最近最少用(LRU)
- 随机
谁来处理 TLB miss?
- 硬件处理:当 TLB 缺失时,硬件进行页面遍历,获取页表项,并将其插入 TLB
- 硬件必须确切地知道页表在内存中的位置,以及它们的确切格式
- 更加迅速,对系统软件透明地完成
- 软件处理:当 TLB 缺失时,硬件会引发异常,操作系统内部的代码处理 TLB 缺失
- 更加灵活(如可以定制替换策略)
TLB 一致性
上下文切换时,旧进程的虚拟到物理地址的转换不再有效,否则就会出现同样的虚拟地址映射到不同物理地址的问题,解决方案有两种:
- 清空 TLB:简单地将所有有效位设置为 0
- 带标记的 TLB:在每个 TLB 条目中添加一个地址空间标识符(ASID)字段,该字段唯一地标识每个进程,为该进程提供地址空间保护
- 有效位也依然置 0,只是不用清除这个页表项,待该进程切回时有效位重新置 1
4.7 交换*
当没有足够的空间时,一个进程可以被暂时换出内存到磁盘,然后在需要继续执行时再换回内存
进程的总物理内存空间可以超过物理内存
- 交换时间的主要部分是磁盘传输时间
- 交换会对正在等待 I/O 操作的进程产生负面影响
- 一般设计 I/O 操作的页需要被锁定在内存中,防止操作完成前被换出
- 交换通常是禁用的,分配的内存超过阈值才会启动,低于后又禁用
如果单个进程本身超过物理内存,只要 “活跃” 的占用内存量适合物理内存即可
- 每个进程都有一个大地址空间的幻觉
- 支持多个并发运行的进程使用大虚拟地址空间:只将常用的页面保留在内存中
- 具备 “部分” 加载程序的执行能力
- 程序不再受物理内存限制(可以运行无法完全放入物理内存的程序)
- 每个程序在运行时占用更少的内存(可以同时运行更多的程序)
- 加载或交换程序到内存中所需的 I/O 更少(每个程序启动更快)
- 使用页表项的存在位来跟踪哪些页面存在于物理内存中
- 当程序引用其地址空间的一部分时:
- 如果页面在物理内存中,则直接进行地址转换
- 如果不在,则发生缺页异常,操作系统被调用来处理该异常
- 检测并将页面加载到内存中,然后重新执行指令(引用该地址空间的指令)
5 缺页异常
5.1 具体流程
CPU 控制流传递、提前注册缺页异常处理函数
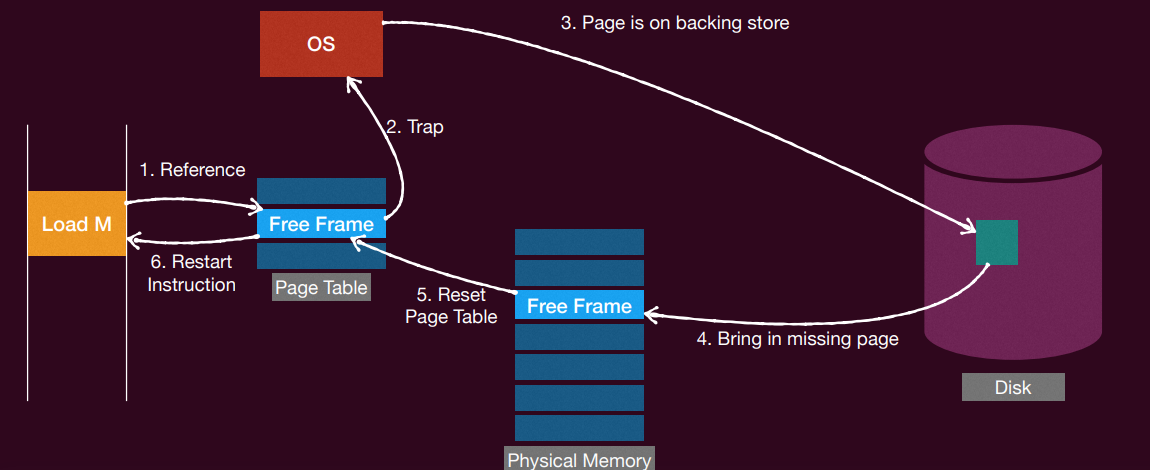
- 硬件陷入内核,进行上下文切换
- 将程序计数器保存在栈上,保存通用寄存器和其他易失性信息
- 系统发现缺页异常事件,尝试确定所需的虚拟页面
- 一旦知道引发缺页异常的虚拟地址,系统检查地址是否有效,并且保护是否与访问一致
- 找到一个空闲帧
- 如果没有空闲帧,则运行页面置换以选择一个受害者
- 如果所选帧是脏的,则将页面安排转移到磁盘,进行上下文切换,暂停引发异常的进程
- 一旦帧变为干净状态,系统查找所需页面的磁盘地址,并安排磁盘操作将其调入(引发缺页异常的进程仍处于暂停状态)
- 当磁盘中断指示页面已经到达时,更新页表,并将帧标记为正常状态
- 将引发缺页异常的指令恢复到其原始状态,并重置程序计数器
- 引发缺页异常的进程被调度,上下文切换回去
5.2 性能
处理缺页异常的三个主要活动:
- 服务中断:一般只需要几百条指令
- 读取页面:需要大量时间
- 恢复进程:需要少量时间
缺页错误率(\(0 \le p \le 1\)) 有效访问时间 \(\text{EAT}=(1 - p) \times\) 访存时间 \(+\ p\ \times\) 缺页异常开销
- 内存访问时间 = 200 ns
- 平均缺页异常服务时间 = 8 ms
- \(\text{EAT} = (1 - p) \times 200 + p \times 8,000,000 = 200 + p \times 7,999,800 \text{ ns}\)
- 如果 1,000 次访问中有一次引发缺页异常 (\(p = 0.001\)),那么 \(\text{EAT} = 8200 \text{ ns}\)(减速了 40 倍)
- 如果想要性能降级 < 10%
- \((1-p) \times 200 + p \times 7,999,800 < 220\)
- \(p < 0.0000025\)(每 400,000 次内存访问中不到一次缺页异常)
除了作为构建虚拟内存的一个机制外,缺页异常还有其他巧妙用法
- Copy-On-Write:写时复制
- Zero-filled-on-Demand:按需零填充
- memory-mapped files:内存映射文件
5.3 按需零填充
非常特殊的写时复制情况
许多进程页是 “空白” 的:
- 所有的 bss(通常是指用来存放程序中未初始化的全局变量的一块内存区域)
- 新的堆页面
- 新的栈页面
按需零填充实现:
- 有一个系统范围内的全零帧
- 所有的全 0 页帧都指向它
- 标记为只读
- 读取零是自由的
- 但写入会导致缺页错误以及克隆操作
5.4 内存映射文件
将文件内容映射到进程的地址空间的机制。通过内存映射文件,可以将文件视为一块内存区域,而不需要显式地使用 read() 和 write() 的接口 mmap()
- 当进程访问映射区域时,如果所访问的页面尚未在内存中,则会发生页面错误。此时,操作系统会将相应的文件内容
read()到内存中,以满足进程的访问请求 - 进程对映射区域的写操作会导致页面被标记为脏页,并在必要时通过
write()系统调用将页面内容写回文件 - 如果多个进程使用相同的
mmap()调用映射了相同的文件,它们将共享同一份文件内容,即它们的映射区域指向同一块内存区域,从而实现了共享内存的效果
6 页面置换
- 按需分页 —— 出现缺页异常后进行调入页面
- 最简单的方法
- 为了提高效率,调入是异步进行的:
- 中断处理程序应快速响应,只需启动磁盘 I/O 并阻塞该进程,让其他进程运行
- 预取
- 猜测即将使用哪些页面,因此提前将其调入内存
- 往往是基于历史的缺页记录来预测
- 页面置换:找到内存中的一个页面(一般来说该页面近期最不可能再次被访问),将其换出
- 更新页表:找到所有引用旧页面的页表项(因为帧可以共享),并将每个设置为不可见
- 移除任何 TLB 条目
- 在多处理器系统中,必须从所有处理器的 TLB 中消除 TLB 条目
- 将页面写回磁盘(如果需要,页表项中的脏位)
- 重新启动引发陷阱的指令(需要备份指令)
- 将页面固定到内存中以锁定
- 有时必须将页面锁定到内存中
- 总是将(部分)内核页面放入物理内存中
- 用于从设备复制文件的页面必须锁定,以防止被选择用于驱逐(I/O)
- 低优先级进程交换入一个页面,然后被高优先级进程抢占并请求一个新的页
- 需要小心使用
- 保留一组空闲页(Buffering) 以确保在需要时总有可用的页在合适的时候
此外有一个交换页面的守护进程(后台进程)定期运行(类似于调度程序)
- 如果空闲物理帧的数量 < “低水位标记”,则一次性换出一些页面,直到数量达到 “高水位标记”
- 大块数据写入磁盘更有效(批量传输)
- 需要维护一个修改页面的列表,将页面写入其中并设置为非脏
- 页面交换的守护进程可以以低优先级调度
- 利用空闲时间准备未来的工作
- 页面置换策略,目标是实现最低的缺页异常率(尽量减少从磁盘获取页面的次数)
- 如果选择一个不常被使用的页面,系统性能会更好
- 如果删除一个频繁使用的页面,它可能很快就需要被重新调入
6.1 先进先出(FIFO)
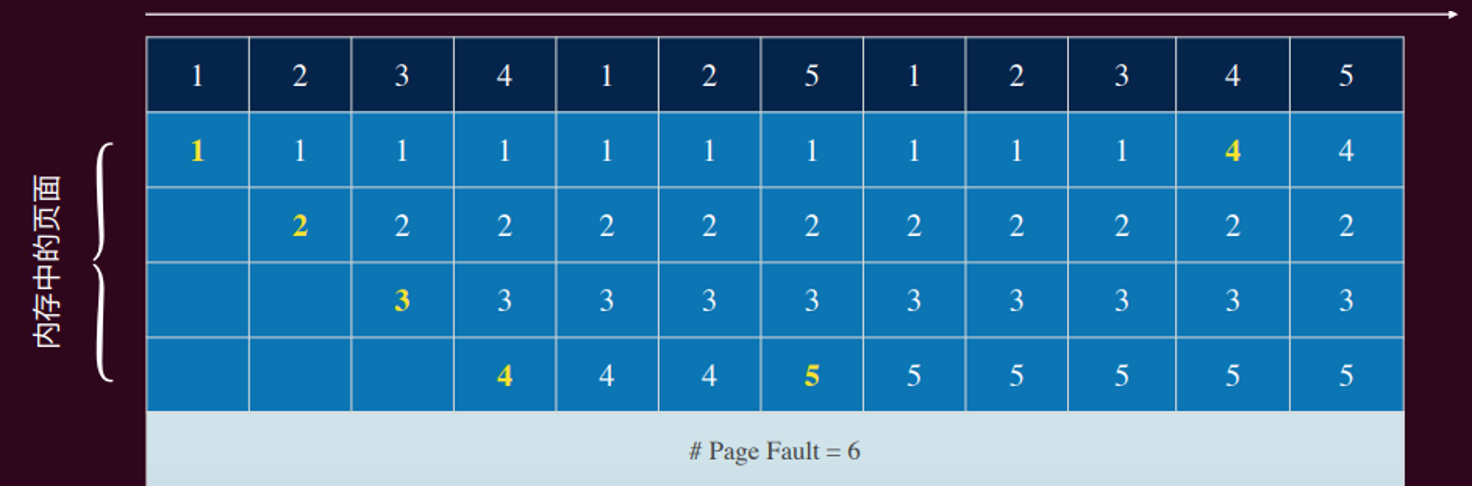
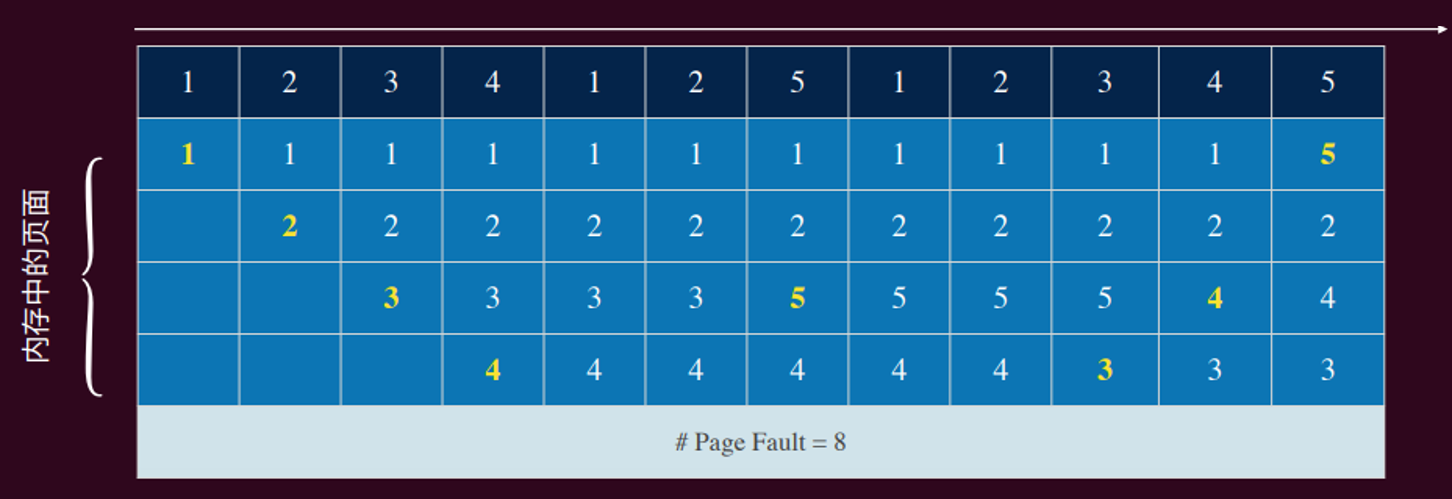
替换最老的页面,使用一个 FIFO 队列来跟踪页面的老化程度
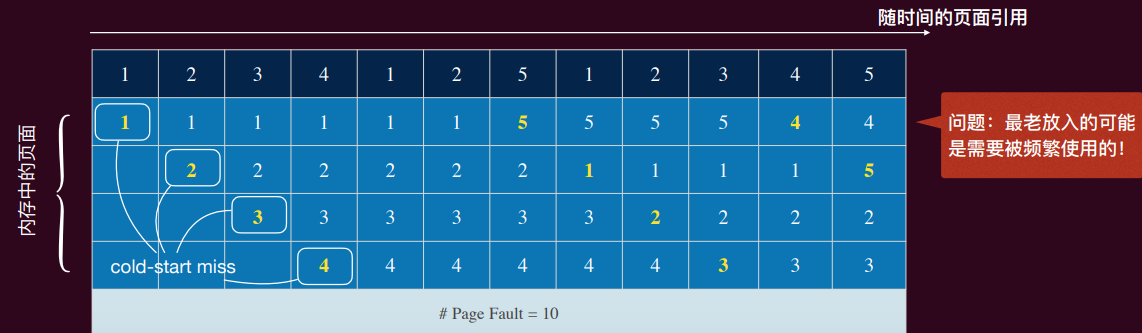
Belady 异常:增加帧数反而可能会降低命中率(帧数越少,缺页异常越少)
- 给定 4 个帧,有 10 个缺页异常;给定 3 个帧,有 9 个缺页异常
Belady 异常会发生在任何页面替换算法中(比如随机替换),只要它不遵循 “栈算法” 属性
栈算法属性:当页面帧数量增加时,先前存在的页面集合始终是当页面帧更多时存在的页面集合的子集
- 换句话说,随着页面帧数的增加,先前存在的页面应始终保留在内存中
- 没有这个性质,增加页面数导致删除先前在内存中被频繁使用的页面
6.2 最佳算法
替换在最长时间内不会被使用的页面
- 但这个方法只存在理想中,无法预知未来
- 因此通常用于衡量算法的性能(和最优的差距有多大)
6.3 最近最少用(LRU)
替换那些在最长时间内没有被使用的页面
- 使用历史而不是未来:很长时间没有被使用的页面可能会保持长时间未使用
- 基于局部性原理
使用计数器跟踪页面最近最少被使用
- 每个页面都有一个对应的计数器项
- 每次页面被引用时,通过硬件将时钟寄存器的值复制到计数器中
- 当需要更换页面时,查看计数器以找到最小的值
开销太大
6.4 二次机会算法
通过引用位来近似 LRU:寻找一个在最近的时钟周期内没有被引用的老页面
- 系统中每个页面有一个引用位(R)
- 每当引用页面(即读取或写入),引用位被设置为 1(由硬件完成)
- 如果要被替换的页面:
- R = 1:将引用位设置为 0,将其放在 FIFO 队列的末尾;并检查下一个页面
- R = 0:替换它
- 如果所有页面都被引用,那么第二次机会等于 FIFO
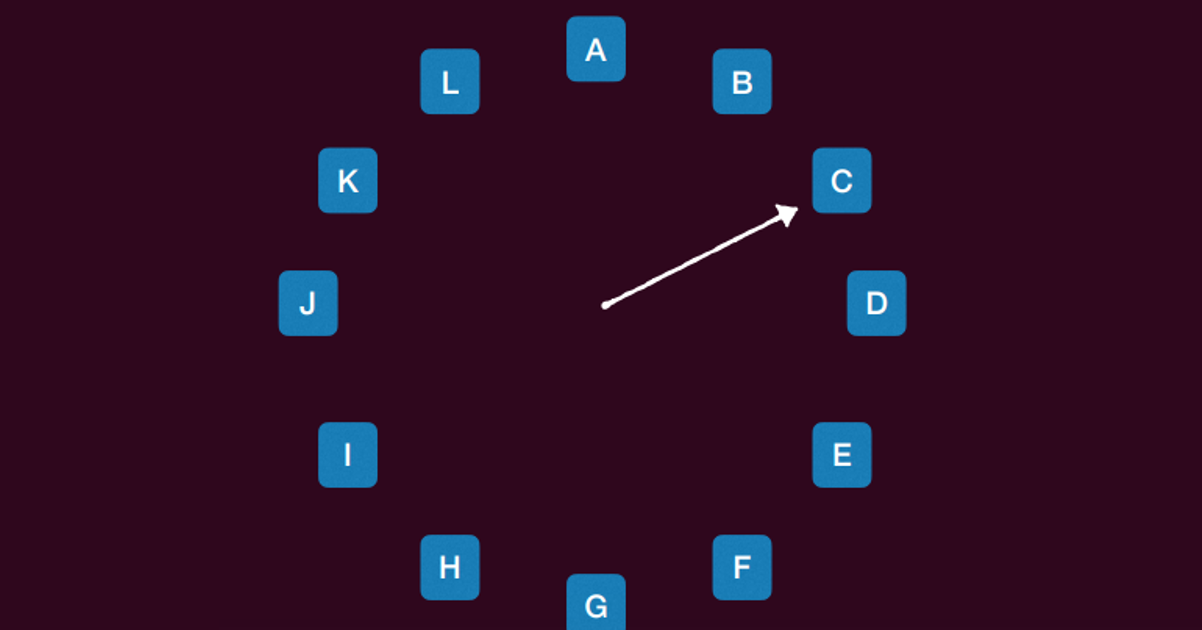
具体实现可以将所有页面帧以时钟形式放在一个循环列表中(避免在队列上移动页面)
- 发生缺页异常时,检查当前指向的页面
- R = 0:驱逐该页面
- R = 1:将 R = 0 并将指针向前移
6.5 最近未使用(NRU)
通过两个状态位(引用位、修改位)来近似 LRU:为那些被修改的页面赋予更高的优先级以减少 I/O 负担(增强的第二次机会)
- (0, 0):既不是最近使用的也没有被修改过(最适合替换)
- (0, 1):不是最近使用的但被修改过(不太理想,需要在替换前写出)
- (1, 0):最近被使用但是干净的(但可能会很快再次被使用)
- (1, 1):最近被使用且被修改过(可能会很快再次被使用,并且需要在替换前写出)
从最低编号的非空类中随机移除一个页面(可能需要多次在循环队列中搜索)
6.6 抖动
一个进程花费所有时间在页面间进行交换(大多数引用导致缺页异常)
- 如果一个进程没有足够的页面,缺页率可能会非常高
- 此时大部分 CPU 时间都被用来处理缺页异常
- 等待缓慢的磁盘 I/O 操作
- 调度器甚至还会造成问题加剧
- 等待磁盘 I/O 导致 CPU 利用率下降
- 调度器载入更多的进程以期提高 CPU 利用率
- 本来物理页面就不足的局面 “雪上加霜”
- 触发更多的缺页异常、进一步降低 CPU 利用率、导致连锁反应
6.7 工作集模型
- 相同的内存位置在不久的将来会再次被访问
- 未来将会访问附近的内存位置
工作集(Working Set):
- 其在时间段 \((t-x, t)\) 内使用的内存页集合也被视为其在未来(下一个 \(x\) 时间内)会访问的页集
- 如果整个工作集都在内存中,那么进程将运行而不会引起太多缺页异常,直到它进入另一个执行阶段
- 如果可用内存太小,无法容纳整个工作集,则会发生抖动
All-or-nothing 模型:
- 进程工作集要不都在内存中,否则全都换出
- 需要跟踪每个进程的工作集,并确保在运行之前将其加载到内存中。
- 大大降低缺页异常率
跟踪工作集 \(w(t, x)\):工作集时钟中断固定间隔发生,处理函数扫描内存页
- 访问位为 1,说明在此次 tick 中被访问,记录上次使用时间为当前时间
- 访问位为 0,则此次 tick 中未访问
- Age = 当前时间 – 上次使用时间
- 若 Age 大于设置的 x,则替换出工作集
- 将所有访问位清 0
- 注意访问位需要硬件支持
替换页帧是全局(从所有进程中选择)还是本地(只挑自己的页帧)?
本地页面置换:每个进程从其分配的帧集中选择受害者
- 每个进程的帧数固定分配
- 每个进程的性能更加一致
- 但可能导致内存利用不足
全局页面置换:从分配给任何进程的帧中选择受害者
- 每个进程的帧数可变
- 吞吐量更大,因此更为普遍
采用全局页面置换时,操作系统必须不断决定为每个进程分配的页面帧数
- 平均分配:为每个进程分配相等的份额
- 比例分配:根据进程大小进行分配
- 优先级分配
这些静态的帧数分配无法解决不断变化的动态需求
缺页异常频率(PFF)算法用于帧分配
- 缺页异常率 = 每秒平均缺页数
- 分配帧以使进程的 PFF 相等
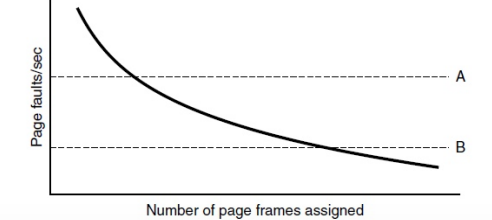
- 如果实际速率太低,则进程丢失帧
- 如果实际速率太高,则进程获得帧
7 分页总结
进程创建:
- 确定程序和数据的大小并创建页表
- 为页表分配空间并初始化
- 为磁盘上的交换区域分配空间并初始化
- 在进程表中记录有关页表和交换空间的信息
进程执行:
- 为新进程重置内存管理单元(页表基址寄存器)
- 上下文切换:清除 TLB(除非它是带有标记的)
- 可选地,将进程的一些或所有页面调入
页面守护进程:
- 大部分时间处于休眠状态,但定期唤醒以检查内存状态,并主动准备待驱逐的页面
缺页异常:
- 找到所需的页,并在磁盘上定位该页
- 找到一个可用的物理页帧来放置新页帧(必要时替换旧页帧)
- 将所需的页面读入该物理页帧
- 备份程序计数器以再次执行指令
进程终止:
- 释放页表、页帧和交换空间
- 共享页帧只能在使用它们的最后一个进程终止时释放
程序优化:应用局部性原理,程序员可进行优化
- 内存的抽象
- 屏蔽物理的局限(无限空间、连续、独享)
- 实现机制:地址翻译
- 需要硬件和 OS 配合
- 底层内存的管理:连续分配、分段、分页
- 利用 TLB 缓存
- 实现虚拟内存的工程问题:
- 换页、工作集
标题:地址空间
作者:Zwing
创建于:2026-08-09 00:08:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/虚拟化-地址空间.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可