
文件系统
让应用程序直接通过驱动访问存储设备,可能破坏系统、磁盘
因此应用程序应该 “有限制” 地访问数据
- 提供合理的 API 使多个应用程序能共享数据
- 提供一定的隔离,使恶意/出错程序的伤害不能任意扩大
这就是文件系统
文件系统是在操作系统内核中实现的持久化存储抽象
- 用户程序通过系统调用(
open/read/write)与文件系统进行交互 - 文件系统负责维护路径、目录、inode、权限、空闲空间和文件到磁盘块的映射
- 设备驱动程序负责把文件系统发出的块读写请求转换为具体设备操作
文件系统解决的四个问题:
- 持久性和命名数据:文件和目录
- 存储在系统中直到显式删除为止
- 可以通过文件系统关联的可读标识符访问
- 访问和保护:提供打开、读取、写入和其他操作;调节不同用户对文件的访问
- 磁盘空间管理:公平有效地利用磁盘空间
- 分配空间给文件,并跟踪空闲空间
- 快速访问文件
- 可靠性:不得丢失文件数据
1 文件
文件是操作系统创建的逻辑存储单元,用于存储信息
1.1 文件命名
- 命名是文件系统抽象的一个重要特征
- 提供人类可读的名称来引用任意大小的数据
- 帮助用户组织大量的存储空间
- 信息存储的细节(低级结构)以及磁盘的实际工作方式被屏蔽了
1.2 文件类型
- 普通文件(‘-’):用于存储实际的用户信息
- 目录(‘d’):用于维护文件系统结构的系统文件
- 符号链接文件(‘l’)
- 命名管道文件或简称管道文件(‘p’)
- 块文件(‘b’)
- 字符设备文件(‘c’)
- 套接字文件(‘s’)
1.3 文件元数据
除了文件的名称和数据外,操作系统还会保留文件的额外信息:
- 数据块位置(文件对应哪些磁盘块)
- 大小:文件的大小(当前大小或最大大小)
- 时间:文件的创建时间、最近访问时间和最近修改时间
- 所有者:文件的当前所有者
- 保护信息
- 链接信息
文件系统将 文件元数据保存在文件控制块:
- 存储在磁盘上,并且缓存在内存中以加快访问速度
- 在 UNIX 中,这个 文件控制块就是 inode(index node)
1.4 文件访问
- 顺序访问:按顺序读取或写入数据
- 速度快(可以达到磁盘的峰值传输速率)
- 随机(直接)访问:随机寻址任意块
- 读取[n] 写入[n] 寻址[n]
- 文件操作包括块号作为参数
- 速度慢(寻址时间和旋转延迟)
1.5 文件的常见 API
分别对应了系统调用
open(create):打开(或创建)具有给定路径(目录和名称)的文件,并将文件指针设置为文件的开头read:从打开的文件中读取最多一定数量的字节,并为下一次读取移动文件指针write:将字节数组写入打开的文件(并移动指针)close:关闭打开的文件lseek:移动文件指针到文件中的某个索引处fsync:立即将更改推送到磁盘(刷新脏数据)
1.6 文件描述符
文件描述符(句柄):操作系统分配给一个进程打开的文件的一个唯一数字(每个进程私有),用于引用该文件
- 持有该文件描述符,可以对对应的文件执行特定操作
- 避免在每次访问时解析文件名(在目录中搜索文件名)和检查权限
- 一个文件可以以不同方式多次打开
在 Unix 系统中,一切皆是文件(字节流)
1.7 文件偏移
对于进程打开的每个文件,操作系统都会跟踪一个文件偏移量,该偏移量决定下一次读取或写入将从何处开始
- 隐式更新:当进行 N 字节的读取或写入时,N 会被添加到当前偏移量
- 显式更新:使用
lseek()函数
1.8 打开文件表
打开文件表:存储关于进程打开文件的信息
- 每个进程都维护一个打开文件表
- 一个由文件描述符索引的数组
- 表中的每个条目跟踪文件描述符所引用的底层文件,当前偏移量以及其他相关细节
多个进程可能同时打开同一个文件
- 每个进程都有自己的打开文件表:跟踪进程打开的所有文件
- 系统范围的打开文件表:跟踪与进程无关的信息(如文件属性,大小和位置)
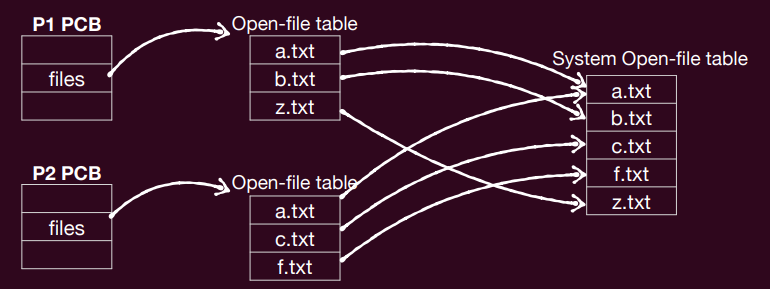
- 要打开一个文件,搜索系统范围的打开文件表,以查看文件当前是否正在使用
- 如果没有,搜索目录以查找文件名,并在系统范围的打开文件表中添加一个条目
- 在属于进程的打开文件表中创建一个打开文件的条目,并指向系统的打开文件表
- 增加系统的打开文件表中的打开计数
- 只有当所有进程关闭文件(或退出)时,才可以删除表条目
- 返回指向每个进程打开文件表中条目的指针(文件描述符)
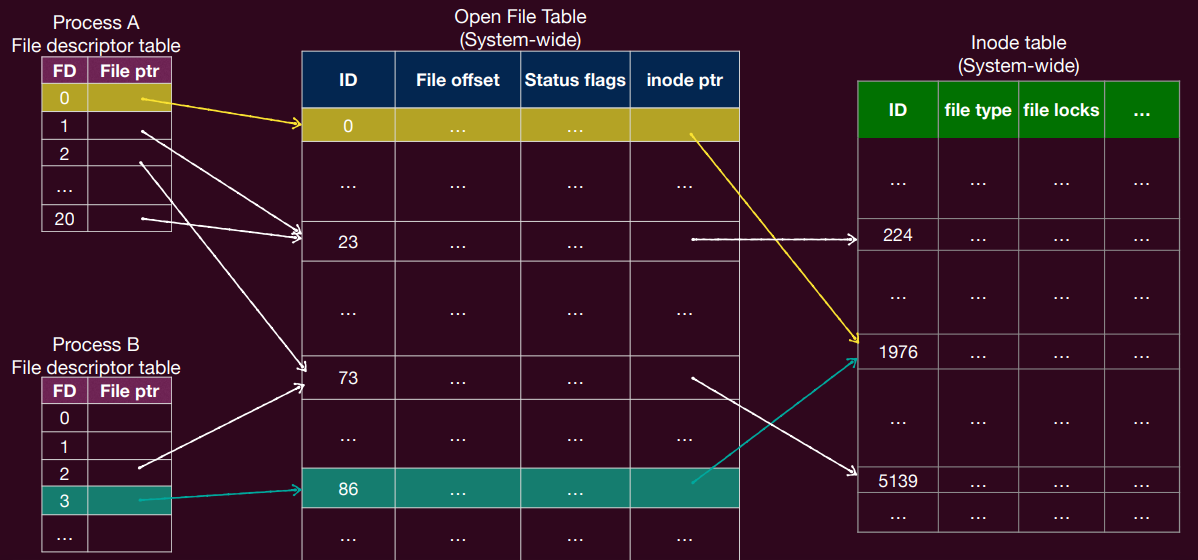
- 文件描述符表(每个进程):为进程打开的每个文件描述符创建一个条目
- 指向打开文件表的指针
- 打开文件表(系统范围):为每个打开的文件创建一个条目
- 文件偏移量、访问模式、与文件打开相关的标志
- 指向 inode 的指针
- inode 表(系统范围):为每个 inode 点创建一个条目
- 文件属性(类型、大小、权限、时间戳等)
- 两个进程打开相同文件
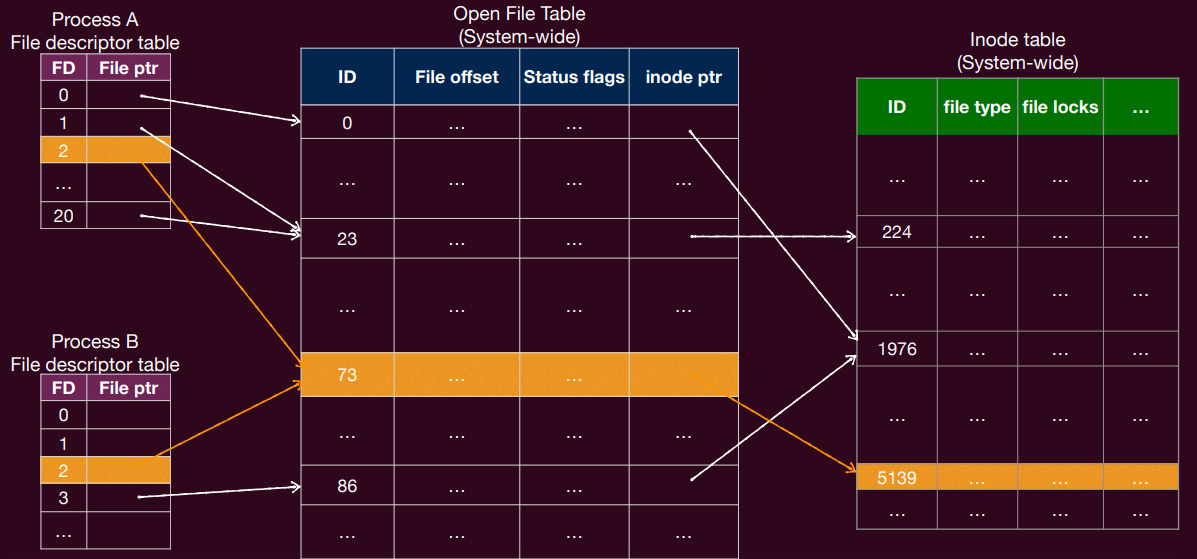
- 两个进程可以指向同一个全局的打开项(如
fork)
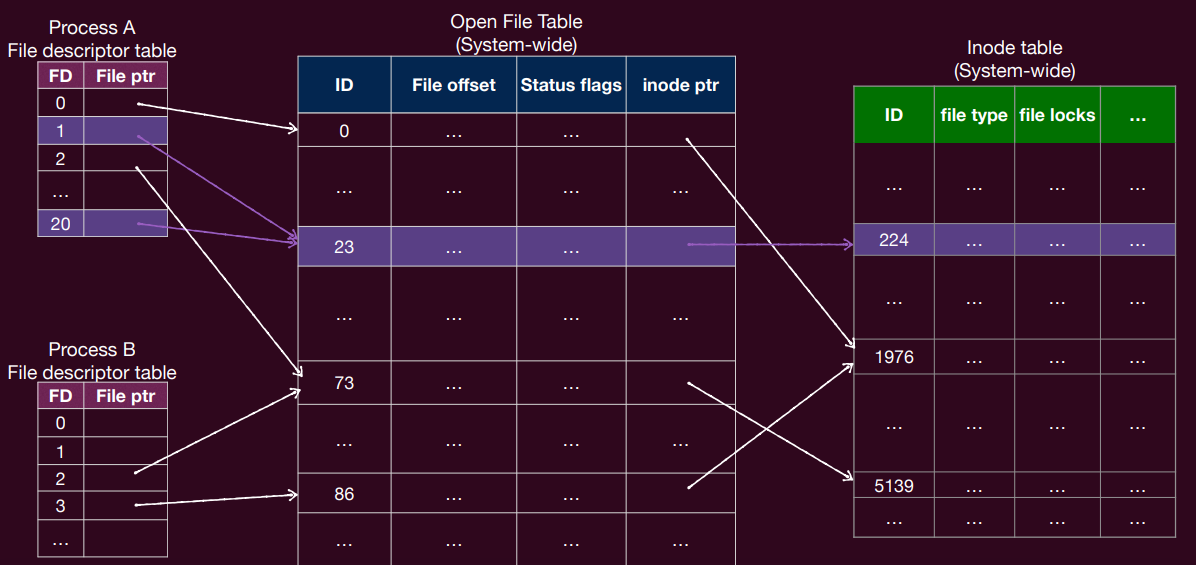
- 一个进程可以有多个指向同一个打开项的文件描述符(Dup)
2 目录
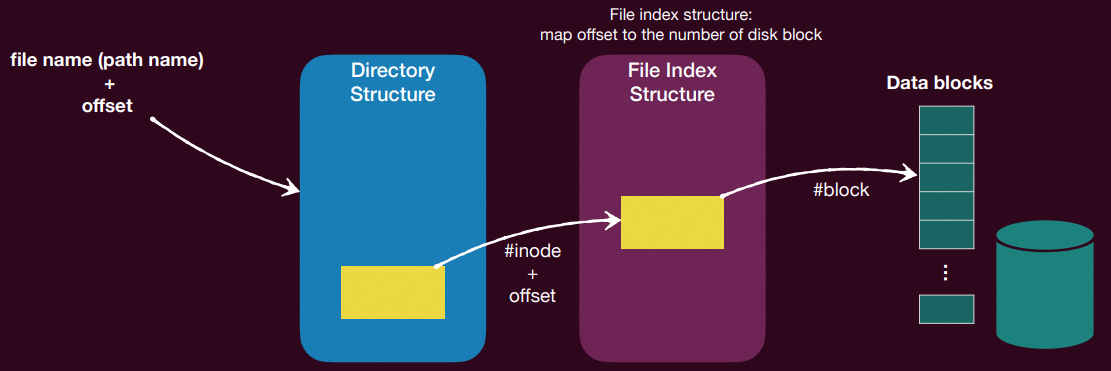
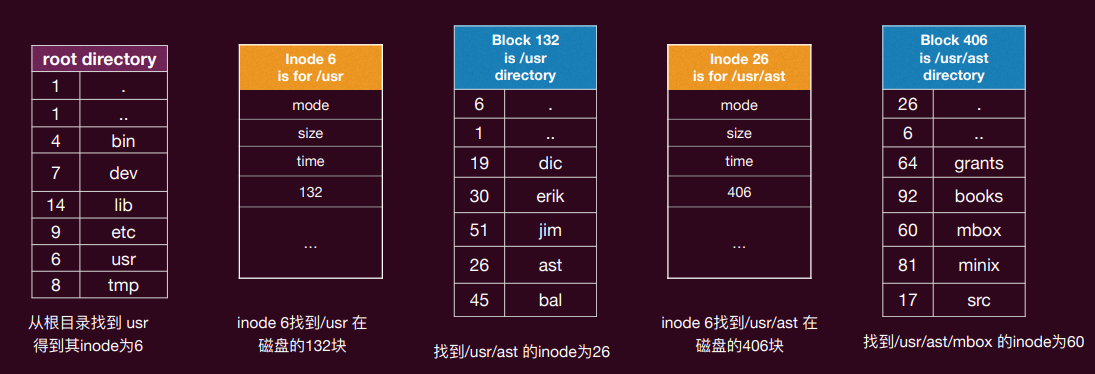
目录存储了文件名与文件控制块 inode 之间的映射
- 在 Unix 中,每个目录条目只是一个
<文件名,inode 号>对 - 目录被存储为一个文件
- 要查找一个文件,需要找到包含该映射的目录
- 根目录是特别的:需要为根目录分配一个固定的 inode 号
- 寻找 /usr/ast/mbox 的步骤
create: 创建一个目录(除了.和..之外是空的)delete: 删除一个目录(仅在目录为空时)opendir: 可以读取目录(例如,列出所有文件)closedir: 释放内部表空间readdir: 返回打开目录中的下一个条目rename: 更改目录的名称link: 从现有文件创建一个链接(硬链接)到路径名(允许文件出现在多个目录中)unlink: 删除一个目录条目(在 Unix 中删除文件)
目录的格式通常被视为文件系统的元数据,文件系统认为自己有责任维护目录数据的完整性。因此,用户只能通过在目录中创建文件、目录或其他对象类型来间接更新目录
通过将一个新文件名链接到一个旧文件名,可以创建另一种引用同一文件的方式
- 可以为同一个文件创建多个不同的名称
- 目录结构变成一个有向无环图
- 有两种链接
- 硬链接
- 符号链接 或 软链接
2.1 硬链接
硬链接:在目录中创建另一个名称,并将其指向原始文件的相同 inode 号
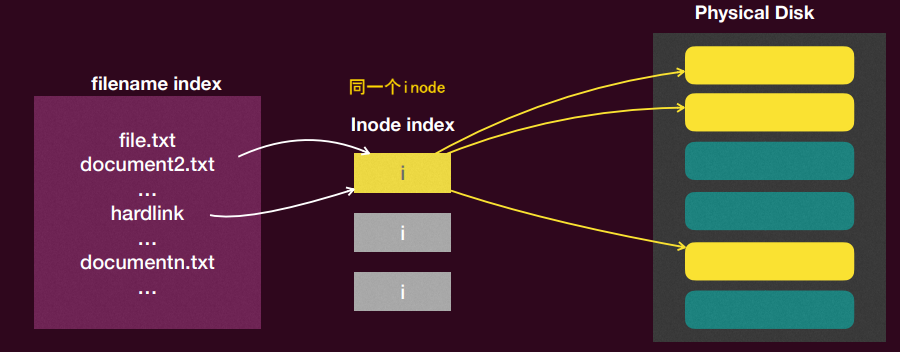
文件没有被复制;只是有两个名称(两个绝对路径)都指向同一个文件
- 硬链接本质上是 inode 号的别名
- 当创建一个文件时,
- 首先,创建一个结构(inode),该结构将跟踪关于文件的所有相关信息
- 其次,将一个人类可读的名称链接到该文件,并将该链接放入目录中
- 要从文件系统中删除文件,调用
unlink()- 每个 inode 有一个引用计数(链接计数器)
- 删除链接时,引用计数减一;如果计数达到 0,目标文件将被删除
- 但不能链接到另一个文件系统上的文件
- 因为 inode 号只在一个文件系统内是唯一的
- 不允许链接到目录(简化管理)
- 这防止了在目录层次结构中创建循环
- 避免了父目录的不明确性
2.2 软链接
符号(软)链接:创建一种不同类型的文件(链接类型)
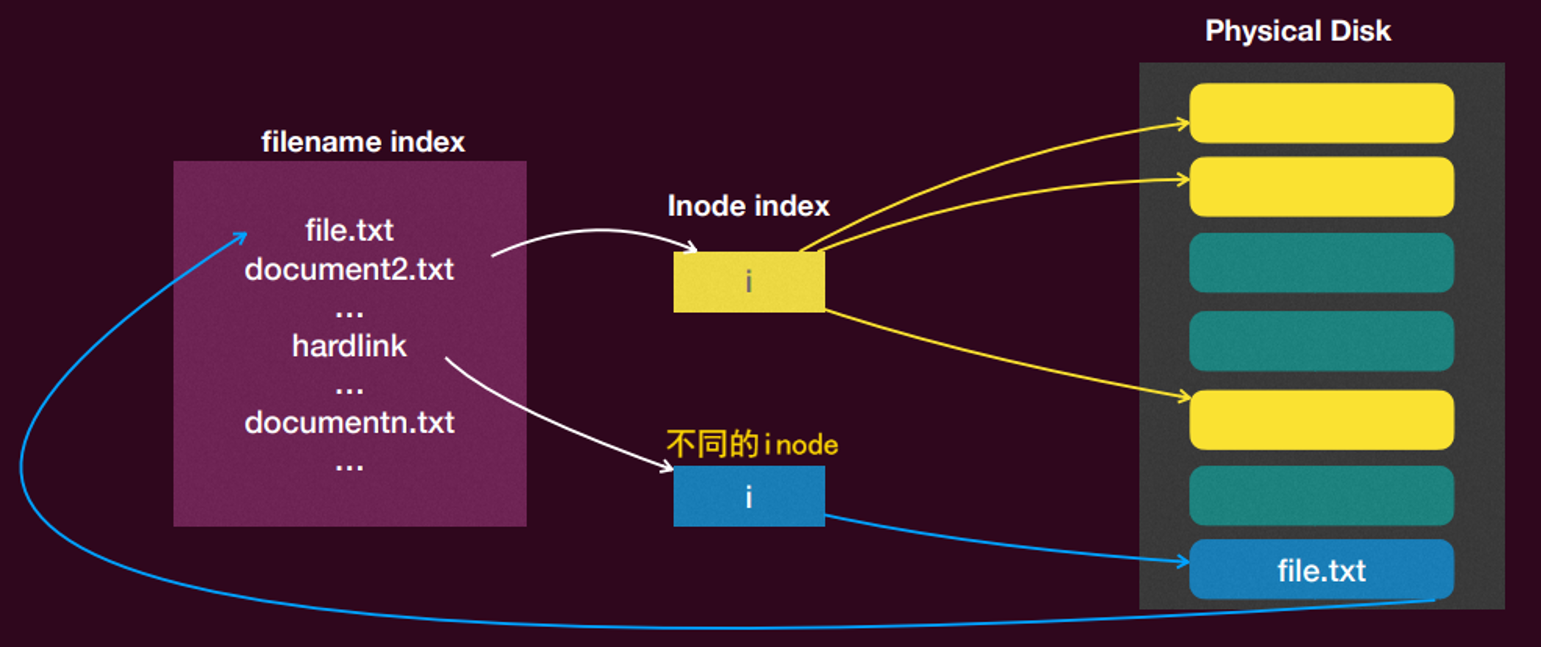
- 符号(软)链接是路径名的别名
- 可以链接到目录,或跨文件系统链接
- 当需要解析路径名时符号链接被解析
- 找到目标文件的名称,并使用新名称打开
- 目标可以是另一个符号链接(递归解析)
- 比硬链接效率低
- 当删除符号链接时,目标文件保持不变
- 当目标文件被删除时,产生引用悬空
2.3 文件保护*
访问权限的类型:
- 对于文件:read / write / execute
- 对于目录:list / modify / delete
- 对于访问权限本身:更改访问权限 / 给予某人访问权限 / 撤销某人的访问权限
访问控制矩阵:编码了系统中每个用户或者用户组的所有访问权限
Unix 中的访问控制:为每个用户分配(用户 ID,组 ID)相应的权限
- ID 与该用户发出的每个操作请求相关联
- 3 个用户类别:所有者、组、其他人
- 3 种访问模式:读取、写入、执行(编码为 3 位)
2.4 文件系统挂载*
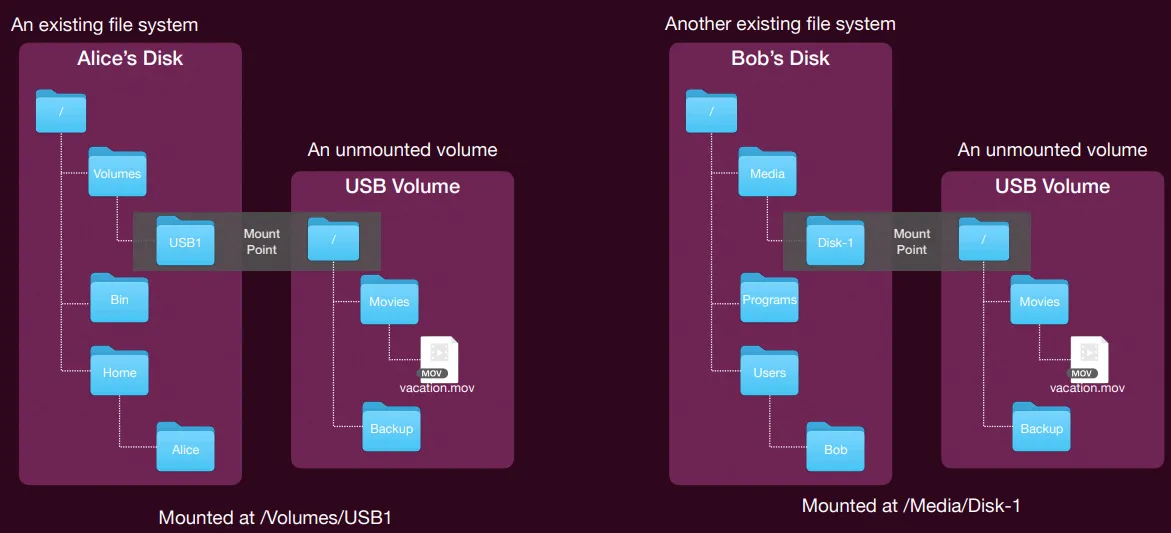
一个文件系统在能被访问之前,必须先进行挂载
- 从现有文件系统中的某个路径(挂载点)创建到挂载文件系统的根目录的映射
- 将多个文件系统统一到一棵树中
mkfs命令可以在块设备上创建一个新的文件系统,mount命令可以在当前文件系统中的某个目录下挂载一个文件系统
3 文件系统实现
3.1 文件系统的布局*
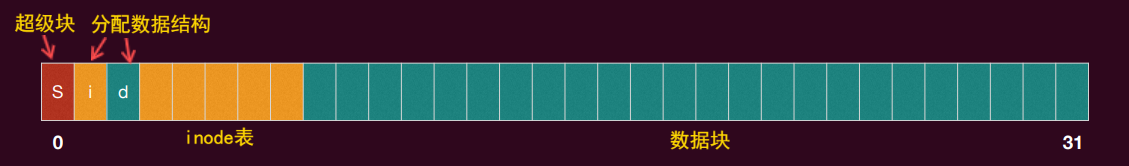
文件系统需要为需要存储的数据维护一个其在磁盘上的数据结构
- 磁盘被分割为等大小的数据块
- 从 0 到 N-1 进行编号
- 数据块: 磁盘保留的一个固定数据块部分用来存储数据本身
- inode 表:每个文件的元信息
- 分配数据结构: 对于已分配和空闲的空间的信息
- 决定一个 inode 或一个数据块是否是空闲的
- 有两个空闲数据结构(基于 bitmap),一个为了 inode,一个为了 数据块
- 超级块: 文件系统本身的信息
- 当挂载一个文件系统时会读取超级块的信息
- 启动块:启动 OS 所需要的信息
- 主引导记录(MBR): 启动计算机所需的信息
- 分区表: 每个分区的起始和结束地址(其中一个标记为活跃,就是启动 OS 的分区)
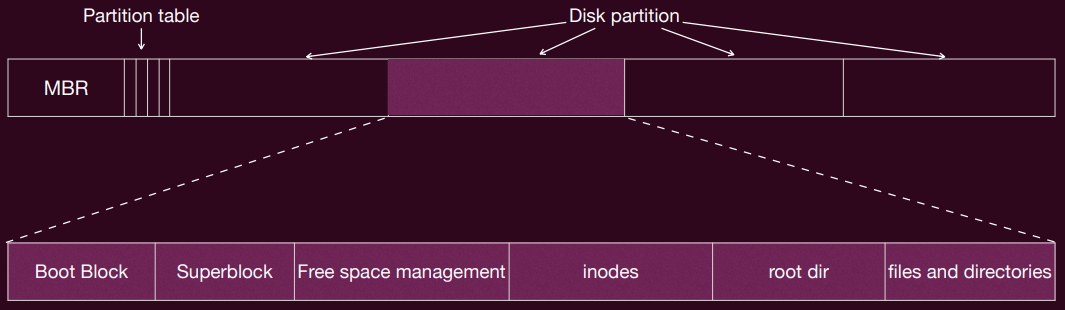
文件系统还需要在内存中维护相应的数据结构用来方便的对磁盘数据进行访问(用来反映和拓展磁盘中的结构)
- 挂载表:关于文件系统的挂载信息(挂载点、文件系统类型)
- 打开文件表: 系统范围的和每个进程的
- 目录结构:最近访问的目录信息
- I/O 内存缓冲: 读写磁盘时需要处理主存和磁盘之间速度差异的缓冲区
文件需要磁盘给定相应的数据块进行存储,此外还需要有一些数据结构来反映该文件用的数据块在哪(文件组织)
- 连续分配
- 链表
- 文件分配表
- 索引式分配
3.2 连续分配*
每个文件占据一个连续的数据块集合
- 只有文件的第一个数据块的地址和需要的数据块总数需要记录
- 线性的访问是高效的
- 随机访问的数据地址也是容易计算的
但连续分配不够灵活:
- 在文件创建时就需要知道文件的大小,之后如何增加和减少文件的大小也是麻烦
- 有外部碎片:需要进行收缩操作来减少这种碎片
3.3 基于链表的分配*
每个文件是一个数据块的链表
- 每个数据块包含指向下一个块的指针
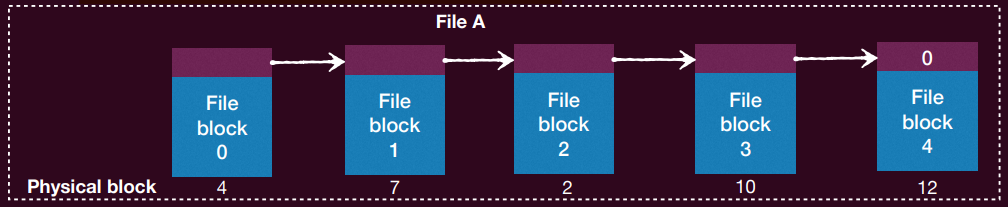
- 没有外部碎片:磁盘上的每个数据块都可以被使用
- 仅仅需要存储第一个块的地址
- 局限性:
- 随机读取会产生很多磁盘 I/O
- 每个数据块都需要为指针留取空间
- 指针损坏带来的可靠性问题
3.4 文件分配表(FAT)*
一个基于链表分配的变种,其将所有的指针放到同一个表格中
- 对于每个磁盘数据块都有一个 FAT 的项
- 每个 FAT 项包含一个指向下一个 FAT 项的指针,或者文件终止符号
- 对于随机访问的操作,只需要访问该 FAT 表即可,该表直接存储进主存从而减少 I/O 次数
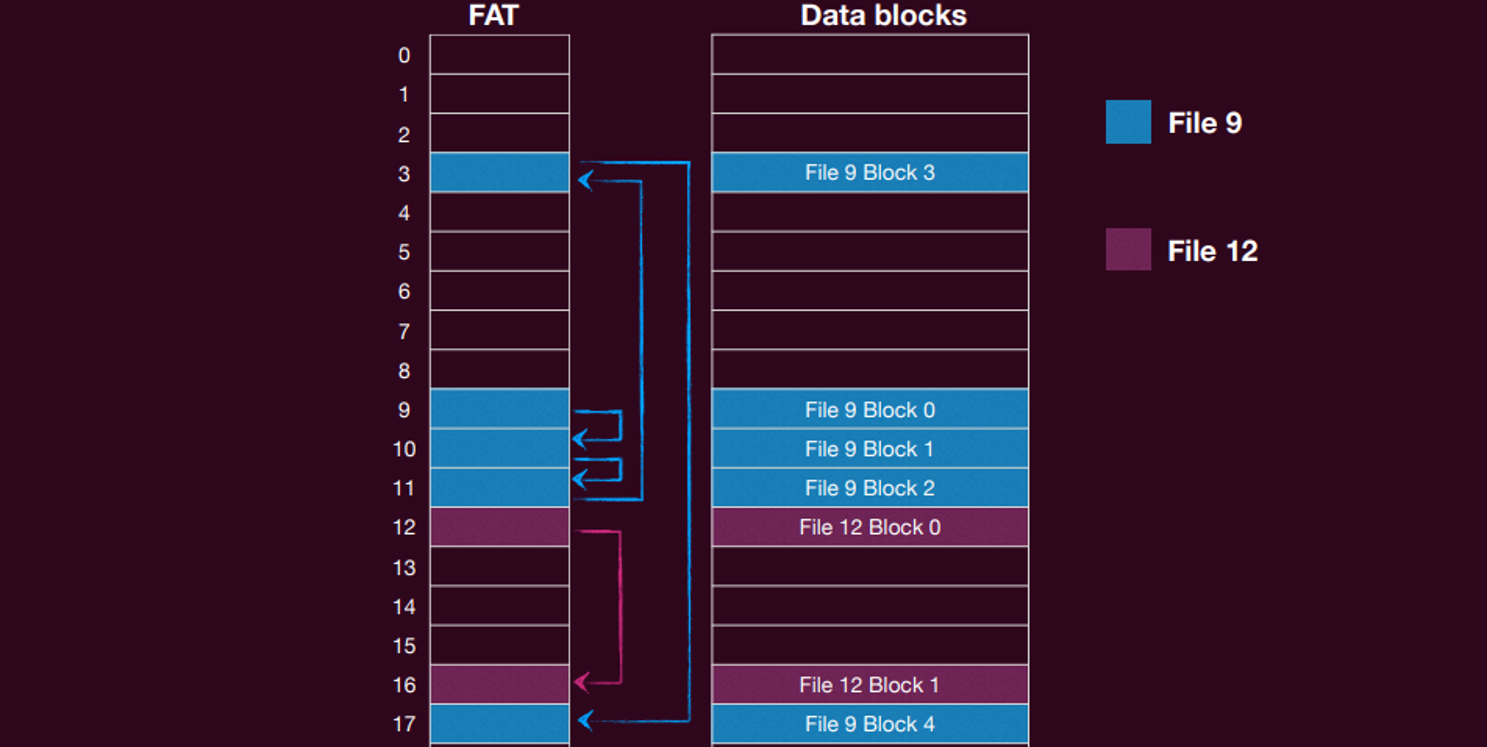
- FAT 表还可以用来进行空闲空间追踪
- 可以使用两个 FAT 表来增加可靠性
- 但 FAT 需要存储在主存中,这会带来巨大的开销
3.5 索引式分配
每个文件有一个对应的指针数组块(索引数据块),其中的每个指针指向该文件的一个数据块
- 第 \(i\) 个指针指向文件的第 \(i\) 个磁盘数据块
- 当文件打开时,该索引块才会被加载进内存
- 因此内存中的开销只和打开文件数相关,而不是整个磁盘
但有一个问题:每个文件所需要的指针个数不同(占据的数据块的个数不同),索引块大小难以确定
间接指针:将索引块中的指针指向一个由指针组成的数据块,其中每个指针再指向数据块
- 一个索引块中可以赋予固定数量的直接指针(指向数据块)和固定数量的间接指针
- 此时索引的结构变成了一个树(非平衡)
- 对于小文件和大文件都能很好支持
- 一般有 2 级和 3 级的非间接指针
例子:假定数据块为 4KB,一个表项为 4 字节
- inode 中的索引数据结构包含 15 个指针
- 开始的 12 指针指向数据块(\(12 \times 4\,\text{KB} = 48\,\text{KB}\))
- 最后 3 个指向间接数据块
- #13: 单级间接指针 (\(2^{10} \times 4\,\text{KB} = 4\,\text{MB}\))
- #14: 双级间接指针 (\(2^{10} \times 2^{10} \times 4\,\text{KB} = 4\,\text{GB}\))
- #15: 三级间接指针 (\(2^{10} \times 2^{10} \times 2^{10} \times 4\,\text{KB} = 4\,\text{TB}\))
3.6 目录组织*
目录提供了找到文件名和其在磁盘上的数据块的映射信息 <文件名, 文件索引>
- 当需要打开一个文件时,OS 首先找到路径名,并根据路径名找到磁盘上的目录项
- 目录项提供了该文件对应的磁盘数据块,可以是
- 整个文件所在的磁盘地址
- 第一个数据块的编号
- 文件的元信息 inode 号
- 文件的信息可以直接存储到目录的一项当中
- 目录的一项也可以只存储指向该文件元信息 inode 的指针
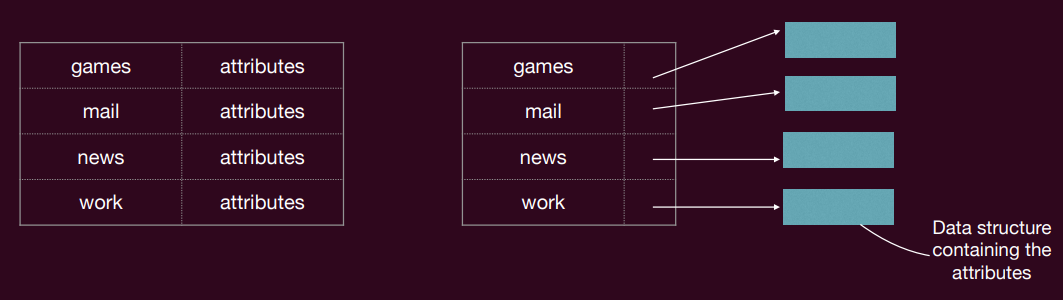
仍使用定长目录项:
- 文件名统一放到一个区域管理
- 当一个项被移出的时候,留下的空间完全可以分配给下一个需要存储的目 录项
- 文件名不需要在一个字的开头存储
- 但需要管理这个存放文件名的区域
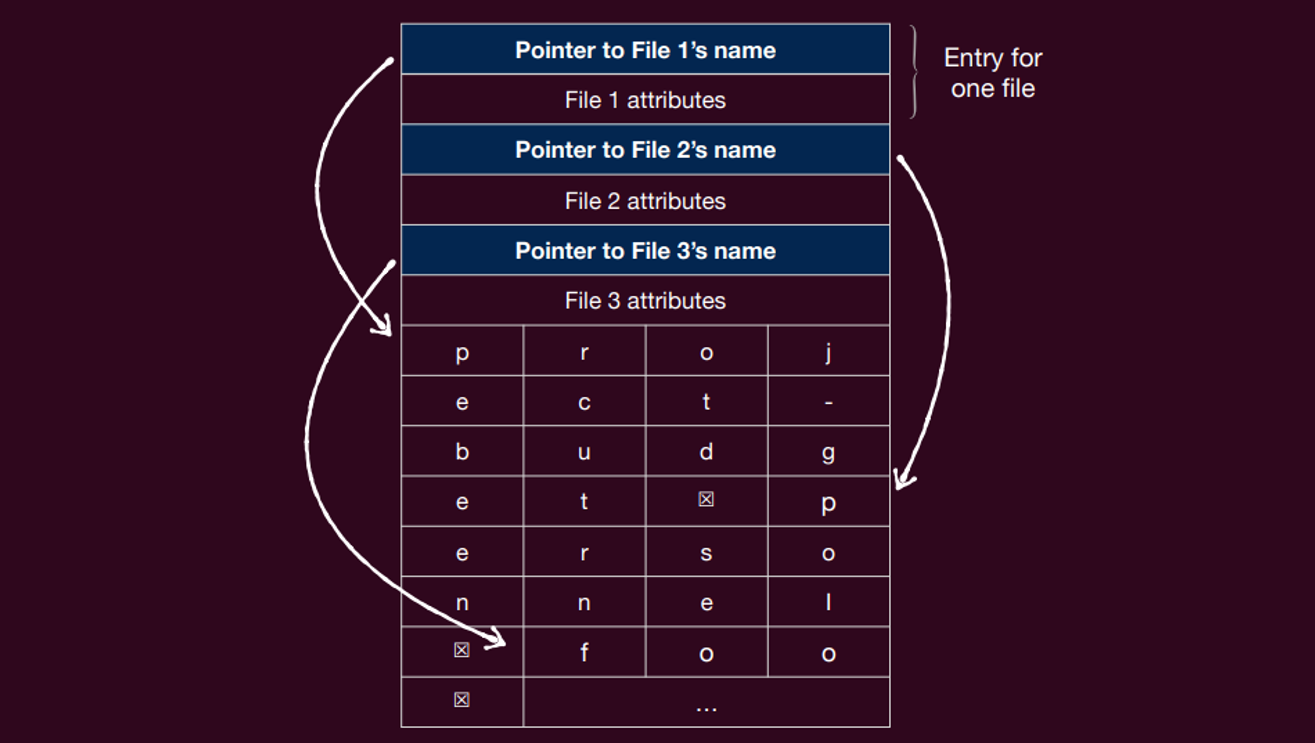
给定目录实现下的文件查找:
- 如果目录存储的是 <file name, inode number> 的列表
- 从头到尾开始搜索列表中的项
- 目录项多则低效
- 解决方案:增加一个额外的 hash 表(以 filename 为 key)
- 使用链表来处理碰撞
- 更快的查询,但也需要更为复杂的管理
- 此外,无论哪种方案,都可以利用 cache 来进一步加快搜索
3.7 空闲空间管理*
- 两种常见的管理结构:Bitmap(位图)和空闲列表
Bitmap:
- 每个数据块用一个 bit 位来表达,0 和 1 代表占据或者空闲
- 很容易找到连续的空闲空间
- Bitmap 需要额外的空间
- Block size = 4 KB = \(2^{12}\) bytes
- Disk size = 1 TB = \(2^{40}\) bytes
- 需要 \(2^{40} / 2^{12} = 2^{28}\) bits = \(32\) MB 空间的位图
空闲列表:
- 用一个链表来维护空闲块
- 没有空间浪费,只需要利用空闲空间块来存储指针即可
- 内存中只需要存储一个指针(head)
- 但分配的过程比较难
- 需要搜索这个链表来分配多个空闲块(额外的磁盘I/O)
- 难以得到连续的空间
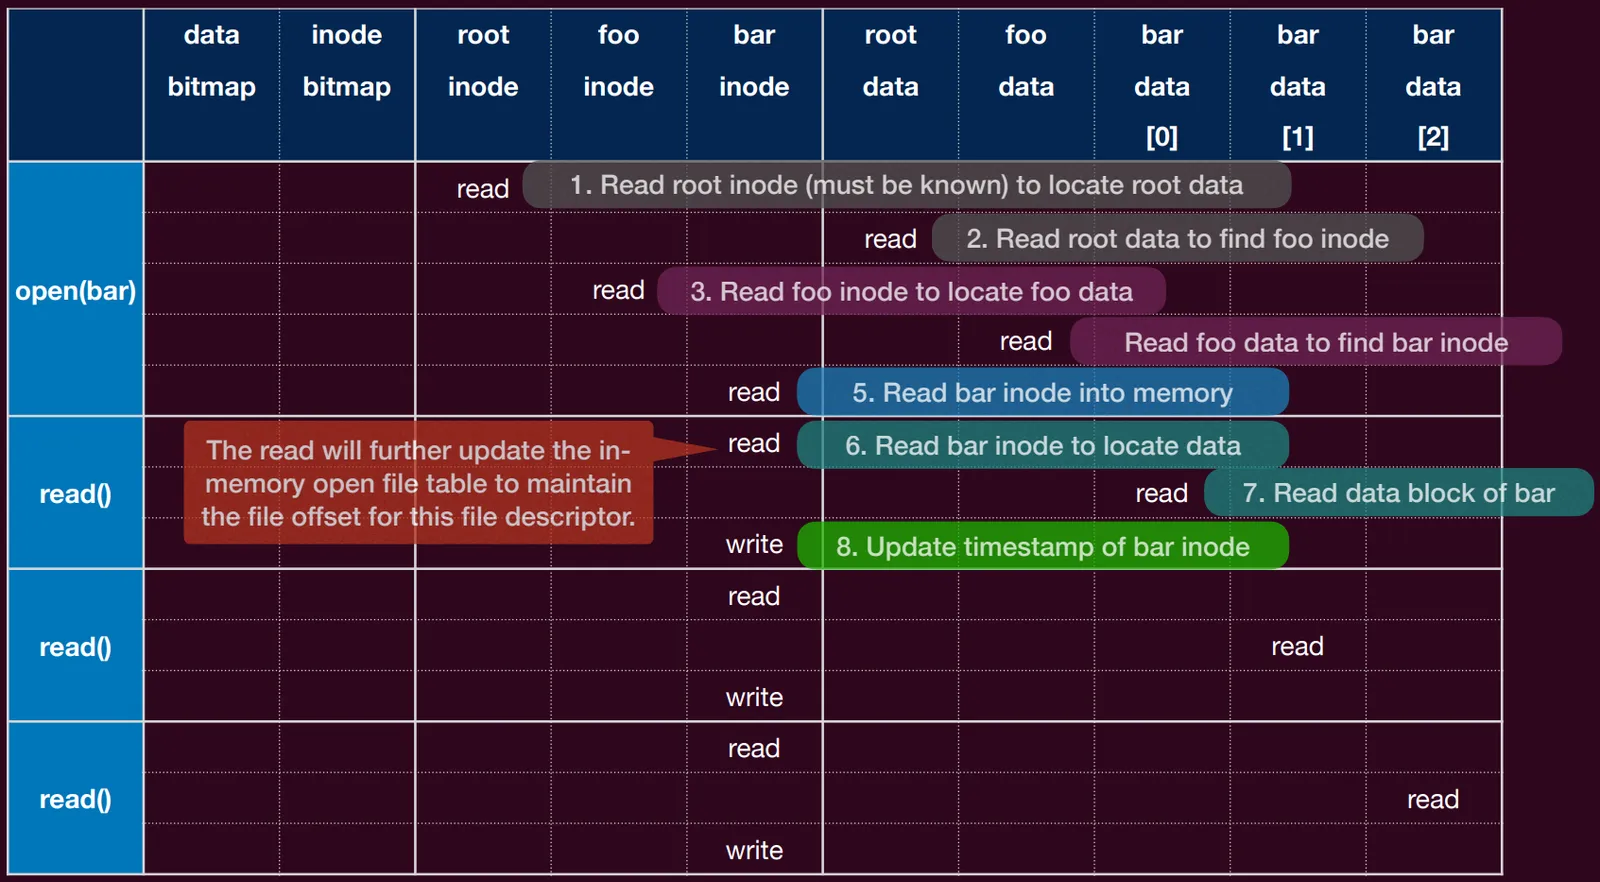
3.8 读文件
假设一个文件系统被挂载,其中超级块在内存中,但其他 (inodes, directories) 都在磁盘上
- 读一个文件首先需要打开这个文件:
- 首先需要循着路径名找到相应的 inode
- 读取这个 inode,做权限检验,合法就返回文件描述符(对应的操作会反映到打开文件表中)
- 然后对每个发起的读操作:
- 读相应的 inode
- 读相应的数据块
- 写 inode(更新上次访问时间)
- 更新内存中打开文件表中的 offset
例子:读取文件 /foo/bar 的开头 3 个数据块
3.9 写文件
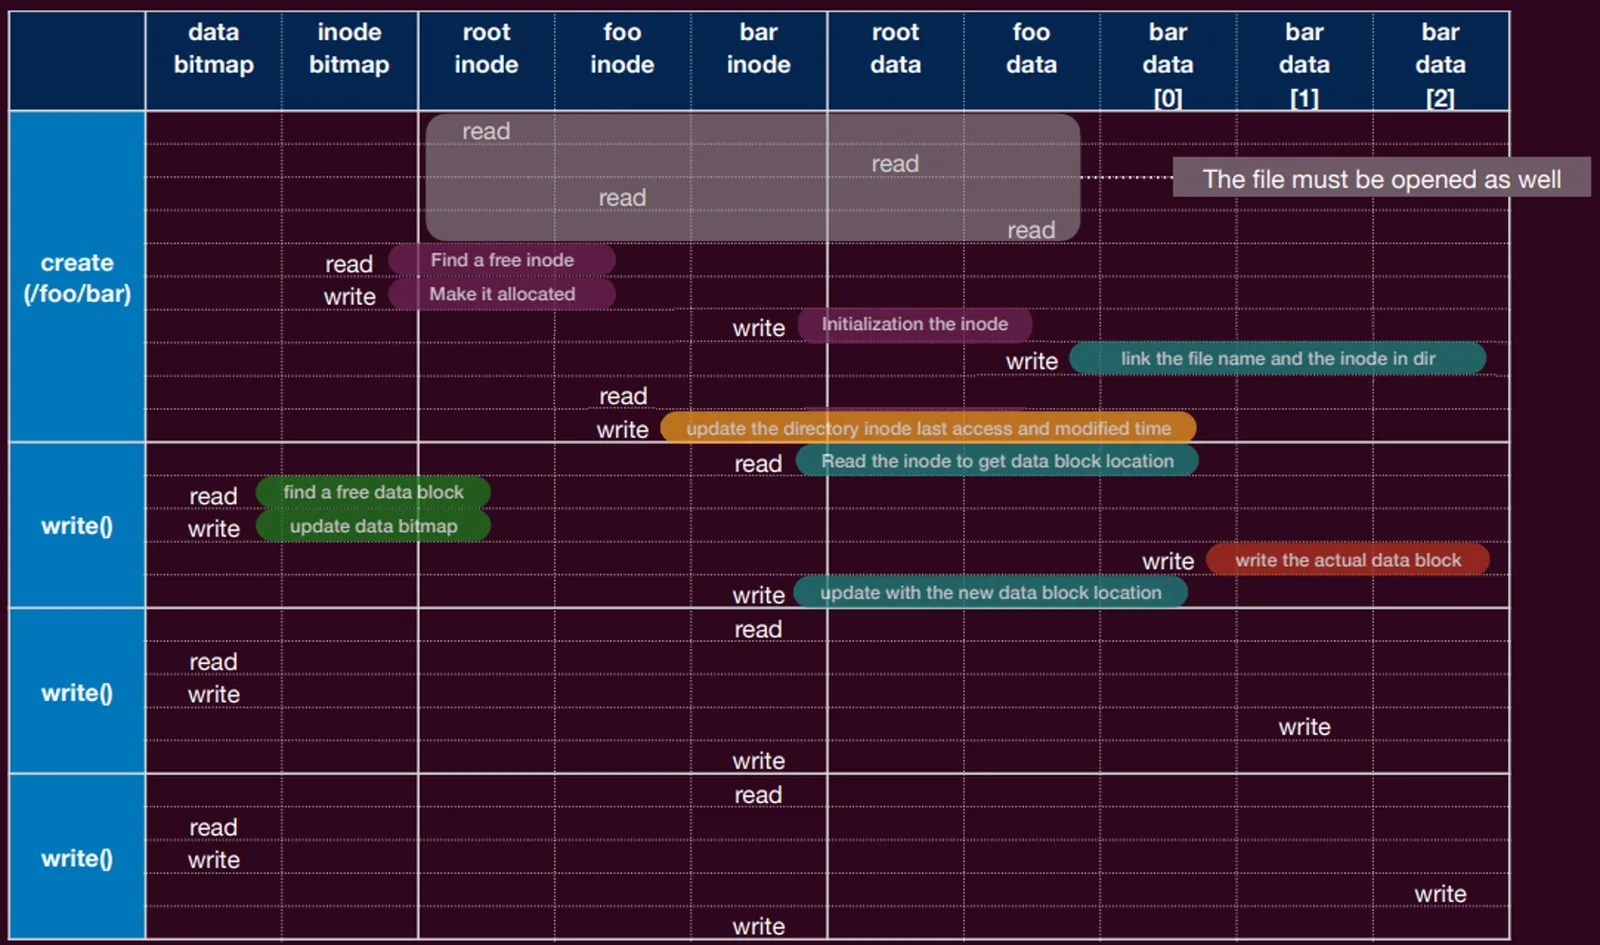
- 首先打开文件(过程与读文件类似)
- 但与读文件不一样的地方在于,写文件可能需要分配一个新的数据块(除非覆写旧数据块)
- 读和写空闲数据块结构比如 bitmap
- 读和写文件的 inode(更新 inode 表中这个新数据块的位置)
- 写这个新的数据块
- 当创建一个文件时需要更多的操作
- 读和写空闲数据块结构比如 bitmap
- 读和写文件的 inode(初始化)
- 读和写目录的数据(将文件名和其对应 inode 项写入)
- 读和写目录的 inode(更新目录)
- 如果目录需要增加容量来添加这个新的项,需要更多的 I/O(访问空闲数据结构,增加新的目录的数据块)
例子:创建 /foo/bar 并写入 3 个数据块
3.10 缓存和缓冲*
预取: 可以将需要的数据块提前存入缓存中来提高缓存击中率 写缓冲:
- 延迟写操作:文件系统可以批处理一些 I/O 写的操作
- 缓冲写操作,文件系统还可以合理的调度 I/O 来提高性能
3.11 快速文件系统(FFS)*
一个好的文件系统是有磁盘意识的
- FFS 将文件系统被划分为一系列块组
- 每个组由一组相邻的磁道构成(即柱面组)
- FFS 将可能顺序访问的块放在同一个组中,以减少磁臂移动的量
- 对于文件:
- 将数据块分配到与其 inode 相同的组中
- 将同一目录中的所有文件放置在该目录所在的组中
- 对于目录:
- 找到已分配目录数量较少(以平衡各组间的目录)且空闲 inode 数量较多(以便能分配大量文件)的组
- 将目录数据和 inode 放在该组中
4 文件系统可靠性*
4.1 一致性
当需要为一个文件增加一个数据时
- 需要写一个新的数据块
- 需要写这个文件的 inode
- 需要写数据的 bitmap
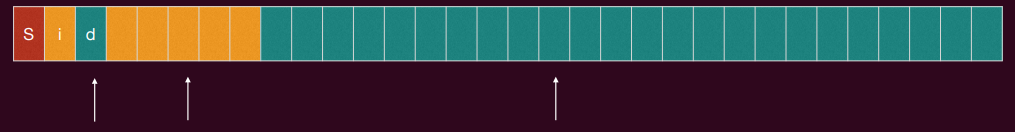
如果这中间发生了一个 crash?
- 理想的方案
- 一个文件系统原子的从一个一致的状态进入另一个一致的状态
- 但磁盘只能支持一个写操作是原子的(而两个状态之间的迁移往往涉及多个写操作)
- 实际的方案
- 文件一致性检查(fsck)
- 日志化
4.2 文件一致性检查
- 完整性检查超级块
- 检查空闲块和位图的有效性
- 检查 inode 是否未损坏
- 检查 inode 链接
- 检查重复的指针和损坏的块
4.3 日志
基本思路:预写日志或日志,该思路借鉴自数据库系统
- 在覆盖结构之前,先写一个小日志(存储在磁盘上),描述将要做的事情
- 如果在更新过程中发生故障,我们可以在重启时读取日志并重试
- 在写入意图之前崩溃:没有操作
- 在写入意图之后崩溃:重做该操作
- 在更新期间增加的一些工作量,可以大大减少恢复期间所需的工作量
- 无需扫描整个磁盘,只需要查看奔溃前的日志中的记录即可
标题:文件系统
作者:Zwing
创建于:2026-08-09 00:06:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/持久化-文件系统.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可