
互斥
1 互斥:基础
1.1 并发的术语
- 临界区:访问共享资源的一段代码,资源通常是一个变量或数据结构
- 竞态条件:出现在多个执行线程大致同时进入临界区时,它们都试图更新共享的数据结构,导致非预期的结果。
对于一个运行程序(尤其是并发程序)的两个重要属性
- 安全性:“没有坏事发生”
- 安全性要求执行中的任何有限步骤内都保持这个性质
- 如:执行过程中不可出现除 0 错误
- 活性: “好事终将发生”
- 只要在最终能满足要求即可,一个隐含的要求是执行中不能发生 “不可挽回” 的步骤
- 如:执行最终停止(执行中间出现一个无限循环就 “不可挽回”)
1.2 临界区的解决方案需满足的条件
- 互斥:临界区内最多只能有一个线程(安全性)
- 行进:如果当前临界区内没有线程,并且有线程想要进入临界区,那么最终某个想要进入临界区的线程会进入该临界区(活性)
- 有界等待:如果某个线程想要进入临界区,那么其等待的期限有限(期间其他线程进入该临界区次数有上限),不可一直排队等待(公平性/无饿死)
- 如果这个上限没有被指定,那么这就是一个活性,其最终会进入
- 如果这个上限被指定具体数字,那么这就是一个安全性,因为任何一次执行的有限步骤内,其等待进入的次数只要超过这个上限就发生了“坏事”
- 性能:进入和退出该临界区的操作开销尽可能小
- 经验法则:当设计并发算法时,优先考虑安全性
1. printf 代码是临界区代码吗?
- 从内存变量的角度看: 可以是可以不是,取决于上下文
- 从系统设备的角度看(是):
printf最终会将数据输出到标准输出流 (stdout),stdout缓冲区也是进程内全局唯一的
2. printf 线程安全吗?
- 结论:是的,它是线程安全的。
- 底层实现机制: 现代 C 标准库在实现
printf时,内置了同步机制。当一个线程调用printf时,底层会自动尝试获取stdout流的互斥锁- 只有拿到锁的线程才能把字符写入缓冲区。
- 写完之后释放锁,其他排队的线程才能接着写。
但printf 不保证全局的执行顺序,这取决于操作系统调度器
2 锁
- 锁是一个变量,其保存了锁在某一时刻的状态
- 它要么是可用的,表示没有线程持有锁
- 要么是被占用的,表示有一个线程持有锁,正处于临界区
- 其提供两个配对操作:
lock()/acquire():尝试获取锁,如果没有其他线程持有锁,该线程会获得锁,进入临界区,否则(该锁已经被持有了)不会返回(该线程会卡在那里)unlock()/release():锁就变成可用了(可被获得),之前如果有因获得锁操作没成功卡在那的线程,那么其中一个会进入临界区
long sum = 0;
void *T_sum(void* nothing) {
    for (int i = 0; i < N; i++) {
        lock(); // <--
        sum++;
        unlock(); // <--
    }
}
2.1 尝试 1:关中断
- 通过中断使当前程序状态机独占计算机系统
- 一条指令就可以实现原子性
lock()->disable interruptunlock()就是再次打开打开中断
- 尝试 1 的问题
- 处理器有不可屏蔽中断
- 临界区的代码死循环了 -> 整个系统也卡死了
- 中断关闭时间过长会导致很多其他重要的外界响应丢失
- 关中断是特权指令,用户态的应用是无法执行的,只有操作系统有这个权限
- 多处理器无效,中断是每个处理器内部状态
2.2 尝试 2:通过软件(Lock标志)
- 使用一个标志来表达此时锁的状态
int flag = 0;

void lock(){
    while(flag == 1); // 自旋地观测 flag
    flag = 1; // 设置
}

void unlock(){
    flag = 0;
}
- 尝试 2 的问题
- 这个方法不过是把共享变量存在的竞态条件转移到了锁的这个状态变量上而已
- 完全存在两个线程同时发现 flag 为 0,然后都进入临界区的可能
- 问题原因:
test和set是两个指令,没有原子的同时test-and-set
| 时间 | Thread 1 | Thread 2 |
|---|---|---|
| 1 | test $flag, 1 |
|
| 2 | test $flag, 1 |
|
| 3 | set $flag, 1 |
|
| 4 | set $flag, 1 |
|
| 5 | enter the critical section | |
| 6 | enter the critical section |
2.3 尝试 3: 互斥的 test
- 如果每个线程都是采用同一个判定:
test flag == 1,那么完全存在所有的线程都可能得 到同样的True - 但是如果给每个线程的判定条件都不一样,且判定条件不可能同时对每个为
True呢?- 一个线程回答
True意味着其他线程回答False,在逻辑上就达成了互斥
- 一个线程回答
/* for thread 1 */
void lock(){
    while(flag == 0); //自旋的观测 flag
    // 注:这是在内存顺序一致性模型下才成立
}
void unlock(){
    flag = 0; //设置
}
// unlock 会给别人机会,自己下一次 lock 判定就会 false
// 只有别的进程 unlock,自己下一次 lock 才能判定为 true
// 所以这个方法是让每个线程 “严格轮转的”

/* for thread 1 */
void lock(){
    while(flag == 1);
}
void unlock(){
    flag = 1;
}
- 这个方法存在一个问题:一个线程能否得到一个锁完全依赖于另外一个线程是否先进入了临界区
- 如果 thread 2 始终不进入临界区,那么 thread 1 最多进入一次临界区之后就无法再进入了,违背了活性性质,因为目前没有线程在临界区,而 thread 1 想进入临界区,但永远无法再进入,因此无法 “行进”
2.4 Peterson 算法
- 除了有一个全局变量来进行判定 “轮到谁”,还得有一个全局变量来记录是否有其他线程要进入临界区
bool flag[2] = {false, false}; // 记录两个线程是否想要进入临界区
int turn = 0;                  // 记录当前“轮到”谁进入了

void lock(int self) {
    int other = 1 - self;      // 计算对方线程的 ID

    flag[self] = true;         // 明确表达意愿

    // 如果 “对方也想进” 并且 “现在确实轮到对方了”
    while (flag[other] == true && turn == other); // 自旋等待 (busy wait)
}

void unlock(int self) {
   flag[self] = false;
   turn = other;              // 主动谦让
}
| 时间 | Thread 0 | Thread 1 |
|---|---|---|
| 1 | flag[0] = false; |
|
| 2 | enter the critical section | |
| 3 | flag[1] = false; |
|
| 4 | turn = 0; |
|
| 5 | turn = 1; |
|
| 6 | flag[0] = true; |
|
| 7 | test flag[other] == true(false) |
|
| 8 | enter the critical section | |
| 9 | flag[1] = true; |
|
| 10 | test turn == other(false) |
|
| 11 | enter the critical section |
turn的真正作用在于当两个线程都有进入意图之后解决冲突- 设意图后,接着立刻谦让
- Peterson 的一个正确实现
bool flag[2] = {false, false}; // 记录两个线程是否想要进入临界区
int turn = 0;                  // 记录当前“轮到”谁进入了

void lock(int self) {
    int other = 1 - self;      // 计算对方线程的 ID

    flag[self] = true;         // 第一步:明确表达意愿
    turn = other;              // 第二步:主动谦让

    // 如果 “对方也想进” 并且 “现在确实轮到对方了”
    while (flag[other] == true && turn == other); // 自旋等待 (busy wait)
}

void unlock(int self) {
    flag[self] = false;
}
证明 Peterson 算法的正确性:
Lemma 1:当一个线程 \(T_i\) 在调用 lock() 后和在离开临界区之前有 flag[self] == true
- 显然成立
Lemma 2:[安全性] Peterson 算法能够保持互斥性
- 为了方便起见,一个状态记为:\([t, h, k, f_0, f_1]\)
- \(t\) 当前的
turn的值 - \(h\) 是当前线程 \(T_0\) 的语句的 index
- \(k\) 是当前线程 \(T_1\) 的语句的 index
- \(f_0\) 是
flag[0] - \(f_1\) 是
flag[1]
- \(t\) 当前的
\(T_i\) works as follows:
do {
    flag[self] = true;             // 1
    turn = other;                  // 2
    while ( (flag[other] == true)  // 3
            && (turn == other) );
    critical_section();            // 4
    flag[self] = false;            // 5
    reminder_section();            // 6
} while(1);
- 不失一般性,我们假设状态 \([0, 4, 4, 1, 1]\) 发生了,意味着 \(T_0\) 和 \(T_1\) 都进入了临界区
- 由于最后
turn = 0,根据进入临界区的判定语句flag[other] == true && turn == otherflag[other] == true:根据 Lemma1 这部分是true(两个都进了)turn == other只能是false,other = 1,self = 0,因此最后进入的是 \(T_0\)
- 因此 \([0, 4, 4, 1, 1]\) 的前一个状态是 \([0, 3, 4, 1, 1]\)
- 即 \(T_0\) 一定是从状态 \([0, 3, 4, 1, 1]\) 之后进入了临界区
- 状态 \([0,3,4,1,1]\) 有两个可能的前驱
- 一个前驱是 \([0,3,3,1,1]\):\(T_1\) 也等待在判定语句(都在第 3 句,不涉及
turn的改变)- 若是 \([0,3,3,1,1]\),\(T_1\) 的
turn == other条件是true,无法进入临界区
- 若是 \([0,3,3,1,1]\),\(T_1\) 的
- 另一个前驱是 \([?, 2, 4, 1, 1]\):\(T_1\) 早进入了临界区,\(T_0\) 再往后退一步
- 若是 \([?, 2, 4, 1, 1]\),\(T_0\) 的语句 2 会将
turn变为1,不会有下一步的turn为0
- 若是 \([?, 2, 4, 1, 1]\),\(T_0\) 的语句 2 会将
- 一个前驱是 \([0,3,3,1,1]\):\(T_1\) 也等待在判定语句(都在第 3 句,不涉及
- 由于这两个可能都矛盾了,因此假设不成立,由于一般性,因此,Peterson 算法是互斥的
Peterson 算法能够保持 “行进” 吗?
while (flag[other] == true && turn == other)- 没有其他线程要进入,这个地方直接返回
false
Peterson 算法能够保持 “有界等待” 吗?
- 对于只有两个线程的情况下,这是显然的,因为一个线程只要表达出要进入临界区的意愿,最多只要等一轮
turn = other;
现实在现代多核 CPU 架构下,由于指令重排序和内存可见性(Store Buffer)的问题,线程可能在还没把
flag[self] = true真正写回主存时,就提前读取了flag[other](读到了旧值 false)。因此,必须借助内存屏障才能让 Peterson 算法在现代硬件上正确运行
2.5 硬件支持的锁
int flag = 0;

void lock(){
    while(flag == 1); // 自旋地观测 flag
    flag = 1; // 设置
}

void unlock(){
    flag = 0;
}
| 时间 | Thread 1 | Thread 2 |
|---|---|---|
| 1 | test $flag, 1 |
|
| 2 | test $flag, 1 |
|
| 3 | set $flag, 1 |
|
| 4 | set $flag, 1 |
|
| 5 | enter the critical section | |
| 6 | enter the critical section |
- 回到这里,其实只要 test 和 set 这两个指令的原子化就好了
- 即原子的 Test-And-Set (TAS) 指令
- 很多硬件架构都提供了原子指令可以来实现 Test-And-Set Lock (TSL)
- 事实上,所有 X86 CPU 都具有锁定一个特定内存地址的能力,当这个特定内存地址被锁定后,它就可以阻止其他的系统总线读取或修改这个内存地址
3 互斥:进阶
3.1 自旋锁的一个改进
- 当一个线程在自旋等待(也叫忙等待,busy waiting)时,不一定能够最终进入临界区吗
- 如果一直有其他线程要进入临界区,并且这些线程一直被优先调度进入临界区,那这个线程就可能会一直等在那里(违背了有界等待)
- 解决方法:排队
- 每次尝试进入临界区就拿一个 “号”(下一个尝试的“号”加一),等待 “叫号”
typedef struct lock_ticket {
    int ticket; // 当前发放的最大票号
    int turn;   // 当前应该进入的票号
} lock_t;

lock_t flag;

void lock_init() {
    flag.ticket = 0;
    flag.turn = 0;
}
- 排号自旋锁(Tick Lock)的加锁和解锁,通过原子的
fetch_and_add实现
void lock() {
    int myturn = 1;
    // atomic fetch-and-add
    // equal to myturn = __sync_fetch_and_add (&flag.ticket, 1);
    // 将 1 加到 flag.ticket,并返回 flag.ticket 的 “旧” 值给 myturn
    asm volatile (
        "lock xaddl %0, %1"
        : "+r" (myturn), "+m" (flag.ticket) // <--
        : "memory", "cc"
    );
    while (flag.turn != myturn)
        ; // spin
}

void unlock() {
    int value = 1;
    asm volatile (
        "lock xaddl %0, %1"
        :"+r"(value),
        "+m" (flag.turn) // <--
        : "memory", "cc"
    );
}
- 正在竞争锁的线程总数 =
flag.ticket-flag.turn
一把大锁会锁住所有?
- 并不是所有线程都 “彼此” 需要互斥,应该给需要彼此互斥的线程集独有的 “锁”, 更加 “细粒度” 的锁可以提高并发性能
- 修改之前的自旋锁实现方法:对参数所指向的锁(而不是全局的一把大锁)进行加锁和解锁操作
- 修改前(全局锁):
flag.ticket和flag.turn是全局的公共变量,整个系统只有一个 - 修改后(细粒度锁):引入了
lock_t *flag参数- 将
ticket和turn这两个状态变量封装在了一个独立的数据结构lock_t中。 - 可以根据需要,实例化无数个
lock_t对象 lock()和unlock()操作不再修改全局变量,而是通过指针flag->ticket和flag->turn只去修改传入的那把特定的锁
- 将
- 修改前(全局锁):
lock 和 unlock 没有 “真正” 意义上的保护临界区的共享资源,必须要按照正确方式才能形成保护
T1: spin_lock(&lk); sum++; spin_unlock(&lk);
T2: sum++; // wrong
3.2 在内核中实现自旋锁的问题
- 内核的实现中会出现很多需要访问共享资源的情况,使用互斥锁的情况非常普遍
- 除了系统调用程序外,还有中断处理程序中也可能用到
考虑如下情况:
- 一个线程利用系统调用访问一个共享变量,内核在访问这个共享变量时上了锁
- 此时一个中断发生了,CPU 强制转向中断处理程序,这个中断处理程序也需要访问这个共享变量,因此尝试获得锁,但是发现这个锁已经被持有了,只能自旋等待
- 中断处理程序的优先级一般很高,要高过系统调用
- 因此该中断处理程序就会一直等待一个不再可能发生的事情
解决方法:尝试在自旋锁之前关中断,然后释放锁的时候开中断
- 这个尝试是错误的!如果在自旋之前就已经关中断了,解锁就打开中断就会破坏在这次自旋之前的中断状态(eg. 下图的 “嵌套锁”)
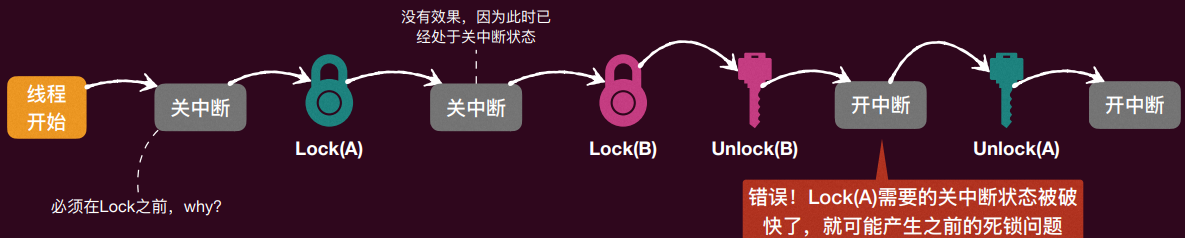
- 因此需要保存自旋之前的中断状态(打开或关闭),然后在解锁时恢复这个状态
- xv6 的实现里,
push_off()记录中断关闭的次数,pop_off()记录想要打开中断的次数(只有当该次数等于中断关闭的次数才能真正去打开中断) - xv6 实现具体代码略
- xv6 的实现里,
3.3 应用程序里的使用互斥锁问题
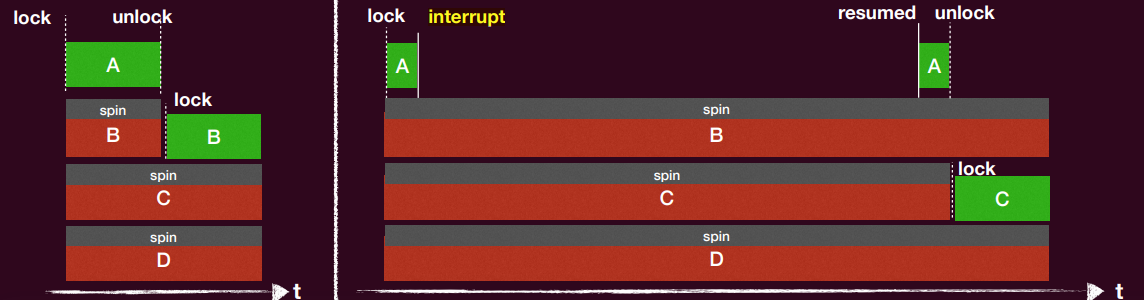
性能问题:除了进入临界区的线程,其他处理器上的线程都在空转
- 如果临界区执行时间过长(用户线程的常态),其他线程浪费的 CPU 越多
- 内核中的临界区一般都为 “短” 临界区
- 此外,如果发生中断将临界区的线程切出去了,计算资源浪费更加严重
- 然而用户态无法通过关闭中断来解决问题
一个简单解决方案:yield
- 利用系统调用
sched_yield()直接让出 CPU,让其他线程获得 CPU 使用
void yield_lock(spinlock_t *lk) {
    while (xchg(&lk->locked, 1)) {
        //a wrapper of sched_yield()
        syscall(SYS_yield); // yield() on AbstractMachine
    }
}
void yield_unlock(spinlock_t *lk) {
    xchg(&lk->locked, 0);
}
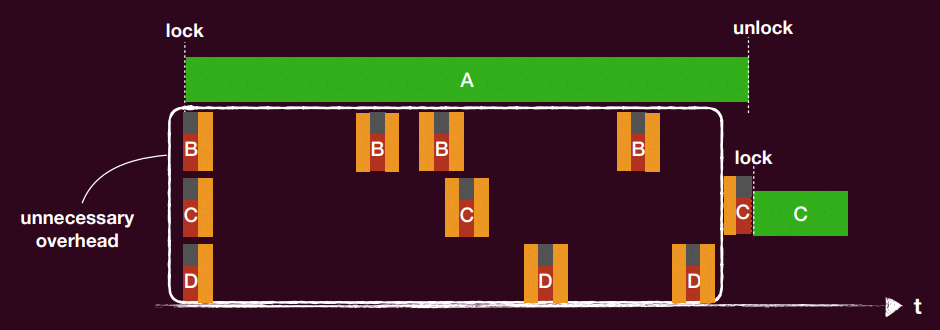
直接 yield 的问题:
yield只是暂时让出 CPU,该线程还处在 “ready” 的阶段,随时可以被再次调度- 在获得锁之前,反复的 “被调度 —> 让出 CPU” 会带来大量不必要的上下文切换
解决方案:用户使用和释放锁应该和 OS 调度程序配合
mutex_lock(&lk):试图获得lk,如果失败(lk已被持有),利用系统调用阻塞该 线程(此时不是就绪态,无法被调度了),让出 CPU 并将其加入等待锁的队列之中。否则,成功获得锁进入临界区。mutex_unlock(&lk):释放锁,如果等待该锁的队列里有线程就利用系统调用选择一个唤醒,使其变成就绪态(ready),从这个等待队列删除,并进入就绪的队列,可以被再次调度。- 操作系统需要对一个锁维持一个与其相关的队列
void mutex_lock(spinslock_t* lk) {
    int got;
    do {
        got = atomic_xchg(lk->status, LOCKED);
        if (got != UNLOCKED) {
            // 将当前线程加入等待队列,并标记为阻塞,释放cpu
            wait(lk->wait_list);
        } else {
            break;
        }
    } while (1);
}

void mutex_unlock(spinslock_t* lk) {
    atomic_xchg(lk->status, UNLOCKED);
    if (!is_empty(lk->wait_list)) {
        // 等待队列中的一个线程移出队列,标记为就绪
        wakeup(lk->wait_list);
    }
}
| 时间 | Thread 1 | Thread 2 |
|---|---|---|
| 1 | got != UNLOCK |
|
| 2 | atomic_xchg(&lk->status, UNLOCKED); |
|
| 3 | if(!is_empty(lk->wait_list)) {wakeup(lk->wait_list);}此时等待队列没有线程, wakeup 丢失 |
|
| 4 | wait(lk->wait_list); |
- Linux 提供了如下两个系统调用:
futex_wait(int *address, int expected)- 首先原子的 test 此时
address指向的值和期待的值是否相等,相等才会将线程阻塞,否则立即返回给用户线程,使其可以立马再次尝试 lock
- 首先原子的 test 此时
futex_wake(int *address)- 唤醒一个等待
address指向的锁的线程
- 唤醒一个等待
基于这两个系统调用,可以实现如下互斥锁:
// 锁的三个状态定义
#define UNLOCK 0    // 解锁
#define ONE_HOLD 1  // 独占
#define WAITERS 2   // 竞争

void mutex_lock(spinlock_t* lk) {
    // 如果 lk = UNLOCK,则将 lk 置为 ONE_HOLD
    // 否则什么也不做
    // 最终再返回修改前的旧值
    int c = cmpxchg (lk, UNLOCK, ONE_HOLD);

    if (c != UNLOCK) { // 【慢速路径】如果 c != 0,说明锁不是空闲的,我们抢锁失败
        do {
            // 如果已经是 WAITERS,或者我们成功把 ONE_HOLD 升级成了 WAITERS
            // 注意这里 cmpxchg != 0 的妙用:如果刚好别人释放了锁(变成了0),
            // cmpxchg 会失败返回 0,我们就不会去睡觉,而是直接跳出 if 进入下一轮抢锁
            if (c == WAITERS || cmpxchg(lk, ONE_HOLD, WAITERS) != 0) {
                futex_wait(lk, WAITERS); // 线程挂起
            }
        }
        // 线程被唤醒后,回到这里继续抢锁
        while ((c = cmpxchg (lk, UNLOCK, WAITERS)) != 0);
        // (VERY TRICKY):此时抢锁,必须尝试把 0 直接改成 2,而不能改成 1
        // 为什么?既然能走到这里,说明刚才排过队,极有可能此时还有其他兄弟正在排队
        // 如果自私地设为 1,解锁时就不会去唤醒其他兄弟,导致他们永远死锁
        // 如果抢锁失败(别人又抢先了),c != 0,继续回 do 循环里受苦

    } else { // 【快速路径】如果 c == 0,拿锁,直接返回继续执行业务代码
        return;
    }
}

void mutex_unlock(spinnlock_t* lk){
    //state can only be ONE_HOLD or WAITERS
    if(atomic_dec(lk) != ONE_HOLD){ // 原子性减一并返回旧值
        //has more than one waiters
        lk = UNLOCK;
        futex_wake(lk);
    }else{
        //No Waiters!
        return; //the fast path unlock!
    }
}
正确性的简单解释:
mutex_lock函数只会在成功锁住lk后才会返回- 获得
lk的线程本身会将lk原子的设为 1,而其他等待线程将会将lk原子的设为2,这使得除获得锁外的其他线程不可以在临界区,只有获得锁住线程在退出临界区调用mutex_unlock才会将lk设为 0:这保证了上锁的正确性!
- 获得
- 等待的线程能够被唤醒,因为只要有等待的线程在
wait,那么此时的lk一定为 2!而unlock就一定会将某个等待的线程唤醒! - 由于
unlock函数在wake_up之前先将lk设为 0,因此上述即使发生了上述丢失wakeup的调度,由于futex_wait的特性,那个线程在调用futex_wait时会发现lk的值变了,因此不会休眠
虽然避免了自旋浪费 CPU,但每次进行 Lock/Unlock 都要陷入内核,这也需要额外的开销,如上下文切换
- 只有内核才能让线程 “阻塞”、“yield”
但是在真实的 workload 中,多个线程抢一个锁的事件发生的频率并不大,很多时候往往是一个线程加一个锁进行保护 这个时候使用之前的 spinlock 会更加快速!因为其不用陷入内核,也不会空转
操作系统将两者优点结合起来,实现了一个两阶段锁
- Fast Path: 自旋一次
- 一次原子指令,成功直接进入临界区
- Slow Path: 自旋失败
- 按照情况利用系统调用
futex_wait,阻塞自己
- 按照情况利用系统调用
pthread mutex lock 实现了上述需求(很多线程的争抢下依然能保持很好的性能),使用方法和自旋锁一致,大部分情况下(在有操作系统的情况)使用它即可
#include <pthread.h>

pthread_mutex_t mutex;
int pthread_mutex_init(pthread_mutex_t *restrict mutex, NULL);
int pthread_mutex_destroy(pthread_mutex_t *mutex);

int pthread_mutex_lock(pthread_mutex_t *mutex);
int pthread_mutex_unlock(pthread_mutex_t *mutex);
3.4 并发数据结构
- 线程安全的数据结构指的一个数据结构可以被多个线程并发的访问
- 也被称为并发数据结构
- 要达成这样的数据结构一般我们需要在访问和更新该数据结构时上锁(一把或多把)
- 最简单的做法:一把大锁!所有访问都串行化
- 但在多处理器时代,可能会造成性能瓶颈
一个允许并发线程访问的数据结构 counter_t,其支持的操作如 increment、decrement 和 get 由于都受到互斥锁的保护,因此都是线程安全的
typedef struct __counter_t {
    int value;
    pthread_mutex_t lock;
} counter_t;

void init(counter_t *c) {
    c->value = 0;
    Pthread_mutex_init(&c->lock, NULL);
}

void increment(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value++;
    Pthread_mutex_unlock(&c->lock);
}

void decrement(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value--;
    Pthread_mutex_unlock(&c->lock);
}

int get(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    int rc = c->value;
    Pthread_mutex_unlock(&c->lock);
    return rc;
}
如果想要更高的性能?
- 每个 CPU 维持一个本地的 counter,所有 CPU 共享一个全局 counter
- 本地的 counter 只需要本地的一个锁保护(per cpu),全局的 counter 访问需要一个全局的大锁
- 本地的 counter 可以选择每过一段时间(而不是每次)进行更新全局的 counter,从而增加并发度
可以看到,我们的并发解决方案是层级的
- 并不是所有并发都是硬件提供的,也不是都是软件
- 而是,硬件提供了基本的原子指令(如
cmpxchg),操作系统提供了一些并发(同步)的原语(如futex_wait,futex_wake),库函数包裹一些好用的 APIs(如pthread_mutex_lock,pthread_mutex_unlock),最后用户使用这些原语来构建正确和高效的并发程序
软件上实现“互斥”很难,而且在现代计算机系统下也不正确
通过硬件支持的原子指令可以实现自旋锁,从而正确实现互斥
然而实际的互斥锁有更多的考量
- 在内核中的互斥锁要考虑中断带来的麻烦
- 而在用户态由于临界区过长,自旋出现性能问题,而解决这个问题需要操作系统和用户态共同完成一个
wait-wakeup的原语,正确的实现同样不简单
标题:互斥
作者:Zwing
创建于:2026-08-09 00:13:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/并发-互斥.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可