
多处理器编程
- 并发就是操作系统的核心之一
- 操作系统的很多内部数据结构(如进程列表、页表、文件系统结构)都得考虑数据竞争的可能。
- 并发的很多技术都是源自于操作系统的设计需求和其相应的解决方案
定义并行加速比:
- 让程序中可以被并行化的指令部分的比例为 \(p\),而程序不可并行化的部分为 \(1 - p\)(注:不是所有逻辑都是可以并行化,如果存在前后依赖的话就难以并行化)。
- 那么在有 \(n\) 个并行执行流的情况下,程序的加速比(相比于单个执行流)为
1 多线程编程入门
- 什么是线程: 共享内存的执行流
- 拥有独立的 “上下文” 和栈帧列表,共享全局变量、堆空间
- 线程就是代表着程序的 “执行” 单位,操作系统可以随时运行、暂停、和恢复执行它
- 有了线程,我们可以 “线性的” 写多个执行流,然后他们可以 “并发” 的执行
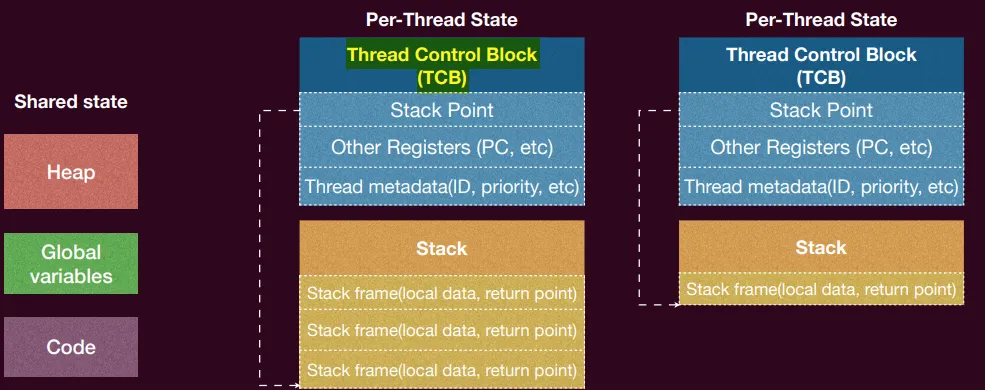
- 从状态机的角度来看,多个线程就是多个共享内存的状态机
- 初始状态为线程创建时刻的状态,状态迁移为调度器任意选择一个线程执行一步
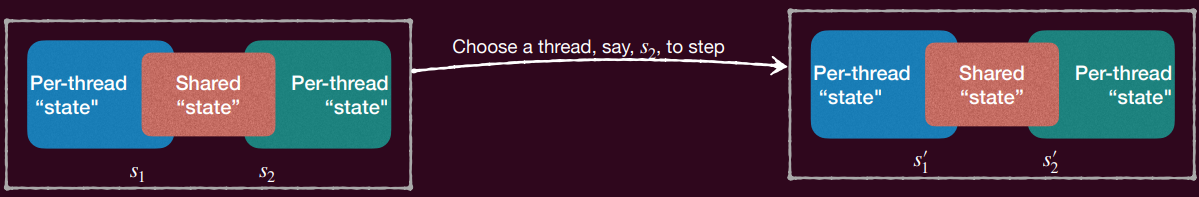
值得注意的是:虽然这里是
thread2执行一步 \(s_2 \to s_2'\),然而这个状态变化可能包括共享状态,因此可能顺着带着改变了thread1的状态 \(s_1 \to s_1'\)。这里和以往地方不同的地方在于,thread1并没有主动“求变”,而是其不知道的情况下发生了改变!
- Posix 基本线程 API:
| Thread call | 描述 |
|---|---|
pthread_create(pthread_t * thread, const pthread_attr_t * attr, void * (*start_routine) (void*), void * arg) |
创建一个线程thread,其将以实参(arg)运行函数(start_routine)。attr是这个线程的属性,默认为NULL,可以通过pthread_attr_init函数来初始化属性如栈大小、优先级等。 |
pthread_exit(void *retval) |
在线程调用这个函数时,结束自己这个线程,并向pthread_join自己的线程返回值retval。(注:即使不调用该函数,start_routine结束时该线程也结束,并向pthread_join自己的线程返回return语句的值) |
pthread_join(pthread_t thread, void **retval) |
(阻塞自己)等待线程thread结束,thread返回的值将被放到retval所指定的内存 |
pthread_yield |
放弃当前CPU的使用 (现在已经Deprecated了,推荐使用sched_yield) |
pthread_detach(pthread_t thread) |
使线程thread不被别的进程join,即使主进程结束也不被杀死,例子:pthread_detach(pthread_self()); → 使自己“脱缰” |
- 线程的一生经历初始化、就绪、运行、等待和结束的周期
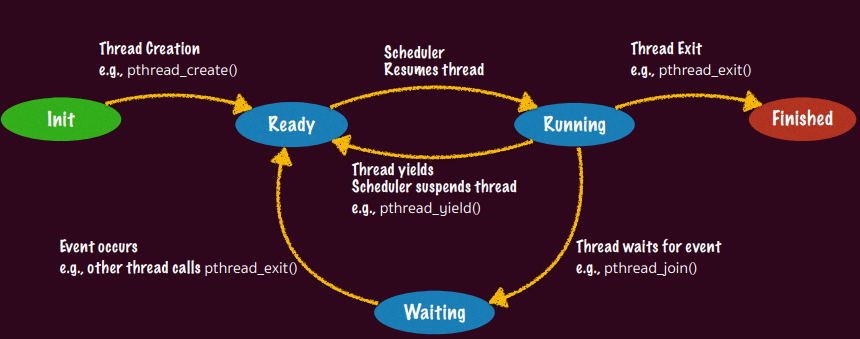
- 只有在运行阶段,其 Context 才会在 CPU 上,其余都在内核栈上,当线程处于就绪阶段时其 TCB 在 OS 维护的 ready 列表上等待调度,当线程处于等待阶段时,其 TCB 在 OS 维护的同步等待列表上等待同步事件发生
#include <pthread.h>
#include <stdio.h>
#include <stdlib.h>
#define NUMBER_OF_THREADS 10
void *print_hello_world(void *tid){
    printf("Hello World. Greetings from thread %d\n", tid);
    pthread_exit(NULL);
}

int main(int argc, char *argv[]) {
    pthread_t threads[NUMBER_OF_THREADS];
    int status, i;
    for(i=0; i < NUMBER_OF_THREADS; i++){
        printf("Main here. Creating thread %d\n", i);
        status = pthread_create(&threads[i], NULL, print_hello_world, (void *)i);
        if (status != 0) {
            printf("Oops. pthread_create returned error code %d\n", status);
            exit(-1);
        }
    }
    // 如果主线程不调用 pthread_join 等待子线程
    // 主线程很可能会在子线程完成打印之前就执行完毕并退出
    // 操作系统会销毁该进程的整个地址空间,未运行完毕的子线程就会被直接 “强制抹杀”
    for(i=0; i < NUMBER_OF_THREADS; i++){
        pthread_join(threads[i], NULL);
    }
}
// 输出极大概率是乱序的
不确定的线程调度,以及可能 “被迫” 改变的线程状态(由于共享内存),会使得程序非常容易出现 BUG,并且这些 BUG 往往很微妙、难以捉摸(不是每一次执行都能确定捕捉)
Heisenbugs 的三个根因:
- 原子化丧失
- 顺序化丧失
- 全局一致性丧失
2 原子性丧失
一个原子性的操作即是一个在其 “更高” 的层面上无法感知到它的实现是由多个部分组成的,一般来说,其具有两个属性:
- [All or nothing]:一个原子性操作要么会按照预想那样一次全部执行完毕,要么一点也不做,不会给外界暴露中间态
- [Isolation]:一个原子性的操作共享变量时中途不会被其他操作干扰,其他所有关于这个共享变量的操作要么在这个原子性操作之前,要么在其之后
#define N 100000000
#define NUMBER_OF_THREADS 2

long sum = 0;

void *T_sum(void* nothing) {
    for (int i = 0; i < N; i++) {
        sum++;
        // mov  $sum, %rax
        // add  1, %rax
        // mov  %rax, $sum
    }
}

int main() {
    pthread_t threads[NUMBER_OF_THREADS];

    pthread_create(&threads[0], NULL, T_sum,  NULL);
    pthread_create(&threads[1], NULL, T_sum,  NULL);

    for (int i=0; i < NUMBER_OF_THREADS; i++){ pthread_join(threads[i], NULL);}

    printf("sum = %ld\n", sum);
    printf("2*n = %ld\n", 2L * N);
}
// 输出 sum 会远小于 2 亿
- 原子性丧失:[All or nothing] 违背
| 时间 | 线程1操作 | 线程2操作 | sum内存值 |
|---|---|---|---|
| 1 | mov $sum, %rax | - | 0 |
| 2 | - | mov $sum, %rax | 0 |
| 3 | add 1, %rax | - | 0 |
| 4 | - | add 1, %rax | 0 |
| 5 | mov %rax, $sum | - | 1 |
| 6 | - | mov %rax, $sum | 1 |
我们知道 sum++ 分为三步:读 (Read) -> 加 (Add) -> 写 (Write)。
-
第 1 步:线程 A 读取并被挂起 线程 A 开始它的第 1 次循环,从内存中读取
sum的初始值0到 CPU 的寄存器中。就在这时,操作系统剥夺了线程 A 的 CPU 时间片,线程 A 被挂起。 (当前状态:内存 sum=0;线程 A 寄存器=0,剩余 99,999,999 次循环) -
第 2 步:线程 B 疯狂狂奔 线程 B 获得 CPU,并且调度器极其偏心,让线程 B 一口气疯狂执行完了前
N-1(即 99,999,999)次完整的循环。 (当前状态:内存 sum=99,999,999;线程 B 剩余 1 次循环) -
第 3 步:线程 A 苏醒,造成“一血”覆盖 线程 A 被唤醒,继续它被打断的动作:把寄存器里的
0加1,然后把1写回内存。 灾难发生: 线程 B 辛辛苦苦算出来的 99,999,999 瞬间被线程 A 强行覆盖成了1。 (当前状态:内存 sum=1;线程 A 完成了 1 次循环,剩余 99,999,999 次) -
第 4 步:线程 B 读取最后一次并被挂起 线程 B 开始它的最后 1 次循环。它从内存中读取
sum的当前值1到自己的寄存器中。紧接着,线程 B 再次被挂起。 (当前状态:内存 sum=1;线程 B 寄存器=1,剩余 0 次读取,仅剩最后的加和写) -
第 5 步:线程 A 完成所有剩余工作 线程 A 再次苏醒,这次没有被打断,一口气完成了它剩下的 99,999,999 次完整循环。它在
sum=1的基础上不断累加,最终把内存里的sum变成了100,000,000。此时,线程 A 彻底运行结束。 (当前状态:内存 sum=100,000,000;线程 A 已结束) -
第 6 步:线程 B 的“终极绝杀” 线程 B 苏醒,完成它生命中的最后一个动作。它将自己寄存器中保存的
1加上1得到2,然后将2强势写回内存,覆盖掉了线程 A 留下的 1 亿。线程 B 运行结束。
全剧终,最终内存中 sum 的定格值为:2。
如果要让最后的结果为 1,那么执行最后一次写入操作的线程,必须在它的最后一次循环中读到 0。
然而,全局只有在程序最开始的那一瞬间 sum 才是 0。如果一个线程在最开始读到了 0,哪怕它拖延到世界末日再把 1 写回内存,写完之后,它自己必定还剩下 N-1 次循环没有执行。等它把剩下的循环执行完,最终结果必然会被推高到 1 亿以上。
因此,2 是在两个线程互相踩踏下能达到的理论数学下界。
结论拓展
在这个剧本中,无论你增加多少个线程,只要把它们全部安排在第 5 步去疯狂输出并正常死亡,最后由一直潜伏在第 4 步的线程 B 醒来完成最后一次写入,所有其他线程的计算成果都会被降维打击,最终结果牢牢钉死在 2。
- 即使我们强制让
sum++变成一个 “单个指令” 结果仍然不对
#define N 100000000
#define NUMBER_OF_THREADS 2

long sum = 0;

void *T_sum(void* nothing) {
    for (int i = 0; i < N; i++) {
        asm volatile("incq %0": "+m"(sum)); // 单个指令
    }
}

int main() {
    pthread_t threads[NUMBER_OF_THREADS];
    pthread_create(&threads[0], NULL, T_sum, NULL);
    pthread_join(threads[0], NULL);

    printf("sum = %ld\n", sum);
    printf("2*n = %ld\n", 2L * N);
}
- 原子性丧失:[Isolation] 违背
- 竞争同一个 data(data race)
- 可能发生一个线程先做这个指令,但中途(thread1 还没做完)另一个线程也做这个指令,最终导致 sum 的增加不对
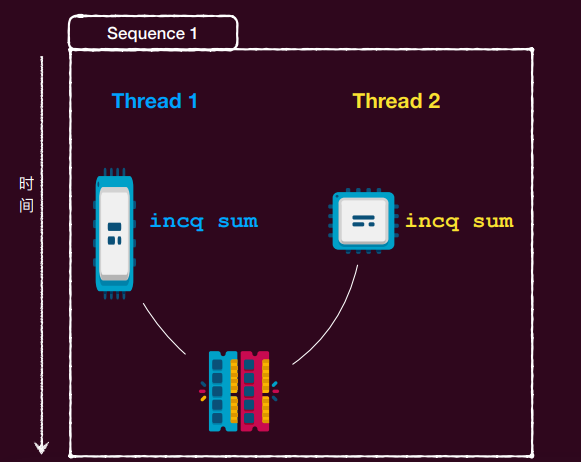
原子性的丧失:
- 单处理器多线程
- 线程在运行时可能被中断,切换到另一个线程执行([All or nothing]无法保证)
- 多处理器多线程
- 线程根本就是并行执行的([All or nothing] 和 [Isolate] 都无法保证)
- 互斥和原子性是本学期的重要主题
lock(&lk)unlock(&lk)- 实现临界区之间的绝对串行化
- 程序的其他部分依然可以并行执行 此外,操作系统需要维护一个 “并发” 队列,worker thread 选择队列中的进程进入临界区
3 顺序性丧失
- 顺序性:
- 程序语句按照既定的顺序执行!
- 然而,只要不影响语义,其实指令是否按照顺序执行并不重要
- 编译器就会通过 reorder instructions 来优化程序
- 这些优化在单线程下往往没有问题,但一旦到了多线程,很多逻辑就错了
控制执行顺序:
- 方法 1: 在代码中插入 “优化不能穿越” 的 barrier
- asm volatile (“” ::: “memory”);
- Barrier 的含义是告诉编译器这里 “可以读写任何内存”
- 方法2: 使用volatile变量,标记其每次load/store为不可优化
- bool volatile flag;
4 全局一致性丧失
4.1 内存一致性模型*
- 现代处理器往往允许指令乱序执行(编译器是将原始执行语句打乱,处理器本身面对指令序列进行乱序执行)
- 比如对于高时延的访存指令(如cache miss),处理器可以选择调度后续其他指令执行,从而隐藏访存操作的时延
- 然而这种乱序会导致多个处理器看到不一致的访存顺序!
- 内存一致性模型(简称内存模型)明确定义了不同核心对于共享内存操作需要遵循的顺序
4.2 顺序一致性模型
顺序一致性模型提供了以下保证:
- 首先,不同核心看到的访存操作顺序完全一致,这个顺序称为全局顺序
- 其次,在这个全局顺序中,每个核心自己的读写操作可见顺序必须与其程序顺序保持一致
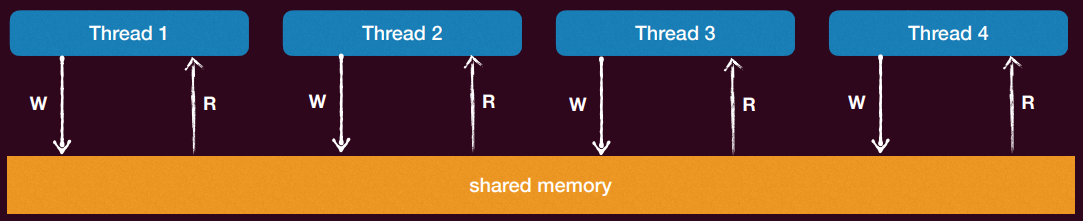
可以看成一个 “时间单位” 上只能选择一个线程读或写共享内存一次,最终形成一个统一的全局的访问内存的顺序
int x = 0, y = 0;

void T1() {
    x = 1;  // Store(x);
    __sync_synchronize(); // a barrier
    int t = y; // Load(y)
    printf("%d", t);
}

void T2() {
    y = 1;
    __sync_synchronize();
    int t = x;
    printf("%d", t);
}
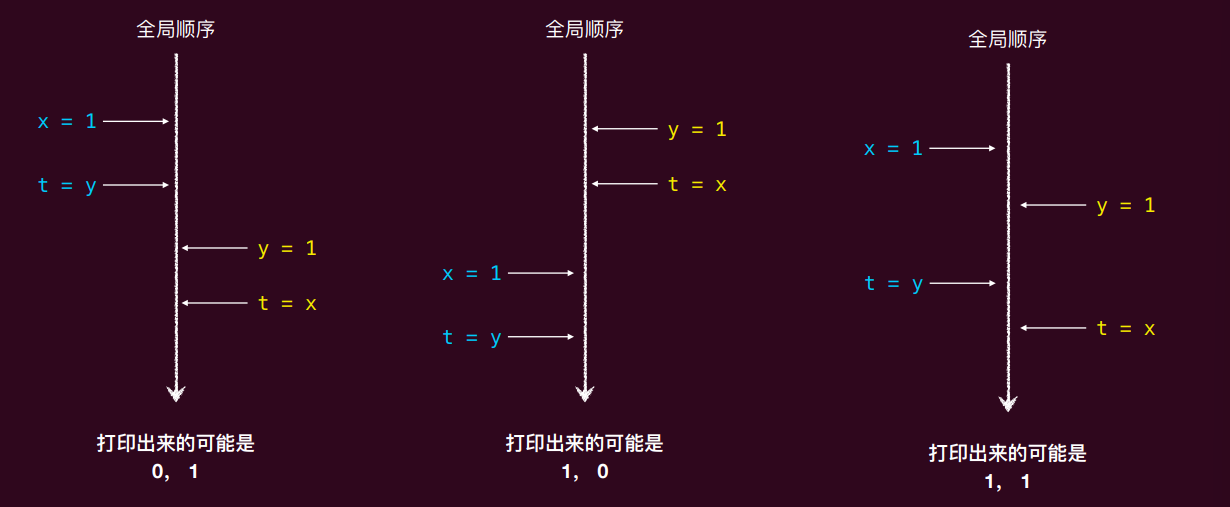
事实上,目前市面上已经没有支持顺序一致性模型的 CPU 了
4.3 TSO(Total Store Ordering)内存模型*
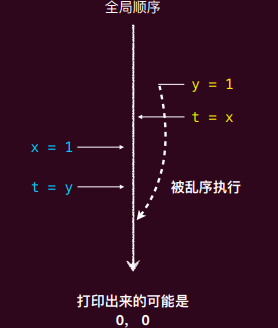
线程 1 看到线程 2 是先读 x,然后写 y,但对于线程 2 而言,其是先执行写 y,然后再读 x(虽然这个顺序被处理器打乱了,因为处理器觉得两个顺序不重要,x 和 y 不存在依赖),因此不再一致
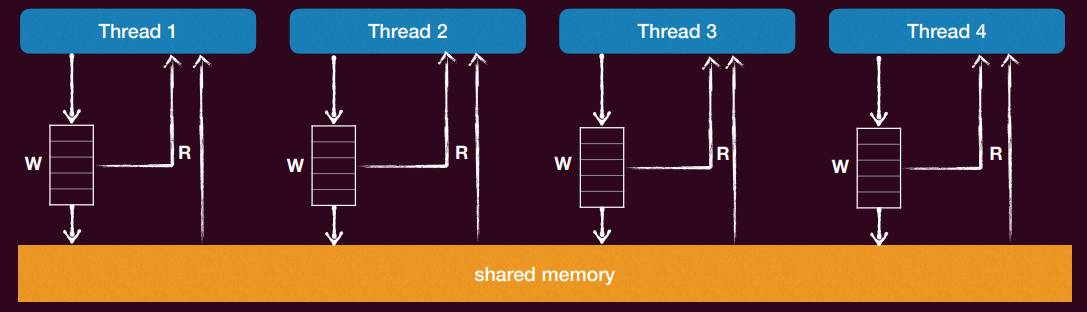
- 图中每个 Thread 下面都有一个写缓冲区
- 直接把数据写回到主存太慢了
- 当 CPU 执行写操作 时,它只是把数据丢进自己的 Store Buffer,然后立刻去执行下一条指令
- 破解 0,0 谜题的根源:
- 当线程 1 把
x=1放到自己的 Store Buffer 时,这个值对其他线程是不可见的,主存里 x 依然是 0。 - 此时,线程 1 继续往下执行
t=y。它去主存里读 y,读到了 0。 - 同理,线程 2 把
y=1放到自己的缓冲,去主存读 x,也读到了 0。 - 只有在未来的某个时刻,Store Buffer 里的数据才会被“刷”(Flush)到主存中。
- 当线程 1 把
- “一个处理器会比其他处理器更早看到自己的写”
这叫 Store Forwarding。如果线程 1 写了
x=1到缓冲区,紧接着它自己又去读x,它会先查自己的缓冲区,发现有 1,就直接用。但如果是线程 2 来读x,它只能看主存,看到的还是 0。
保证 读-读、读-写、写-写 的顺序不乱 唯一不保证的,就是“写-读”的全局可见顺序
4.4 宽松内存模型(Relaxed Memory Model)
- 不保证任何不同地址且无依赖的访存操作之间的顺序,也即读读,读写,写读与写写操作之间都可以乱序全局可见
#define NOT_READY 0;
#define READY 1;
int data = 0;
int flag = NOT_READY;

void thread_A(void){
    data = 123;
    // __sync_synchronize() // 插入这个才能使得宽松内存模型正确
    flag = READY;
}

void thread_B(void)
{
    while(flag != READY) ; /* 循环忙等 */
    handle(data);
}
基于共享内存的消息传递机制
- 在 TSO 下:完美运行
- 因为 x86 保证 “写-写” 不乱序。
data = 123一定会比flag = READY先写入主存。只要 Thread_B 看到了旗帜升起,主存里的data就必定已经是 123 了。。
- 因为 x86 保证 “写-写” 不乱序。
- 宽松模型下:灾难发生
- 由于允许 “写-写” 乱序,CPU 或者内存系统可能会觉得
flag = READY这条指令更容易执行,于是把它插队到了data = 123前面。
- 由于允许 “写-写” 乱序,CPU 或者内存系统可能会觉得
- 并发的基本单位是线程
- 即共享部分内存的状态机(有自己的私有状态)
- 其状态的变化可以随着另外的进程的 “步进” 而被动改变
- Posix 提供的标准多线程编程库 Pthread
- 多处理器编程充满挑战,数据竞争下难以保障正确
- 原子性、顺序性和全局一致性都会丧失
标题:多处理器编程
作者:Zwing
创建于:2026-08-09 00:14:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/并发-多线程编程入门.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可