
同步
为了达成/避免一些状态,我们需要线程受控制
- 同步(Synchronization)
- 控制并发,使得 “两个或两个以上随时间变化的量在变化过程中保持一定的相对关系”
- 互斥也是一种同步
int x = 0, y = 0;

void T1() {
    lock(); x = 1; unlock(); lock(); int t = y; unlock();
}

void T2() {
    lock(); y = 1; unlock(); lock(); int t = x; unlock();
}
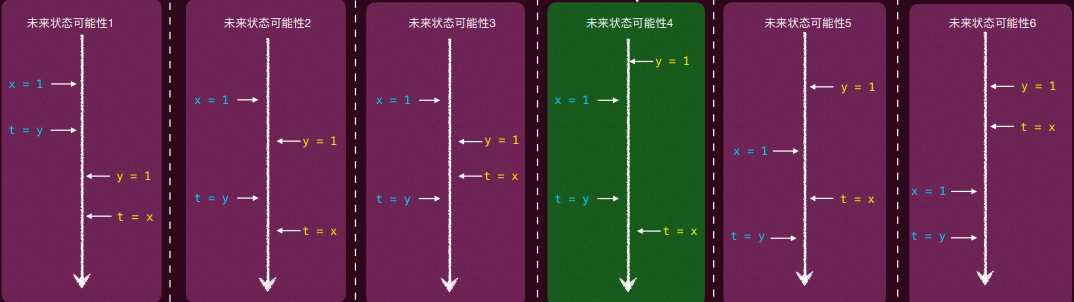
无法实现只想要进入某个状态,简单的互斥(加锁、解锁)并不能控制线程的执行顺序
1 生产者-消费者问题
- 一个或多个线程共享一个数据缓冲区问题,该缓冲区容量有上限(有界缓冲区)
- 线程分为两类:一类生产数据(生产者),一类消费数据(消费者)
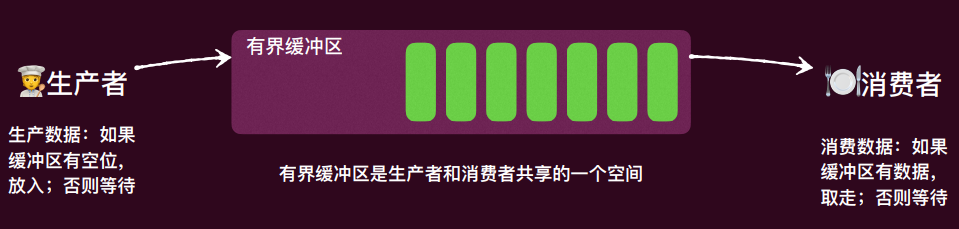
生产 = 打印左括号 (push into buffer) 消费 = 打印右括号 (pop from buffer) 缓冲区:括号的嵌套深度
1.1 没学过并发编程的尝试
int n; //缓冲区大小
int depth = 0; //当前使用了多少空间

void produce() {
    while(1) {
    retry:
        int ready = (depth < n); //是否还有空间
        if (!ready) goto retry; //没有空间,自旋等待

        printf(" "); //只有还有空间才能打印
        depth++; //打印之后,缓冲区使用的空间加一
    }
}

void consume() {
    while(1) {
    retry:
        int ready = (depth > 0); //是否有数据
        if (!ready) goto retry; //没有数据,自旋等待

        printf(" "); //有数据才能打印
        depth--; //打印之后,缓冲区使用的空间减一
    }
}
- 该尝试显然是错的,因为共享变量
depth的访问部分是临界区代码,应该用互斥锁保护,否则出现竞态条件,违背安全性
1.2 生产者-消费者问题解决尝试 1
- 利用互斥锁保护共享变量
depth,使其访问都是原子的
void produce() {
    while(1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth < n);
        mutex_unlock(&lk);
        if (!ready) goto retry;
        // 此时的 ready 为 true 的话, depth < n 一定 hold 的吗?不一定!
        // 语句 mutex_unlock(&lk); 和 if (!ready) 之间可能 depth 已经被别的线程篡改了

        mutex_lock(&lk);
        printf(" ");
        depth++;
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth > 0);
        mutex_unlock(&lk);
        if (!ready) goto retry;

        mutex_lock(&lk);
        printf(")");
        depth--;
        mutex_unlock(&lk);
    }
}
1.3 生产者-消费者问题解决尝试 2
- 之前的问题在于
unlock和再次判断可能被打扰,那直接把unlock推迟 - 虽然正确,但是会有性能问题
void produce() {
    while(1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth < n);

        // 分支 1,不满足,先释放锁再自旋
        if (!ready) {
            mutex_unlock(&lk);
            goto retry;
        }

        // 分支 2,满足,先生产后释放锁
        printf("(");
        depth++;
        mutex_unlock(&lk);
    }
}

void consume() {
    while (1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth > 0);
        if (!ready) {
            mutex_unlock(&lk);
            goto retry;
        }
        printf(")");
        depth--;
        mutex_unlock(&lk);
    }
}
1.4 生产者-消费者问题解决尝试 3
- 解决这个性能问题的方法我们也已经知晓:利用操作系统的调度进行阻塞(wait)和唤醒(wakeup)
void produce() {
    while(1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth < n);
        if (!ready) {
            mutex_unlock(&lk); // 老问题,唤醒会丢失
            wait(&producer_waiting_list);
            goto retry;
        }
        printf("(");
        depth++;
        wakeup(&consumer_waiting_list);
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
    retry:
        mutex_lock(&lk);
        int ready = (depth > 0);
        if (!ready) {
            mutex_unlock(&lk);
            wait(&consumer_waiting_list);
            goto retry;
        }
        printf(")");
        depth--;
        wakeup(&producer_waiting_list); // 老问题,唤醒会丢失
        mutex_unlock(&lk);
    }
}
| 时间 | 生产者 | 消费者 |
|---|---|---|
| 1 | if (!ready) 缓冲区满,需自旋 |
|
| 2 | mutex_unlock(&lk);释放锁 |
|
| 3 | mutex_lock(&lk);…depth--; 拿锁并消费 |
|
| 4 | wakeup(&producer_waiting_list);唤醒丢失 |
|
| 5 | wait(&producer_waiting_list); 死锁 |
1.5 生产者-消费者问题解决尝试 4
- 采用 futex 解决唤醒丢失问题
- 释放锁和进入休眠必须是绑在一起的原子操作
- 条件变量
int cnd1 = 0; // 生产者能够生产的条件
int cnd2 = 0; // 消费者能够生产的条件

void produce() {
    while(1) {
        retry:
            mutex_lock(&lk);
            int ready = (depth < n);
            if (!ready) {
                int val = cnd1;         // <-- 约束
                mutex_unlock(&lk);
                // 如果这中间发生了改变,就不休眠
                futex_wait(&cnd1, val); // <-- 约束
                goto retry;
            }
        printf("(");
        depth++;
        atomic_add(&cnd2, 1);
        futex_wake(&cnd1); // 唤醒生产者
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
        retry:
            mutex_lock(&lk);
            int ready = (depth > 0);
            if (!ready) {
                int val = cnd2;
                mutex_unlock(&lk);
                futex_wait(&cnd2, val);
                goto retry;
            }
        printf(")");
        depth--;
        atomic_add(&cnd1, 1);
        futex_wake(&cnd1); // 唤醒消费者
        mutex_unlock(&lk);
    }
}
1.6 条件变量
条件变量:用于标记某个用于同步条件的变量,其有两个相关的操作:
cond_wait(cond_t *cv, mutex_t *lk)- 调用之前默认假设
lk已经持有锁lk - 调用之后原子的阻塞线程和释放锁
- 被唤醒时重新抢锁
- 调用之前默认假设
cond_signal(cond_t *cv)- 唤醒一个等在条件变量
cv上的一个阻塞线程 - 如果没有线程阻塞在这个条件变量上,什么也不做
- 唤醒一个等在条件变量
#include <pthread.h>

pthread_cond_t cv;
int pthread_cond_init(pthread_cond_t *cv, NULL);
int pthread_cond_destroy(pthread_cond_t *cv);

int pthread_cond_wait(pthread_cond_t *cv, pthread_mutex_t *mutex);
int pthread_cond_signal(pthread_cond_t *cv);
- 条件变量有两个相关操作的实现
typedef struct conditional_variabie {
    unsigned value;
} cond_t;

void cond_wait(cond_t *cv, mutex_t *lk) {
    int val = atomic_load(&cv->value);

    mutex_unlock(lk);
    futex_wait(&cv->value, val);
    mutex_lock(lk); // 回来后仍认为我自己持有锁
}

void cond_signal(cond_t *cv) {
    atomic_fetch_add(&cv->value, 1);
    futex_wake(&cv->value);
}
- 使用条件变量解决之前的生产者-消费者问题
cond_t cv_p = COND_INIT();
cond_t cv_c = COND_INIT();
mutex_t lk = MUTEX_INIT();

void produce() {
    while(1) {
        mutex_lock(&lk);
        if (!(depth < n)) {
            cond_wait(&cv_p, &lk);
        }

        printf("(");
        depth++;
        cond_signal(&cv_c); // 唤醒生产者
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
        mutex_lock(&lk);
        if (!(depth > 0)) {
            cond_wait(&cv_c, &lk);
        }

        printf(")");
        depth--;
        cond_signal(&cv_p); // 唤醒消费者
        mutex_unlock(&lk);
    }
}
考虑如下情况:一个生产者,两个消费者 \(C_1,C_2\),首先消费者 \(C_1\) 等待一个空的 buffer,然后生产者生产一个数据,调用唤醒函数唤醒 \(C_1\),但此时如果 \(C_2\) 抢先一步进入临界区,并消费掉了数据后返回,然后 \(C_1\) 才被真正唤醒进入临界区,但此时,临界区已经没有数据可以消费了,错误!
1.7 Hansen/Mesa VS Hoare
产生上述问题的原因是由于调用 Signal 通知某个线程,和那个线程 wait 被唤醒不是原子的,这就是 Hansen (or Mesa) 语义
与之相对的,cond_signal 和 cond_wait 之间是原子的则称为 Hoare 语义
cond_signal程序将互斥锁转移到被唤醒的程序,并阻塞自己(只有等被唤醒的程序返回或者再次阻塞才会返回该 signal 线程,当然互斥锁也需要一并转移回它),因此其他线程无法再进入临界区
Hoare 语义下的线程能够在唤醒后知道其所期待的那个条件一定成立,这个性质由原子性保证,也就是因为这个原因,在 Hoare 语义下其实之前的解决方案是正确的
- Hoare 语义下很多程序性质非常容易证明,但不要实现 Hoare 语义是复杂的
- Hansen/Mesa 虽然不保证安全性,但是实现简单(原子性不保证是自然的,无需调度器做出任何承诺)
Hansen/Mesa 语义下的解决办法:唤醒后重新尝试判断条件是否满足,即判定条件那里使用 while,而不是 if,这也是为什么之前的尝试需要反复 goto retry 的原因
void produce() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth < n)) { // <--
            cond_wait(&cv_p, &lk);
        }

        printf("");
        depth++;
        cond_signal(&cv_c); // 唤醒生产者
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth > 0)) { // <--
            cond_wait(&cv_c, &lk);
        }

        printf("");
        depth--;
        cond_signal(&cv_p); // 唤醒消费者
        mutex_unlock(&lk);
    }
}
1.8 考虑使用一个变量
void produce() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth < n)) {
            cond_wait(&cv, &lk);
        }
        printf("(");
        depth++;
        cond_signal(&cv);
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth > 0)) {
            cond_wait(&cv, &lk);
        }
        printf(")");
        depth--;
        cond_signal(&cv);
        mutex_unlock(&lk);
    }
}
考虑如下情形:
- 有三个线程:消费者 \(C_1\)、\(C_2\) 和生产者 \(P_1\),此时 \(C_1\)、\(C_2\) 首先依次进入临界区,发现数据为空,都阻塞等待
- 然后 \(P_1\) 进入临界区,生产一个 item 之后唤醒一个线程,如 \(C_1\),在 \(C_1\) 唤醒之前,\(P_1\) 再次抢先一步进入临界区,发现没有空闲(假设缓冲区为 1),阻塞自己
- \(C_1\) 此时醒了并进入临界区,消费了这个数据之后,试图唤醒其他线程,但唤醒谁是没有保障的(因为都是同一个条件变量)
- 如果唤醒的是 \(C_2\),那么 \(C_2\) 进入临界区,发现数据为空,阻塞等待,然后 \(C_1\) 也尝试进入临界区,阻塞等待,而 \(P_1\) 没人唤醒它,也处于阻塞等待状态
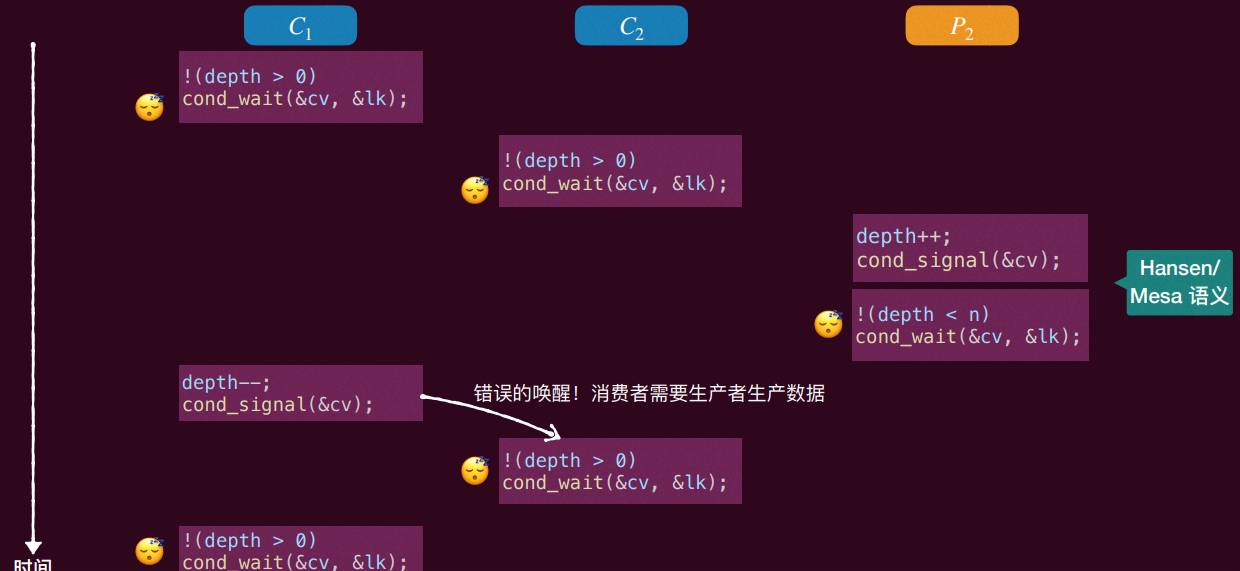
多个条件变量使得可以合理的 signal 相应的线程,但设计复杂,单个条件变量逻辑上又会出错,有没有比较好的办法
- 力大砖飞(条件覆盖):
cond_broadcast(cond_t *cv)一次唤醒所有线程即可,那些需要被正确唤醒的自然会醒来做相应的事情,而那些不该唤醒的,反正需要 while 循环一次在此判定是否符合条件,不符合条件就再 “睡” 即可,因此不会影响正确性 - Posix 版本:
int pthread_cond_broadcast(pthread_cond_t *cv);
条件覆盖下的生产者-消费者解决方案:
void produce() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth < n)) {
            cond_wait(&cv, &lk);
        }

        printf("(");
        depth++;
        cond_broadcast(&cv); // <--
        mutex_unlock(&lk);
    }
}

void consume() {
    while(1) {
        mutex_lock(&lk);
        while(!(depth > 0)) {
            cond_wait(&cv, &lk);
        }

        printf(")");
        depth--;
        cond_broadcast(&cv); // <--
        mutex_unlock(&lk);
    }
}
[!summary] 条件变量的使用经验法则
- 除了条件变量外,还得有共享的状态用来进行判定是否可以 “生产” 或者 “消费”
- 使用互斥锁来保护共享的状态以及条件变量的操作
- 在做 wait/signal/broadcast 时需要持有互斥锁
- 每次从 wait 中唤醒,要重新进行条件检查(wait within a while loop)
- 针对不同的条件使用不同的条件变量(除非使用 broadcast)
2 条件变量的应用
2.1 利用计算图进行并行化
找到程序算法中的计算依赖图,就可以利用 wait 和 signal 来将算法进行并行化
- 定义计算图 \(G = (V, E)\),其中 \(V\) 是计算事件集,\((u, v) \in E\) 意味着计算事件 \(u\) 一定要在 \(v\) 之前,即 \(v\) 需要用到 \(u\) 的计算结果,\(u\) 和 \(v\) 只能串行执行,没有依赖关系(没有从 \(u\) 到 \(v\) 的路径)的可以并行计算
- 给定一个 \(G\)(给定一个问题,首先构建出这样一个图),为每个节点(对应一个线程)完成如下设置
- \(v\) 节点能进行计算所需要 \(\texttt{wait}\) 的同步条件:每一个 \(\forall u \in V, \text{s.t. } (u, v) \in E\) 中的 \(u\) 都已经完成
- \(u\) 完成后,对 \(\forall v \in V, \text{s.t. } (u, v) \in E\) 中的 \(v\) 进行 \(\texttt{signal}\)(或者更加简单的直接用 \(\texttt{broadcast}\))
2.2 例子:编辑距离问题
for i := 0 to m
    dist[i, 0] := i
for j := 0 to n
    dist[0, j] := j
for i := 1 to m
    for j := 1 to n
        delDist := dist[i - 1, j] + 1
        insDist := dist[i, j - 1] + 1
        subDist := dist[i - 1, j - 1] + Diff(A[i], B[j])
        dist[i, j] := Min(delDist, insDist, subDist)
return dist
- 考虑 \(dist(i,j)\) 依赖于那些计算的解?\(dist(i-1,j)\)、\(dist(i,j-1)\) 和 \(dist(i-1,j-1)\)
- 每一条斜边的节点都是可以其上一轮斜边对应的节点做完之后就可以继续做了(当然,是否为每个节点都设置一个线程具有性能上的考量,线程太多会增加调度成本,线程太少,并发度小)
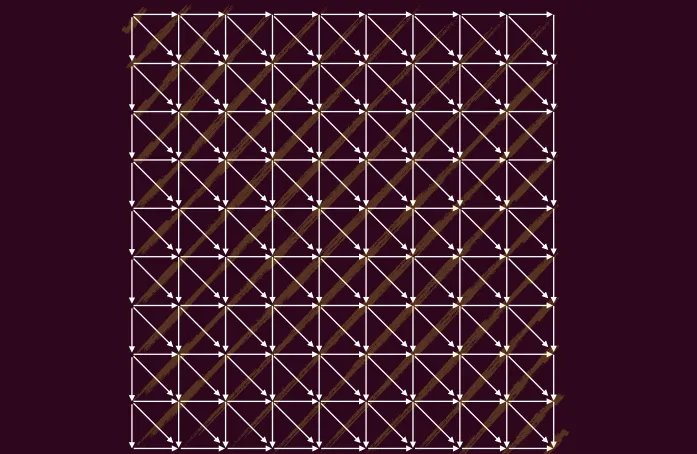
2.3 一个比较通用的并发算法设计框架
- (生产者)可以把调度的事情全部分给一个线程,而不是一次性把所有线程都直接放进内存,这个调度线程维护一个计算图,每次都会根据当前已经做完的计算机点,和依赖关系,调度可以运行的线程,把他们放进 ready 列表准备运行(这就是线程池)
- (消费者)被调度的运行的线程就执行计算,计算结束后通知调度线程,告知条件可能发生变化,可以重新计算下一批就可以计算的线程
void T_worker() {
    while (1) {
        consume().run();
    }
}

void T_scheduler() {
    while (!jobs.empty()) {
        for (auto j : jobs.find_ready()) {
            produce(j);
        }
    }
}
一个更加复杂的例子:打印 fish
- 有三种线程
- \(T_a\) 若干: 无限循环打印
< - \(T_b\) 若干: 无限循环打印
> - \(T_c\) 若干: 无限循环打印
-
- \(T_a\) 若干: 无限循环打印
- 任务:对线程同步,使得屏幕打印出
<><_和><>_的组合 - 解决方案:使用条件变量,只要回答三个问题
- 打印 “<” 的条件?打印 “>” 的条件?打印 “_” 的条件?
- 引入 “有限状态机”
- 判断上述三个 “条件” 是否成立的依据,是当前屏幕已经打印了什么字符
- 状态机的转换逻辑正是编写条件变量判断语句的基础
当前状态 state |
当前已打印前缀 | 允许被唤醒的线程 (打印字符) | 打印后的新状态 |
|---|---|---|---|
| 0 (初始) | (空) | T_a 打印 < |
变为 1 |
| 0 | (空) | T_b 打印 > |
变为 4 |
| 1 | < |
T_b 只能打印 > |
变为 2 |
| 2 | <> |
T_a 只能打印 < |
变为 3 |
| 3 | <>< |
T_c 只能打印 _ |
变为 0 (完成) |
| 4 | > |
T_a 只能打印 < |
变为 5 |
| 5 | >< |
T_b 只能打印 > |
变为 6 |
| 6 | ><> |
T_c 只能打印 _ |
变为 0 (完成) |
mutex mtx;                 // 互斥锁,保护共享资源 state
condition_variable cv;     // 条件变量,用于线程间的阻塞与唤醒
int state = 0;             // 共享变量:当前的状态机状态

// 线程 Ta: 专门打印 "<"
void print_less_than() {
    while (true) {
        unique_lock<mutex> lock(mtx);

        // 核心:打印 "<" 的条件是什么?
        // 只有当状态为 0, 2, 4 时,才允许打印 "<",否则线程在此阻塞等待
        cv.wait(lock, [] { return state == 0 || state == 2 || state == 4; });

        cout << "<";

        // 根据当前状态,推进到下一个状态
        if (state == 0) state = 1;
        else if (state == 2) state = 3;
        else if (state == 4) state = 5;

        // 状态已改变,唤醒其他可能在等待的线程
        cv.notify_all();
    }
}

// 线程 Tb: 专门打印 ">"
void print_greater_than() {
    while (true) {
        unique_lock<mutex> lock(mtx);

        // 核心:打印 ">" 的条件是什么?
        // 只有当状态为 0, 1, 5 时,才允许打印 ">",否则线程阻塞
        cv.wait(lock, [] { return state == 0 || state == 1 || state == 5; });

        cout << ">";

        // 状态转移
        if (state == 0) state = 4;
        else if (state == 1) state = 2;
        else if (state == 5) state = 6;

        cv.notify_all();
    }
}

// 线程 Tc: 专门打印 "_"
void print_underscore() {
    while (true) {
        unique_lock<mutex> lock(mtx);

        // 核心:打印 "_" 的条件是什么?
        // 只有当状态为 3 ("<><") 或 6 ("><>") 时,才允许收尾
        cv.wait(lock, [] { return state == 3 || state == 6; });

        cout << "_" << endl; // 打印下划线并换行,方便观察

        // 一条鱼打印完毕,状态重置为 0,开始新一轮
        state = 0;

        cv.notify_all();
    }
}

int main() {
    // 创建若干个线程来模拟混乱的并发环境
    vector<thread> threads;

    // 比如:各创建 3 个只会死循环打印自己字符的线程
    for (int i = 0; i < 3; ++i) {
        threads.push_back(thread(print_less_than));
        threads.push_back(thread(print_greater_than));
        threads.push_back(thread(print_underscore));
    }

    // 主线程等待所有子线程结束 (虽然这里是死循环不会结束)
    for (auto& t : threads) {
        t.join();
    }

    return 0;
}
3 信号量
- 条件变量是无记忆的,因此需要程序员手动进行额外的条件判定
- 一个很自然的需求就是能否有一个同步原语能够自带 “状态”,然后根据预设好的约定,“状态” 不满足就阻塞,否则就唤醒
- 一个自带 “整数” 状态的同步原语就是信号量
信号量代表着一个整数值变量,只能通过两个原子操作能够改变这个变量:
P(sem_t *sem)也写作 decrease/down/wait/acquire- 如果
sem的值不是正数就阻塞自己,否则将sem的值减一后返回运行
- 如果
V(sem_t *sem)也写作 increase/up/post/signal/release- 将信号量
sem的值加 1,如果有一个或多个线程阻塞在这个信号量上,选择一个唤醒
- 将信号量
#include <semaphore.h>
sem_t sem;
int sem_init(sem_t *sem, int pshared, unsigned int value);
int sem_destroy(sem_t *sem);
int sem_wait(sem_t *sem);
int sem_post(sem_t *sem);
3.1 信号量的一种实现
- 利用互斥锁和条件变量的一种信号量实现
typedef struct _sem_t {
    int value;
    pthread_cond_t cond;
    pthread_mutex_t lock;
} sem_t;

// only one thread can call this
void sem_init(sem_t *s, int value) {
    s->value = value;
    cond_init(&s->cond);
    mutex_init(&s->lock);
}

void sem_wait(sem_t *s) {
    mutex_lock(&s->lock);
    while (s->value <= 0)
        cond_wait(&s->cond, &s->lock);
    s->value--;
    mutex_unlock(&s->lock);
}

void sem_post(sem_t *s) {
    mutex_lock(&s->lock);
    s->value++;
    cond_signal(&s->cond);
    mutex_unlock(&s->lock);
}
3.2 信号量的使用
信号量是非常易用的同步原语,可以非常容易实现互斥和控制顺序
- 比如实现互斥(二值信号量)
sem_t sem;
// set sem intial value to be X, X = 1
sem_init(sem_t &sem, 0, X);
void func() {
    P(&sem);
    // critical section
    V(&sem);
    // reminder section
}
- 实现顺序控制:下面程序使得 \(T_1\) 得等 \(T_2\) 完成之后才能继续
// T1
sem_t sem;
int main(int argc, char *argv[]) {
  //set sem intial value to be X, X = 0
  sem_init(sem_t &sem, 0, X);
  pthread_t c;
  create_thread(&c, child);
  // wait for thread
  P(&sem);
  do_something();
  return 0;
}

// T2
void* child(void *arg) {
    do_something();
    V(&sem); // signal here: child is done
    return NULL;
}
对信号量的值赋予不同的初值可以有不同的用途
可以将这个值看成初始 “资源数”
- 初始 “资源数” 为 1,意味着互斥,只有一个能够获得这个资源,其释放这个资源,其他线程才能获取这个资源
- 初始 “资源数” 为 0,意味着阻塞,当前线程必须等待,只有未来某个线程增加一个资源,该阻塞线程才能继续行进,因此实现了顺序控制
- 更多的 “资源” 意味着当前有很多资源可以用来 “获取”,只有资源被获取完为 0,才会阻止下一个想要获取 “资源” 的线程。而只要已经获得资源的线程释放 “资源”,下一个才能获取这个释放的“资源”
- 使用
P()获取资源,使用V()增加(释放)资源
3.3 利用信号量解决生产者-消费者问题
sem_t empty; // 缓冲区有多少空位
sem_init(sem_t &empty, 0, MAX);
sem_t full;  // 缓冲区有多少资源
sem_init(sem_t &full, 0, 0);

void produce() {
    while(1) {
        P(&empty); // 减少空位
        printf("(");
        V(&full);  // 增加资源
    }
}

void consume() {
    while(1) {
        P(&full);  // 减少资源
        printf(")");
        V(&empty); // 增加空位
    }
}
P、V 操作之后都释放相应信号量里的互斥锁了,因此 P、V 操作之后的代码其实是没有锁保护的,如果之后的操作涉及共享资源(临界区),那么还要加互斥锁保护,这段代码里 printf 天生是线程安全的,所以没问题
- 使用信号量 + 互斥锁解决更加一般的生成者-消费者问题
sem_t mutex; // 用于互斥的信号量(也可以用互斥锁)
sem_init(sem_t &mutex, 0, 1);
sem_t empty; // 缓冲区有多少空
sem_init(sem_t &empty, 0, MAX);
sem_t full;  // 缓冲区有多少资源
sem_init(sem_t &full, 0, 0);

void produce() {
    while(1) {
    P(&mutex);
    P(&empty);
    produce_shared_buffer();
    V(&full);
    V(&mutex);
    }
}

void consume() {
    while(1) {
    P(&mutex); // <-- 产生死锁
    P(&full);
    consume_shared_buffer();
    V(&empty);
    V(&mutex);
    }
}
如果消费者先进行互斥,然后消费,发现没有数据,阻塞,但生产者由于互斥锁此时无法获得(把临界区堵了),无法进入临界区产生数据,因此生产者和消费者都阻塞,从而无法行进
- 正确方案:使用信号量 + 互斥锁解决更加一般的生成者-消费者问题
sem_t mutex; // 用于互斥的信号量(也可以用互斥锁)
sem_init(sem_t &mutex, 0, 1);
sem_t empty; // 缓冲区有多少空位
sem_init(sem_t &empty, 0, MAX);
sem_t full;  // 缓冲区有多少资源
sem_init(sem_t &full, 0, 0);

void produce() {
    while(1) {
    P(&empty); // 条件允许才进入临界区
    P(&mutex);
    produce_shared_buffer();
    V(&mutex);
    V(&full);
    }
}

void consume() {
    while(1) {
    P(&full);  // 条件允许才进入临界区
    P(&mutex);
    consume_shared_buffer();
    V(&mutex);
    V(&empty);
    }
}
- 使用信号量优雅地实现编辑距离算法的并行化
// 定义计算图中的任务节点
struct Task {
    int i, j;
};

const int M = 100; // 字符串 A 的长度假设
const int N = 100; // 字符串 B 的长度假设
string A, B;
int dist_matrix[M + 1][N + 1];

// 依赖图与任务状态
int in_degree[M + 1][N + 1];   // 记录每个节点的尚未完成的前置依赖数量
const int TOTAL_TASKS = M * N; // 总核心计算任务数
const int NUM_WORKERS = 4;     // 工作线程数量

// 线程池组件
queue<Task> ready_queue;       // 就绪队列:依赖已满足,等待 Worker 计算
queue<Task> completed_queue;   // 完成队列:Worker 计算完放回,供 Scheduler 更新拓扑图

// POSIX 同步原语
pthread_mutex_t lock;
sem_t ready_sem;      // 记录就绪队列中有多少个任务可供 Worker 执行
sem_t completed_sem;  // 记录完成队列中有多少个任务等待 Scheduler 调度

// 工作线程 (Worker)
void* worker_thread(void* arg) {
    while (true) {
        // 信号量自带整数记忆,这里替代了复杂的 while 条件判断,不必担心虚假唤醒
        sem_wait(&ready_sem);

        pthread_mutex_lock(&lock);
        Task t = ready_queue.front();
        ready_queue.pop();
        pthread_mutex_unlock(&lock);

        // “毒丸”(Poison Pill)机制:收到特殊坐标即代表通知退出线程
        if (t.i == -1 && t.j == -1) {
            break;
        }

        // 核心计算(并行执行区,无需加锁)
        int i = t.i, j = t.j;
        int delDist = dist_matrix[i - 1][j] + 1;
        int insDist = dist_matrix[i][j - 1] + 1;
        int subDist = dist_matrix[i - 1][j - 1] + (A[i - 1] == B[j - 1] ? 0 : 1);
        dist_matrix[i][j] = min({delDist, insDist, subDist});

        // 计算完毕,放入完成队列
        pthread_mutex_lock(&lock);
        completed_queue.push(t);
        pthread_mutex_unlock(&lock);

        // 增加完成信号量,唤醒 Scheduler 处理
        sem_post(&completed_sem);
    }
    return nullptr;
}

// 调度线程 (Scheduler)
void* scheduler_thread(void* arg) {
    int local_completed_tasks = 0;

    // 只要核心计算任务没跑完,调度器就持续运转
    while (local_completed_tasks < TOTAL_TASKS) {
        // 等待 Worker 提交已完成的任务
        sem_wait(&completed_sem);

        pthread_mutex_lock(&lock);
        Task t = completed_queue.front();
        completed_queue.pop();
        pthread_mutex_unlock(&lock);

        local_completed_tasks++;
        int i = t.i, j = t.j;

        // 更新其周边被依赖节点的入度,入度清零即可投入 ready_queue 并通知 Worker
        if (i + 1 <= M) {
            if (--in_degree[i + 1][j] == 0) {
                pthread_mutex_lock(&lock);
                ready_queue.push({i + 1, j});
                pthread_mutex_unlock(&lock);
                sem_post(&ready_sem); // 发放一个就绪信号
            }
        }
        if (j + 1 <= N) {
            if (--in_degree[i][j + 1] == 0) {
                pthread_mutex_lock(&lock);
                ready_queue.push({i, j + 1});
                pthread_mutex_unlock(&lock);
                sem_post(&ready_sem);
            }
        }
        if (i + 1 <= M && j + 1 <= N) {
            if (--in_degree[i + 1][j + 1] == 0) {
                pthread_mutex_lock(&lock);
                ready_queue.push({i + 1, j + 1});
                pthread_mutex_unlock(&lock);
                sem_post(&ready_sem);
            }
        }
    }

    // 当所有依赖图计算完毕,向 Worker 投递“毒丸”让其安全结束
    for (int k = 0; k < NUM_WORKERS; k++) {
        pthread_mutex_lock(&lock);
        ready_queue.push({-1, -1});
        pthread_mutex_unlock(&lock);
        sem_post(&ready_sem); // 唤醒所有正在休眠的 Worker
    }

    return nullptr;
}

int main() {
    // 1. 初始化锁与信号量
    pthread_mutex_init(&lock, nullptr);
    sem_init(&ready_sem, 0, 0);      // 初始就绪任务量为0
    sem_init(&completed_sem, 0, 0);  // 初始完成任务量为0

    // (此处假设 A, B 已经被赋予值...省略赋值操作)

    // 2. 初始化 Edit Distance 动态规划的边界条件
    for (int i = 0; i <= M; i++) dist_matrix[i][0] = i;
    for (int j = 0; j <= N; j++) dist_matrix[0][j] = j;

    // 3. 构建依赖图的入度状态
    for (int i = 1; i <= M; i++) {
        for (int j = 1; j <= N; j++) {
            int degree = 0;
            if (i > 1) degree++;
            if (j > 1) degree++;
            if (i > 1 && j > 1) degree++;
            in_degree[i][j] = degree;

            // 初始入度为 0 的节点,直接投入就绪队列并释放信号量
            if (degree == 0) {
                ready_queue.push({i, j});
                sem_post(&ready_sem);
            }
        }
    }

    // 4. 启动线程池
    pthread_t workers[NUM_WORKERS];
    for (int i = 0; i < NUM_WORKERS; i++) {
        pthread_create(&workers[i], nullptr, worker_thread, nullptr);
    }

    pthread_t scheduler;
    pthread_create(&scheduler, nullptr, scheduler_thread, nullptr);

    // 5. 等待所有线程执行结束
    pthread_join(scheduler, nullptr);
    for (int i = 0; i < NUM_WORKERS; i++) {
        pthread_join(workers[i], nullptr);
    }

    // 6. 销毁同步原语
    pthread_mutex_destroy(&lock);
    sem_destroy(&ready_sem);
    sem_destroy(&completed_sem);

    return 0;
}
信号量也不是擅长所有问题,考虑之前的打印 fish 问题:
- 有三种线程 无限打印
<、>和- - 任务:对线程同步,使得屏幕打印出
<><_和><>_的组合 - 假设刚打印完一条完整的鱼
<><_或><>_,那么下一个应该是?- 每种线程关联一个信号量,比如打印
<就是P(<) - 信号量的 V 操作具有指向性,不太好表达 “二选一”
- 每种线程关联一个信号量,比如打印
- 此外,信号量所记录的状态是整数形式,对于非整数的条件判定也不太适用
一般来说,信号量可以完成互斥锁的工作(其本身就可以看成一个更加高端的互斥锁)
- 信号量也能很方便的完成某些线程控制
- 但其不能胜任所有事情
条件变量可以适用于任何同步条件,其和互斥锁一起可以实现信号量
4 读者-写者问题
- 多个线程想要读取某个数据,有一个或多个线程需要写某个数据
- 简单的对所有线程加上互斥锁当然可以解决此问题,但是性能太低
- 为此,我们需要实现一个新的 “读写锁” 来保护共享数据
- 其可以允许多个 “读者” 同时访问共享数据,只要他们中没有一个修改该数据
- 一次只能有一个 “写者” 可以持有读写锁进入临界区,因此可以安全的读和写数据
4.1 读写锁的实现 1
- 读者-写者问题本质上就是分别给出当前读者和写者是否可以进入临界区的条件
- 读者:临界区为空或者临界区有其他读者
- 写者:只有临界区为空才可进入
- 要实现上述条件,需要记录当前临界区的 “读者” 数量
typedef struct _rwlock_t {
    sem_t lock; // 保护计数器的小锁
    sem_t rwlk; // 进入临界区获得锁
    int readers;
} rwlock_t;

void rwlock_init(rwlock_t *rw) {
    sem_init(&rw->lock, 0, 1); // 初始化 1,互斥
    sem_init(&rw->rwlk, 0, 1);
    rw->readers = 0;
}

void acquire_readlock(rwlock_t *rw) {
    P(&rw->lock); // 先抢小锁
    if(rw->readers == 0) {
        // 此时临界区还没有读者
        P(&rw->rwlk); //争抢进入临界区的锁
    }
    // rw->readers > 0 或者得到了 rwlk,写者无法进入
    rw->readers++;
    V(rw->lock); // 释放小锁
}

void release_readlock(rwlock_t *rw){
    P(&rw->lock);
    rw->readers--;
    if(rw->readers == 0){
        V(&rw->rwlk); // 空了才释放大锁
    }
    V(rw->lock);
}

void acquire_writelock(rwlock_t *rw) {
    P(&rw->rwlk); // 抢临界区大锁,小锁是为了 reader 计数
}
void release_writelock(rwlock_t *rw) {
    V(&rw->rwlk); // 放临界区大锁
}
上述实现中,如果一直有读者反复进入临界区,那么写者就会进入不了临界区,从而饿死
- 只有等只有最后一个读者退出临界区,其才会释放
rwlk - 这个实现也被称为读者优先,显然对写不友好
4.2 读写锁的实现 2
- 一个改进想法:如果有写者想要进入临界区,那么其应该阻止后来的读者尝试进入临界区
typedef struct _rwlock_t {
    sem_t rlock;   // 读操作时保护自身锁操作的锁
    sem_t wlock;   // 写操作时保护自身锁操作的锁
    sem_t tryRead; // 读者进入之前先看等待写者
    int readers;
    int writers;   // 想要进入的写者
    rwlock_t;
}

void rwlock_init(rwlock_t *rw) {
    sem_init(&rw->rlock, 0, 1);
    sem_init(&rw->wlock, 0, 1);
    sem_init(&rw->tryRead, 0, 1);
    rw->readers = 0;
    rw->writers = 0;
}

void acquire_readlock(rwlock_t *rw) {
    P(&rw->tryRead); // <-- 小锁之前
    P(&rw->rlock);
    if (rw->readers == 0) {
        P(&rw->wlock);
    }
    rw->readers++;
    V(&rw->rlock);
    V(&rw->tryRead); // <--
}

void release_readlock(rwlock_t *rw) {
    P(&rw->rlock);
    rw->readers--;
    if (rw->readers == 0) {
        V(&rw->wlock);
    }
    V(&rw->rlock);
}

void acquire_writelock(rwlock_t *rw) {
    P(&rw->wlock);
    if (rw->writers == 0) { // 第一个写者
        P(&rw->tryRead);
    }
    rw->writers++;
    V(&rw->wlock);
    P(&rw->wlock);
}

void release_writelock(rwlock_t *rw) {
    V(&rw->rwlock);
    P(&rw->wlock);
    rw->writers--;
    if (rw->writers == 0) {
        V(&rw->tryRead);
    }
    V(&rw->wlock);
}
上述实现中,如果一直有写者想要进入临界区,那么读者就会进入不了临界区,从而饿死
- 只有等只有最后一个写者退出临界区,其才会释放
tryRead,后续读者才能进入 - 这个实现也被称为写者优先,显然对读不友好
4.3 读写锁的实现 3
- 应该给线程排队!排在前面的优先尝试进入临界区 ——
ticket lock - 实现了一个较为公平的读写锁
typedef struct lock_ticket {
    int ticket; // 当前发放的最大票号
    int turn;   // 当前应该进入的票号
} ticket_t;

void lock_init(ticket_t* tlk) {
    tlk->ticket = 0;
    tlk->turn   = 0;
}

void ticket_lock(ticket_t* tlk) {
    int myturn = __sync_fetch_and_add(&tlk->ticket, 1);
    while (tlk->turn != myturn); // spin
}

void ticket_unlock(ticket_t* tlk) {
    __sync_fetch_and_add(&tlk->turn, 1);
}

typedef struct _rwlock_t {
    sem_t rlock;  // 读操作时保护自身操作的锁
    sem_t rwlk;   // 进入临界区获得锁
    ticket_t queue;  // 维持一个先进先出的队列
    int readers;
} rwlock_t;

void rwlock_init(rwlock_t *rw) {
    sem_init(&rw->rlock, 0, 1);
    sem_init(&rw->rwlk, 0, 1);
    lock_init(&rw->queue);
    rw->readers = 0;
}

void acquire_readlock(rwlock_t *rw) {
    ticket_lock(&rw->queue); // <--
    P(&rw->rlock);
    if (rw->readers == 0) {
        // 此时临界区还没有读者
        P(&rw->rwlk);  // 争抢进入临界区的锁
    }
    rw->readers++;
    V(&rw->rlock);
    ticket_unlock(&rw->queue); // <--
}

void release_readlock(rwlock_t *rw) {
    P(&rw->rlock);
    rw->readers--;
    if (rw->readers == 0) {
        V(&rw->rwlk);
    }
    V(&rw->rlock);
}

void acquire_writelock(rwlock_t *rw) {
    ticket_lock(&rw->queue); // <--
    P(&rw->rwlk);
    ticket_unlock(&rw->queue); // <--
}

void release_writelock(rwlock_t *rw) {
    V(&rw->rwlk);
}
- 读者-写者问题是一个非常普遍的问题,Posix 也给出了相应的读写锁
#include <pthread.h>
pthread_rwlock_t rw;
int pthread_rwlock_init(&rw, NULL);
int pthread_rwlock_destroy(&rw);

int pthread_rwlock_rdlock(&rw);
int pthread_rwlock_wrlock(&rw);
int pthread_rwlock_unlock(&rw);
- 用例
int shared_config = 100; // 全局共享资源
pthread_rwlock_t rwlock; // 声明读写锁

// 读者线程逻辑
void* reader_thread(void* arg) {
    int id = *(int*)arg;
    while (1) {
        pthread_rwlock_rdlock(&rwlock);
        printf("读者 [%d] 读取值为: %d\n", id, shared_config); // 进入临界区
        pthread_rwlock_unlock(&rwlock);
    }
    return NULL;
}

// 写者线程逻辑
void* writer_thread(void* arg) {
    while (1) {
        pthread_rwlock_wrlock(&rwlock);
        shared_config += 10;  // 进入临界区
        printf("==== 写者 更新值为: %d ====\n", shared_config);
        pthread_rwlock_unlock(&rwlock);
    }
    return NULL;
}
5 Read-Copy-Update*
5.1 新境界:无锁
- 锁的获取和释放都是有代价的
- 一般来说互斥锁上锁/释放的需要的 CPU cycles 比普通指令多一个数量级
- 在短临界区的情况下,锁本身占据了最多的时间,成为了并发程序的瓶颈
- 实际上,在这种情况下,线程越多,反而性能越低
- 虽然在读者-写者情况下 “读-读” 可以避免互斥,“写-写” 天生需要互斥,但 “读-写” 呢?
在数据的 “一致性” 要求不那么严的情况下(强一致性:当一个节点更新数据后,其他节点可以立即获取到最新的数据,读者可以不被写者阻塞
- 当写者更新数据时,读者可以
- 要么读到一个旧数据(写操作之前的数据)
- 要么读到最新的数据(写操作之后的数据)
- 除此之外,不能获得中间状态!保证 “写” 的原子性!
- 当然系统最终是一致的,即当一个节点更新数据后,其他节点可能需要经过一段时间才能获得最新数据,但最终总能获得(最终一致性)
- 对于 RCU 下的读者:
- 可以并发的和写者一起运行,而不会被阻塞
- 因此读操作几乎没有开销
- 相对(简单的读写锁)而言,RCU 下的写操作需要一些额外的成本
- 其适用于频繁的读,但不频繁的写场景(read-mostly)
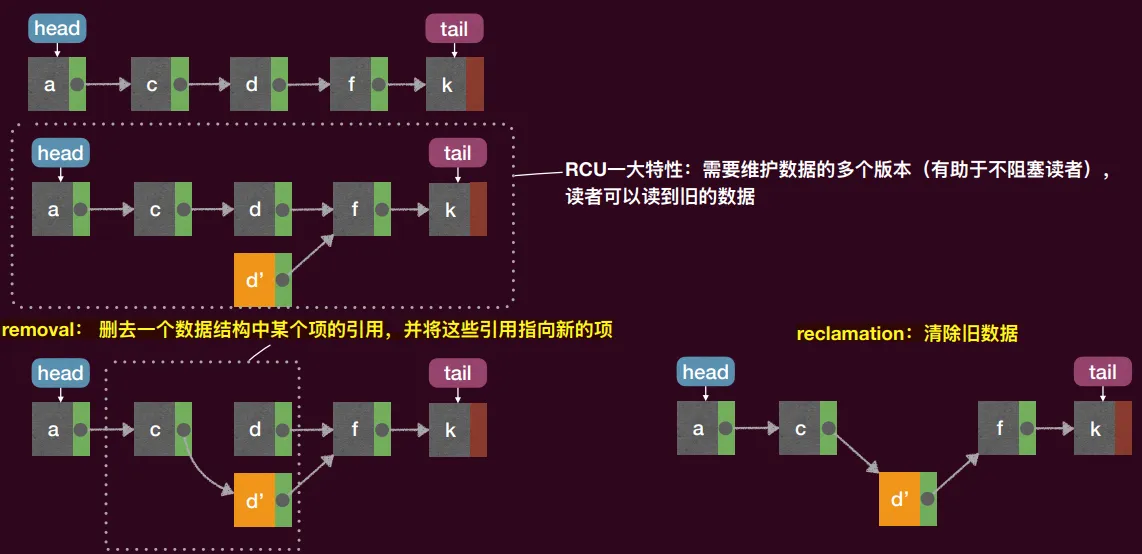
RCU 的核心在于更新数据时,分成 “removal” 和 “reclamation” 两个阶段
- “removal” 阶段会删去一个数据结构中某个项的引用(可能伴随将这些引用指向新的项),这个操作可以完全并发的和 “读” 者的操作进行
- “reclamation” 阶段对旧数据真正意义上清除,这个阶段需要 “同步”,不能存在还有读者还在使用这些旧数据
- 更新分为两阶段使得 “写” 数据不会阻塞读者,对读者非常有利,而写数据只在 “reclamation” 阶段会增加一些时间成本
5.2 RCU 的订阅-发布机制
- 简单的在写者处加锁,而读者处不加锁并不能保证 RCU 中 removal 的原子性
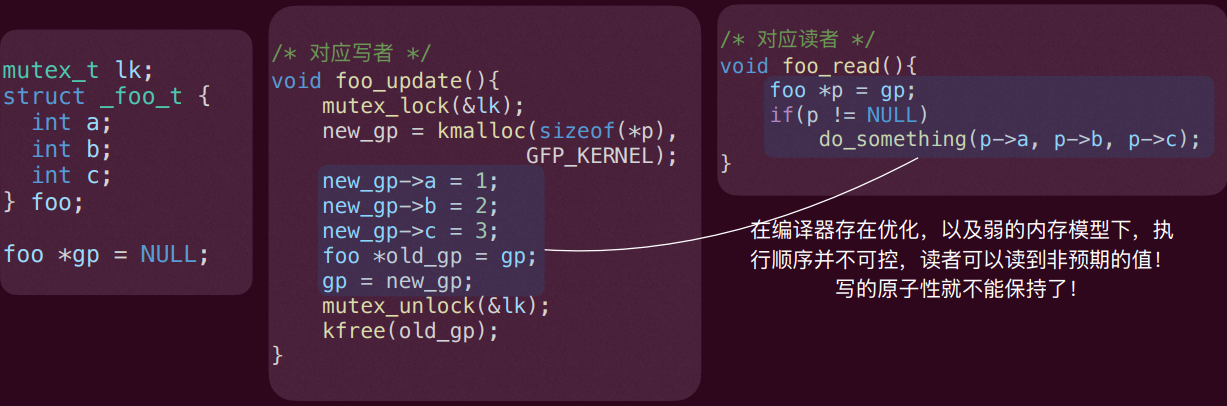
- 一个简单的做法就是加入内存屏障,保证写和读的顺序
- 将内存屏障直接包裹在一层 API 中
rcu_assign_pointer发布更新rcu_dereference订阅数据
/* 对应写者 */
void foo_update(){
    mutex_lock(&lk);
    new_gp = kmalloc(sizeof(*p), GFP_KERNEL);

    new_gp->a = 1;
    new_gp->b = 2;
    new_gp->c = 3;
    foo *old_gp = gp;
    rcu_assign_pointer(gp, new_fp); // 发布更新
    mutex_unlock(&lk);
    kfree(old_gp);
}

/* 对应读者 */
void foo_read(){
    foo *p = rcu_dereference(gp); // 订阅数据
    if(p != NULL)
    do_something(p->a, p->b, p->c);
}
5.3 RCU 的宽限期
所有旧的读者都读完了旧数据!
- 读者需要显式地标记读的区间
- 写者需要等到所有的 “旧” 线程都读结束了,才能释放旧数据,因此需要显式地表达 “等”
/* 对应写者 */
void foo_update(){
    mutex_lock(&lk);
    new_gp = kmalloc(sizeof(*p), GFP_KERNEL);
    new_gp->a = 1;
    new_gp->b = 2;
    new_gp->c = 3;
    foo *old_gp = gp;
    rcu_assign_pointer(gp, new_fp);
    mutex_unlock(&lk);
    synchronize_rcu(); // 等待旧读者结束
    kfree(old_gp);
}

/* 读者 */
void foo_read(){
    rcu_read_lock();   // 标记了读的区间
    foo *p = rcu_dereference(gp);
    if(p != NULL)
    do_something(p->a, p->b, p->c);
    rcu_read_unlock(); // 标记了读的区间
}
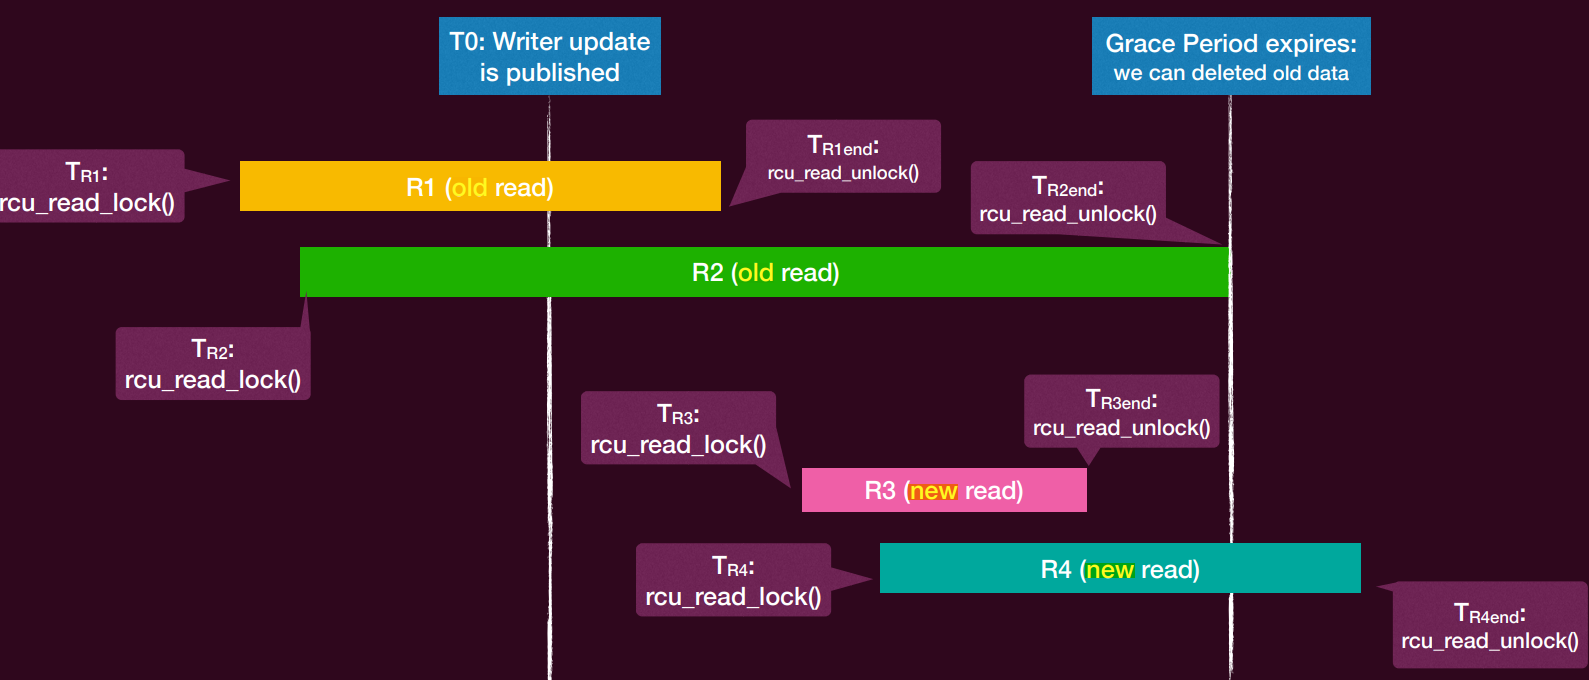
如何实现宽限期的机制?(注意不能用锁或条件变量,否则 RCU 就没意义了!)
- 每个读者进入 read-side 的临界区前执行关中断(
rcu_read_lock()) - 读者离开 read-side 的临界区前执行开中断(
rcu_read_unlock()) - 这样,写者只要侦测到所有 CPU 都做完一次 context-switch, 就可以安全的释放旧数据了
- 关中断(即读者在临界区期间)CPU 不会 context-switch
- 如果写者不想阻塞
- 那么可以通过
call_rcu()注册一个回调函数,这样可以免除被等待宽限期 - 所有旧的读者读完了,会自动调用
call_rcu()所注册的函数
- 那么可以通过
6 哲学家就餐问题
五位哲学家围坐在一张圆形餐桌旁,每位哲学家之间各有一只筷子,哲学家必须同时得到左右手的筷子才能吃东西
6.1 解决尝试 1
- 每个哲学家都先拿起自己左边的筷子,然后再拿起右边的筷子,然后吃
#define N 5

sem_t forks[N];
int left(int i) { return i; }
int right(int i) { return (i+1)%N; }

void philosopher(int i) {
    while(1) {
        think();
        P(forks[left(i)]);  // Pick up left fork
        P(forks[right(i)]); // Pick up right fork
        eat();
        V(forks[left(i)]);  // Put down left fork
        V(forks[right(i)]); // Put down right fork
    }
}
6.2 解决尝试 2
- 问题在于自己拿不到筷子还不断持有筷子,尝试拿不到时放下筷子
// 尝试 P 操作
int tryP(sem_t *s){
    // sem_wait 的非阻塞版本,如果返回 0,正常等到条件
    // 否则不会阻塞,而是返回 -1
    return sem_trywait(s);
}

void philosopher(int i){
    while(1){
        think();
        while(1){
            P(forks[left(i)]); // Pick up left fork
            int ret = tryP(forks[right(i)]); // Try to pick up right fork;
            if (ret != 0){
                V(forks[left(i)]); // Put down left fork
                sleep(sometime);
            }
            else{
                break;
            }
        }
        eat();
        V(forks[left(i)]);  // Put down left fork
        V(forks[right(i)]); // Put down right fork
    }
}
死锁和饿死都关乎活性,但并没有违背安全性
- 饿死即为一个线程在有限时间内无法行进
- 死锁是一类特殊的 “饿死”,其达成的条件是多个线程形成一个等待环,一个线程的行进需要环内的另外一个线程做某个动作:显然环状意味着这个等待条件永远无法发生
- 死锁一定饿死,饿死并不一定死锁(比如运气不好,一直被其他线程抢占临界区)
- 改进:每个线程睡眠的时间随机
只需将上面的代码中的 sleep(sometime) 改为 sleep(randomtime)
- 已经可以说解决问题了!但是在某些特别安全攸关的场景可能不那么可靠
6.3 解决尝试 3
- 哲学家拿起筷子就已经发生数据竞争了,不如一开始就上锁
ticket_t turn;
lock_init(&turn);

void philosopher(int i){
    while(1){
        think();
        ticket_lock(&turn); // <--
        P(forks[left(i)]);  // Pick up left fork
        P(forks[right(i)]); // Pick up right fork
        eat();
        V(forks[left(i)]);  // Put down left fork
        V(forks[right(i)]); // Put down right fork
        ticket_unlock(&turn);
    }
}
每次 \(N - 1\) 个人,根据鸽巢原理,一定有一个人拿到两个筷子从而可以吃饭
#define N 5
sem_t capacity = N - 1;

void philosopher(int i){
    while(1){
        think();
        P(capacity); // <--
        P(forks[left(i)]);  // Pick up left fork
        P(forks[right(i)]); // Pick up right fork;
        eat();
        V(forks[left(i)]);  // Put down left fork
        V(forks[right(i)]); // Put down right fork;
        V(capacity);
    }
}
6.4 解决尝试 4
- 一个更加简单的方案(无需额外互斥锁):给筷子编号,总是先拿编号小的
- 筷子的编号对应着哲学家编号
i
void philosopher(int i){
    while(1){
        think();
        if (left(i) < right(i)){
            P(forks[left(i)]);  // Pick up left fork
            P(forks[right(i)]); // Pick up right fork
        } else {
            P(forks[right(i)]); // Pick up right fork
            P(forks[left(i)]);  // Pick up left fork
        }
        eat();
        V(forks[left(i)]);  // Put down left fork
        V(forks[right(i)]); // Put down right fork;
    }
}
哲学家 0 拿 fork 0,哲学家 1 拿 fork 1,…,哲学家 4 也拿 fork 0,但已被拿走,哲学家 3 在拿了 fork 3 之后接着拿 fork 4,等其吃饭结束释放 fork 后又可供其他哲学家吃饭
- 除了互斥这种简单的控制外,我们还需要控制线程的顺序、相对关系等(同步)
- 条件变量可以帮助实现适用于任何同步条件(注意使用方法,需要配合互斥锁)
- 基于
wait、signal原语可以实现算法的并发
- 基于
- 信号量是更加容易使用的同步工具
- 其具有状态记忆,可以看成初始资源
- RCU: 如何实现一个无锁算法
- 同步经典问题:生产者-消费者问题、读者-写者问题(公平性问题)、哲学家进餐问题(死锁、饿死问题)
标题:同步
作者:Zwing
创建于:2026-08-09 00:12:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/并发-同步.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可