
并发问题
1 原子性和顺序性 bug
除了死锁之外,大部分(97%)并发错误都可归类为如下两种
- 原子性违背(Atomicity Violation, AV):忘记上锁
- “ABA”:代码被别人 “强势插入”
- 有时即使你意识到了需要上锁,并且也加锁了,也会犯错
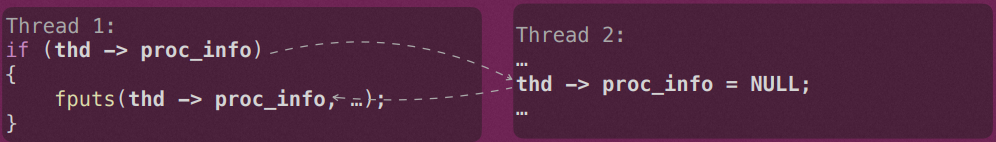
- 顺序性违背(Order Violation, OV):忘记同步,或者同步条件写错
- “BA”: 事件未按预定的顺序发生
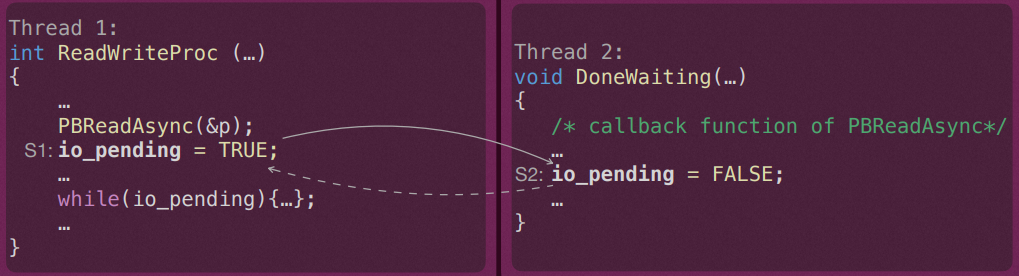
实线为正确顺序,虚线为错误顺序
- 线程 1
PBReadAsync(&p);会回调线程 2,同时线程 1 把io_pending置为TRUE以挂起自己,等线程 2 处理完修改io_pending为False唤醒- 但若线程 1
PBReadAsync(&p);回调线程 2 后,线程 2 先把io_pending置为False,则线程 1 接下来将无限忙等没有环形等待,没有持有并等待,不是死锁
2 死锁
2.1 死锁的样例
在并发计算中,死锁是指某个小组中的成员因为每个成员都在等待另一个成员(包括自己)采取行动,因此无法继续执行的状态
- A-A 型死锁:线程在已经持有一把锁的情况下再次尝试获得这把锁
void foo(){
    lock();
    foo();
    unlock();
}

// 解决方案:xv6 防御性编程
void acquire(struct spinlock *lk) {
    // ...
    if(holding(lk)) panic(“acquire”); // 自爆
    // ...
}
更一般的死锁:一个涉及多个线程以及多个锁的情形,每个线程都在等待其他线程所持有的 锁,从而没有一个可以行进
- 一个典型案例就是 ABBA 型死锁:线程 1 拿到了锁 A,需要锁 B,线程 2 拿到了锁 B,需要锁 A,这时两个线程都无法行进
- 哲学家进餐问题的第一尝试就是这种类型的死锁
void T1() {
    lock(&A);
    lock(&B);
    dosomething();
    unlock(&B);
    unlock(&A);
}

void T2() {
    lock(&B);
    lock(&A);
    dosomething();
    unlock(&A);
    unlock(&B);
}
条件变量和锁的使用也会产生死锁:等待某个条件变量看成是等待某个资源,而释放的那个线程看成是持有某个资源
void T1(){
    lock(&A);
    lock(&B);
    while (need-to-wait)
        wait(&cv, &B); // 释放了 B 但仍持有 A
    unlock(&B);
    unlock(&A);
}

oid T2(){
    lock(&A); // 卡在这里无法到 signal 唤醒 T1
    lock(&B);
    signal(&cv);
    unlock(&B);
    unlock(&A);
}
2.2 死锁产生的必要条件
- 互斥(Mutual-exclusion):所需要的资源是互斥的
- 互斥也可改为资源有限,即能够共享的线程数有限
- 持有并等待(Hold and wait):持有某个资源并等待更多资源
- 非抢占性(No-preemption):不可直接 “抢” 别人持有的资源,只有等持有的人主动释放
- 环形等待(Circular wait condition):形成循环等待的环
哲学家问题尝试 1 即满足上述所有条件
- 注意这是 “必要条件”:达成条件也不一定就一定死锁
- 比如对于同一种类型的多个筷子
- 环之外的线程可以释放资源解开这个环等待状态
- 忽略问题:问题的发生频率很低且发生后代价很小
- 从源头避免死锁发生
- 检测并修复
3 死锁避免:必要条件的破坏
死锁的四个必要条件,破坏其一即可
- 互斥
- 不太容易,互斥是并发能够保证安全性的重要机制,易出错
- 但仍有无锁算法:如 RCU、一些基于硬件支持的数据结构和算法
void AtomicIncrement(int *value, int amount) { // 无锁的加某个值
    do {
        int old = *value;
    } while (CompareAndSwap(value, old, old + amount) == 0);
}
- 持有并等待
- 要么能一次得到所有锁,要么什么锁也不获取:不现实
- 因为需要线程提前就知道需要哪些锁
- 减少了一些并发度
- 如果此刻无法获得想要的锁,就释放其所有持有的锁
- 参考哲学家问题的尝试 2
- 非抢占性
- 允许系统直接去 “抢” 别的线程所持有的资源
- 一个线程需要更多的内存,但此时没有更多的空闲内存了,那么它可以去 “抢” 别的线程的内存:将别的线程先暂时移出内存到磁盘上,然后再去得到这些内存
- CPU 的使用也是可以被抢占,利用 context-switch 机制
- 问题是不是每种资源都可以直接 “抢” 的
- 打印机资源
- 一个合理的 “抢” 需要被抢走资源的线程能够恢复到被抢前的状态
- 环形等待
- 强制在锁在申请时按照规定的顺序来
- 比如按照锁在内存中的位置进行编号排序
- 锁的申请过程就是构造一个关于锁的有向图 \(G\) 的过程
- 图中的每条边都是 “小” 一点的锁指向 “大” 一点的锁
- 箭头只能单向流动,构成了拓扑序
- 有拓扑序意味着这个锁申请有向图是无环的
- 锁的编号不一定需要全序,有偏序即可(可能同时被持有的锁之间规定先后顺序)
然而即使是 lock ordering 仍然有其局限性
- 不可扩展:新增一个锁时,不可能完全理解整个内核的上下文,不可能准确判断这个新锁应该插入到哪个位置,且一旦放错就会埋下死锁隐患
- 核心解决方案:锁的封装
4 死锁避免:避免陷入不可挽回状态
死锁关乎程序的活性性质
- 活性: “好事终将发生”
- 活性要求只要在最终能满足要求即可,一个隐含的要求是执行中不能发生 “不可挽回” 的步骤
4.1 导致死锁的 “不可挽回” 事件
- 有两个线程 A 和 B,每个线程都需要用到需要如下的两个互斥的资源:打印机和绘图仪
- 线程 A 从指令 \(I_1\) 到 \(I_3\) 之间需要打印机,从指令 \(I_2\) 到 \(I_4\) 之间需要绘图仪
- 线程 B 从指令 \(I_5\) 到 \(I_7\) 之间需要绘图仪,从指令 \(I_6\) 到 \(I_8\) 之间需要打印机
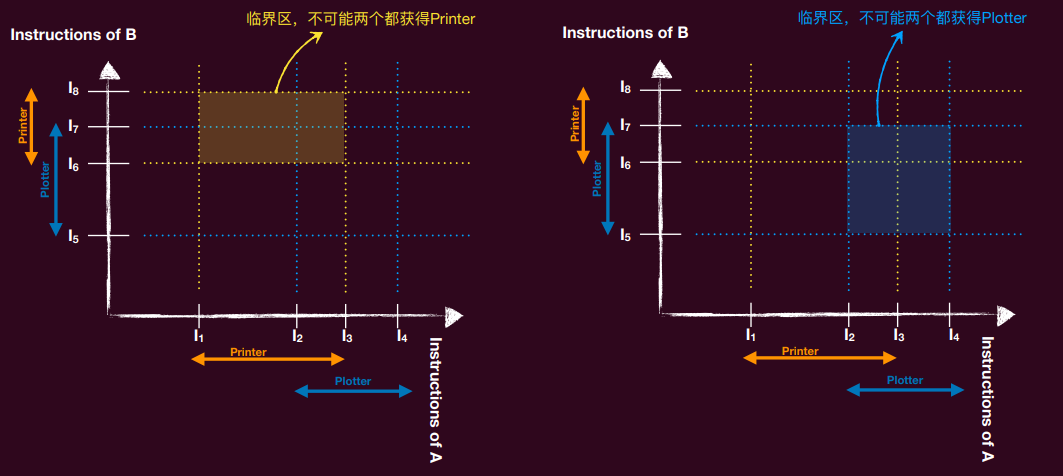
- 考察下图红点处 \((I_2, I_6)\),试问如果系统状态处于该点(即线程 A 得到了打印机,请求绘图仪,线程 B 得到了打印机,请求绘图仪)
- 典型的 ABBA 型死锁,系统无法再行进
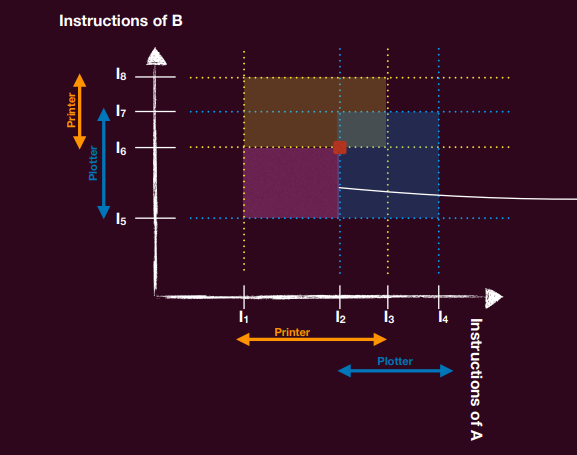
- 紫色区域已经是 “不可挽回” 了,处在这个区域的系统,随着整体能够行进的方向(向上向右)最终都会无可避免的走向死锁状态
- 只要能避免进入该不可挽回的区域就不会发生死锁
- 这需要在系统尝试进入该区域时,调度系统直接拒绝相应的线程得到想要的资源
如果要按照上述的情形来给出不可挽回区域,必须提前知道每个线程在未来哪段指令间需要什么锁或其他互斥资源:不现实
4.2 银行家算法
- 每个线程 \(i\) 有一个最大需求向量 \(M_i\),所有线程的最大需求向量为矩阵 \(M\)
- 每个线程 \(i\) 有一个当前持有资源向量 \(C_i\),所有线程的当前持有资源为矩阵 \(C\)
- 系统初始每个资源数向量 \(E\)
- 系统的行进伴随着线程对互斥资源的申请和释放,释放资源是平凡的事件,因为释放资源不会让系统进入 “不可挽回” 状态,但申请资源会
- 每个线程 \(i\) 有一个当前资源申请向量 \(R_i\),所有线程的当前申请资源为矩阵 \(R\)
如果接受了这个申请,导致无法满足未来的 “最大” 申请,即不可挽回(“不安全”)
- 即目前虽然没有死锁,可以满足,但既定的未来不可满足
正确的决策:如果当前申请矩阵会导致系统进入 “不可挽回” 状态,拒绝,否则接受申请,更新系统状态 —— 银行家算法
- Step 1: 找一个线程 \(i\),看看其未来还需要的最大资源数(最大资源需求数 - 目前持有资源数)是否能够被目前系统尚存的资源数所满足(系统初始资源数 - 被所有线程所持有的资源数),如果所有线程都不能被满足,就是一个 “不可挽回” 的状态,最终会进入死锁
- Step 2: 对满足需求的线程 \(i\),标记其为未来可满足状态,即其可以在目前状态下存在一个分配方式(立即全部分配其所有资源)终止。那么也就存在这样的一个好的局面:我们可以将其资源都收回
- Step 3: 在步骤 2 的更好的局面上,重复之前的步骤,一直到所有线程都可以终止,那么该系统状态就是 “可挽回” 的状态
然而,银行家算法是不实用的,但考试爱考
- 没法知道 “最大” 需求矩阵
- 系统的资源是动态变化的
- 线程数会变化
- 资源数可能会变化(线程可以自己释放所持有的锁)
5 死锁的动态侦测
锁的持有和申请就是一个有向图,核心就是检测锁申请环
- 有向图的环检测
- 深度优先算法,出现回边就是出现了环
- 入度表拓扑排序
一个更加具体的实现(lockdep的简单原理):
- 每次锁的 acquire/release 都记录
tid和lock name,动态构建锁的有向图 \(G(V, E)\),并 Assert 该图没有环 - \(V\):为每把锁的名字
- \(E\):每个线程持有某把锁 \(u\) 之后再去尝试获得某把锁 \(v\),就加入边 \((u, v)\)
- 锁的名字可以用地址来唯一绑定(也可以是锁所在的文件和行,这是一种近似,因为可能同一个行是
malloc不同的锁,相应地,代价低)
- 如果是一类的互斥资源有多个资源数呢?单纯的环已不足来检测死锁
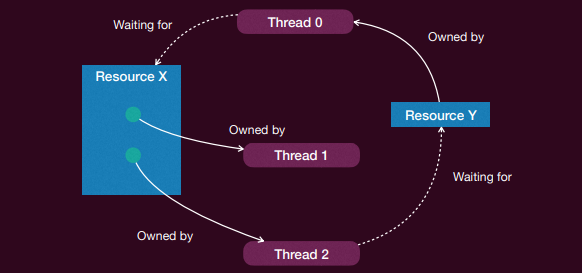
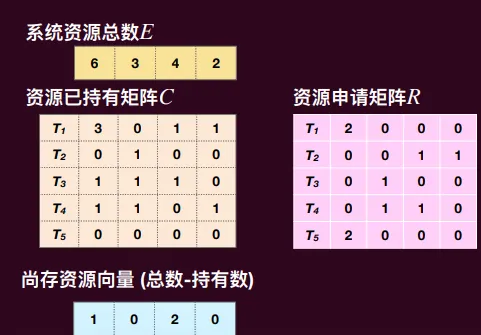
- 所有线程的当前持有资源为矩阵 \(C\)、所有线程的当前申请资源为矩阵 \(R\)、以及系统资源总数向量 \(E\)
- 按照和之前银行家算法类似的思路
- 找到可以满足要求的线程,先假定分配给其资源,然后释放其所有资源(创造更好的局面)
- 不断重复上述步骤,直到所有线程都可满足即没有死锁
- 否则就是出现死锁
6 并发 Bugs 的一些动态分析方法
给定一次状态机(程序)的执行历史信息 \(\tau\)(比如日志 log、covering lines、memory access、execution time、lock acquires/releases…)
- 当然这种记录往往需要额外的运行成本(比如插桩)
动态分析即为根据这个信息的分析函数 \(f(\tau): \tau \to \{0,1\}\),\(0\) 代表关心问题的答案为否(比如没有 bug),\(1\) 代表关心问题的答案为是(比如有 bug),当然答案还可以有更多可能,那么这个值域会增大
本质上,只要你定义了什么是正确、什么是错误,并知道这种错误会在运行时产生有什么后果,就能检测出来
6.1 AddressSanitizer: 非法内存访问
- 通过编译器自动插入和内存相关的断言比如每次分配内存时,额外分配一些不可写的内存 “投毒”,一旦访问到这些被投毒的内存,就知道越界了),实现代码正确性的检查。可以检测如 Buffer (heap/stack/global) overflow, use-after-free, use-after-return, double-free, …
6.2 ThreadSanitizer: 运行时的竞态条件检测
回顾竞态条件(数据竞争):不同的线程同时访问同一内存,且至少有一个是写
- 不同线程是容易观察到的(Thread id)
- 同一内存也是容易观察到的(内存的地址),
- 至少一个是写是容易观察到的(
load和store指令) - 关键问题是,什么是同时?
- 让我们问一个反向的问题:什么不是同时?happens-before 关系!
ThreadSanitize r可以为所有事件建立 happens-before 关系图
- 比如对于下面两个事件
- \(x\):
mutex_lock(A); load(v); mutex_unlock(A); - \(y\):
mutex_lock(A); store(v); mutex_unlock(A); - 推出:\(x ≺ y ∨ y ≺ x\)
- \(x\):
- 比如对于
wait和signal有显著的先后顺序 - 对于发生在不同线程且至少有一个是写的检查,若没有出现在上述的关系中,便是一个潜在的竞态条件
- “同时” 的反向
- 如 \(x ≺ y ∨ y ≺ x\) 没有出现,则为竞态条件
- AddressSanitizer (asan): 非法内存访问
- ThreadSanitizer (tsan): 数据竞争
- MemorySanitizer (未初始化的读取)
- UBSanitizer (undefined behavior,如整数溢出、对象越界、溢出等一系列问题)
6.3 一些低配版实现
Canary:“牺牲” 内存单元,预警 memory error
- 比如 stack guard
#define MAGIC 0x55555555 // 魔法数字
#define BOTTOM (STK_SZ / sizeof(u32) - 1)
struct stack { char data[STK_SZ]; };

void canary_init(struct stack *s) {
    u32 *ptr = (u32 *)s;
    // 往这块连续内存的最前面和最后面写入 MAGIC
    for (int i = 0; i < CANARY_SZ; i++) {
        ptr[BOTTOM - i] = ptr[i] = MAGIC;
    }
}

void canary_check(struct stack *s) {
    u32 *ptr = (u32 *)s;
    for (int i = 0; i < CANARY_SZ; i++) {
        panic_on(ptr[BOTTOM - i] != MAGIC, "underflow");
        panic_on(ptr[i] != MAGIC, "overflow");
    }
}
- 比如 buffer overflow
int foo() {
    // 一段连续内存;位于局部变量和返回地址之前
    u32 canary = SOME_VALUE;
    ... // 实际函数
    canary ^= SOME_VALUE; // 如果程序被攻击或出错,canary 就不会归零了
    assert(canary == 0);
    return ret;
}
在函数调用时,局部变量和该函数的返回地址是挨着存放在函数调用栈里的。黑客经常利用局部变量数组越界(Buffer Overflow),一路往高地址写数据,把真实的返回地址覆盖成恶意代码的地址,从而劫持程序控制流
检测:如果黑客想通过局部变量越界去覆盖后面的返回地址,他必定会先踩过 Canary 所在的内存,导致 Canary 的值被篡改
低配版 lockdep(死锁检测子系统)
- 统计当前的 spin count
- 如果超过某个明显不正常的数值就报告
int spin_cnt = 0;
// 注意 xchg(&lk, 1) 中的 1:把 1 写入 lk 并返回旧值
while(xchg(&lk, 1) == 1) {
    // 单纯自旋锁中加了这个计数和判断
    if (spin_cnt++ > SPIN_LIMIT) {
        panic("Spin limit exceeded @ %s:%d\n", __FILE__, __LINE__);
    }
}
低配版 AddressSanitizer
内存分配器的 specification(规范):
- 已分配内存 \(S = [l_0, r_0) \cup [l_1, r_1) \cup \ldots\)
- 并发的分配很可能破坏这个 specification
kalloc(s)返回的 \([l, r)\) 必须满足 \([l, r) \cap S = \varnothing\)
// allocation
for (int i = 0; (i + 1) * sizeof(u32) <= size; i++) {
    panic_on(((u32 *)ptr)[i] == MAGIC, "double-allocation"); // 有毒
    arr[i] = MAGIC; // 投毒
}

// free
for (int i = 0; (i + 1) * sizeof(u32) <= alloc_size(ptr); i++) {
    panic_on(((u32 *)ptr)[i] == 0, "double-free");
    arr[i] = 0;
}
低配版 ThreadSanitizer
线程的读写一个共享数据不是原子的,即在中间可能被其他线程插入
- 但是这个错误一般很难观测,因为指令的读写太快了
- 想法:通过拖慢线程读写速度,放大原子性破坏的可能性(执行时间越长,被其他线程干涉的可能性越大)
// Suppose x is lock-protected
...
int observe1 = x;
delay();
int observe2 = x;
assert(observe1 == observe2);
...
极低的成本换取极高检测率的调试技巧
给定一个程序正确运行的 specification,原则上我们能够写出动态分析的方法验证程序运行时有没有破坏这个 specification
- 但有时候验证一个完整的 specification 过于复杂或者条件不允许
- 此时如果能够从这个 full specification 推出一些弱化的 specification,从而更加容易的实现一些 Sanitizer,那么即使精度可能没那么高,但实际中会有很好的效果
- 比如:你能给出图像识别软件的 full specification 吗?
- 图像识别是概率模型,它的 “正确” 是模糊的,写不出 Full Spec,但对于弱化规范:
- 鲁棒性:给图片加一点点噪点,分类结果不应该改变。
- 公平性:换一张肤色不同的人脸,识别出的情绪不应该突变。
- 边界检查:输出的概率之和必须等于 1,不能出现 NaN 或负数。
- 这些都不是 “完整的图像识别规范”,但它们作为 Sanitizer 跑在运行时,能极其有效地抓出 AI 模型的严重 Bug,且计算开销极低
- 图像识别是概率模型,它的 “正确” 是模糊的,写不出 Full Spec,但对于弱化规范:
死锁就是其中一大类
- 死锁可以通过破坏其必要条件来避免
- 也可以通过动态的合理分配来避免
- 也可以通过动态分析来检测
并发的其他 Bugs 也有一些非常实用的动态分析技术来检测
- 各种 Sanitizer
标题:并发问题
作者:Zwing
创建于:2026-08-09 00:11:00
更新于:2026-08-08 16:25:54
链接:https://zanytriumph.github.io/posts/并发-并发问题.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可