
6 链路层和局域网
- 点到点连接
- 多点连接:
- 共享型介质
- 通过网络交换机
-
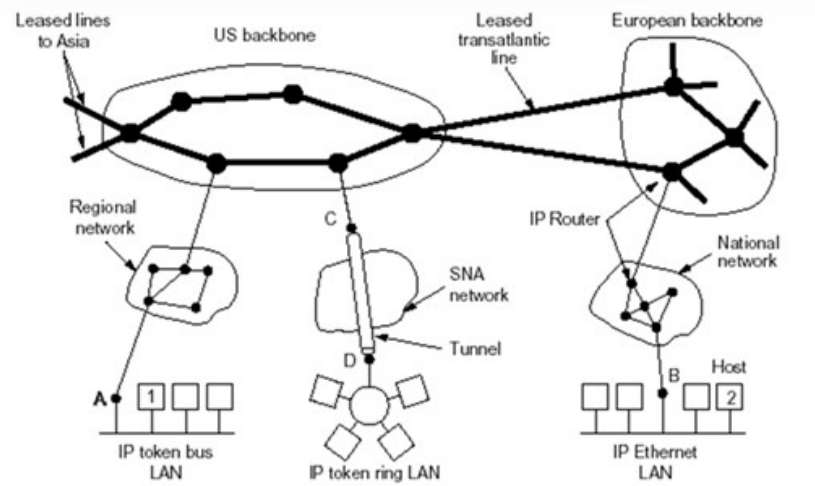
WAN: 网络形式采用点到点链路
- 带宽大、距离远(延迟大) -> 带宽延迟积大
- 如果采用多点连接方式
- 竞争方式:一旦冲突代价大
- 令牌等协调方式:在其中协调节点的发送代价大
-
点到点链路的链路层服务 实现非常简单,封装和解封装
-
LAN 一般采用多点连接方式
- 连接节点非常方便
- 接到共享型介质上(或网络交换机),就可以连接所有其他节点
-
多点连接方式网络的链路层功能 实现相当复杂
- 多点接入:协调各节点对共享性介质的访问和使用
- 竞争方式:冲突之后的协调
- 令牌方式:令牌产生,占有和释放等
1 引论与服务
1.1 一些术语
- 主机和路由器是节点:nodes
- 沿着通信路径,连接各相邻节点通信信道的是链路:links
- 有线链路
- 无线链路
- 局域网,共享性链路
- 第二层协议数据单元帧 frame,封装数据报
数据链路层负责从一个节点通过链路将(帧中的)数据报发送到相邻的物理节点(一个子网内部的 2 节点)
1.2 链路层上下文
- 数据报(分组)在不同的链路上以不同的链路协议传送
- 第一跳链路:Wi-Fi(无线局域网,WLAN)
- 下一跳链路:以太网
- 不同的链路协议提供不同的服务
- 比如在链路层上提供(或没有)可靠数据传送
- 从 Princeton 到 Lausanne
- 轿车: Princeton to JFK
- 飞机: JFK to Geneva
- 火车: Geneva to Lausanne
- 旅行者 = 数据报 datagram
- 交通段 = 通信链路 communication link
- 交通模式 = 链路层协议: 数据链路层和局域网 protocol
- 票务代理 = 路由算法 routing algorithm
1.3 链路层服务
一般化的链路层服务,不是所有的链路层都提供这些服务 一个特定的链路层只是提供其中一部分的服务
- 成帧,链路接入:
- 将数据报封装在帧中,加上帧头、帧尾部
- 如果采用的是共享性介质,信道接入获得信道访问权
- 在帧头部使用 “MAC”(物理)地址来标示源和目的
- 不同于 IP 地址
- 在相邻节点间(一个子网内)进行可靠的转发
- 在低差错链路上很少使用(光纤,一些双绞线)
- 出错率低,没有必要在每一个帧中做差错控制的工作,协议复杂
- 发送端对每一帧进行差错控制编码,根据反馈做相应的动作
- 接收端进行差错控制解码,反馈给发送端(ACK,NAK)
- 在本层放弃可靠控制的工作,在网络层或者是传输层做可靠控制的工作,或者根本就不做可靠控制的工作
- 出错率低,没有必要在每一个帧中做差错控制的工作,协议复杂
- 在高差错链路(无线链路)上需要进行可靠的数据传送
- Q:为什么要在采用无线链路的网络上,链路层做可靠数据传输工作,还要在传输层做端到端的可靠性工作?
- 原因:出错率高,如果在链路层不做差错控制工作,漏出去的错误比较高;到了上层如果需要可靠控制的数据传输代价会很大
- 如不做 local recovery 工作,总体代价大
- 在低差错链路上很少使用(光纤,一些双绞线)
- 流量控制
- 使得相邻的发送和接收方节点的速度匹配
- 错误检测
- 差错由信号衰减和噪声引起
- 接收方检测出的错误:
- 通知发送端进行重传或丢弃帧
- 差错纠正
- 接收端检查和纠正 bit 错误,不通过重传来纠正错误
- 半双工和全双工
- 半双工:链路可以双向传输,但一次只有一个方向
1.4 链路层实现
- 在每一个主机上
- 也在每个路由器上
- 交换机的每个端口上
- 链路层功能在 “适配器” 上实现(network interface card,NIC)或者在一个芯片组上
- 以太网卡,802.11 网卡;以太网芯片组
- 实现链路层和相应的物理层功能
- 接到主机的系统总线上
- 硬件、软件和固件的综合体
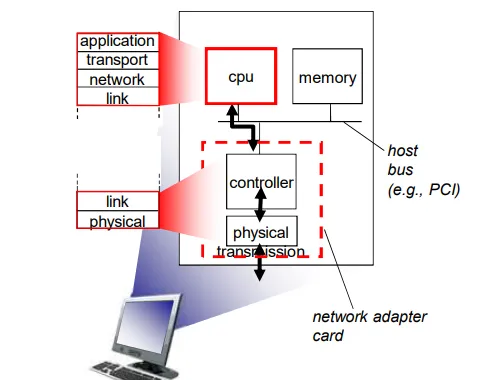
1.5 适配器通信
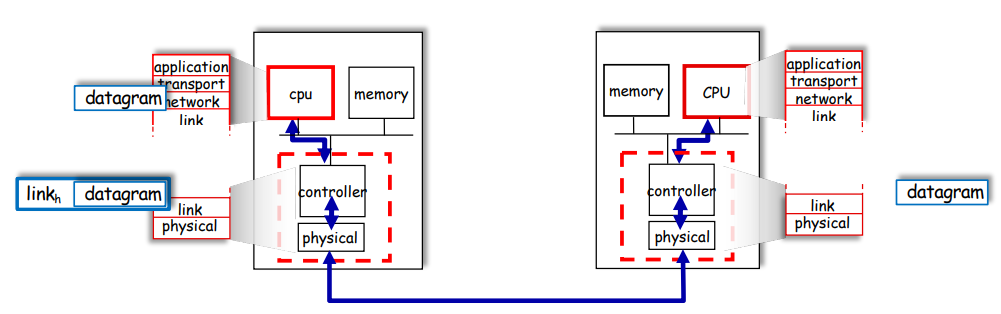
- 发送方:
- 在帧中封装数据报
- 加上差错控制编码,实现 RDT(可靠数据传输)和流量控制功能等
- 接收方:
- 检查有无出错,执行 RDT 和流量控制功能等
- 解封装数据报,将其交给上层
2 差错检测和纠正
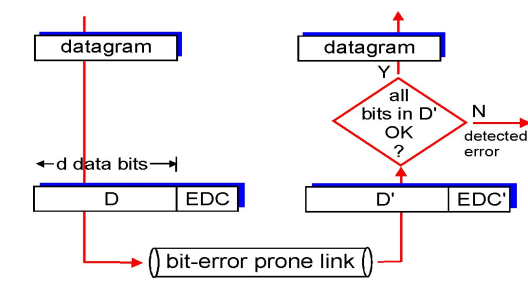
- EDC = 差错检测和纠正位(冗余位)
- D = 由差错检测保护的数据,可以包含头部字段
- 错误检测不是 100% 可靠的
- 协议会漏检一些错误,但是很少
- 更长的 EDC 字段可以得到更好的检测和纠正效果
2.1 奇偶校验
- 核心思想:数“1”的个数
通常使用的是 偶校验,它的规则是:发送方和接收方约定好,一段数据里面加上校验位之后,数字 “1” 的总个数必须是偶数
什么校验就凑成什么数
2.1.1 单 bit 奇偶校验:检测单个 bit 级错误
0111000110101011 0
 d data bit      perity bit
- 数据位 (data bits): 0111000110101011
- 里面有 8 个 1,已经是偶数了。
- 加上校验位 (parity bit):为了保持 “1” 的总个数是偶数,我们在最后面补一个 0
- 最终发送出去的数据是加上校验位之后的组合
怎么发现错误?
- 假设数据在网线里传输时,遇到了电磁干扰,其中一个 0 变成了 1
- 接收方收到数据发现里面有 9 个 1,9 是奇数,破坏了“必须是偶数”的约定
缺点:
- 只能检测单个错误:如果有两个位同时翻转,总数可能还是偶数
- 不能定位错误和纠正
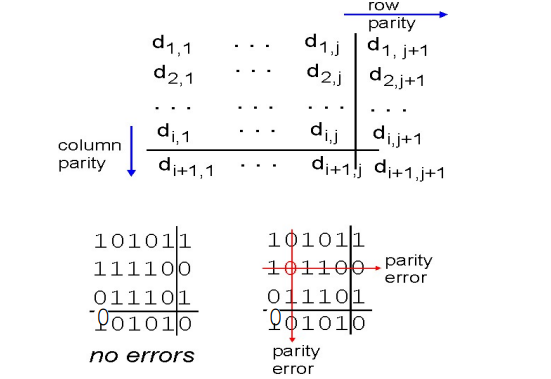
2.1.2 二维奇偶校验:检测和纠正单个bit错误
二维奇偶校验:把一长串数据排成一个矩阵
- 行校验:给每一行算一个奇偶校验位放在最右边
- 如下图第一行 1 0 1 0 1,有三个1,补个 1 凑成偶数(四个1)
- 列校验:给每一列算一个奇偶校验位放在最下边
- 右下角的角标:是对所有校验位再做一次校验
它是怎么纠正错误的?
- 假设第二行、第二列的那个 1 变成了 0(发生了单 bit 错误)。
接收方收到数据后重新计算:
- 算第二行,发现 1 的个数不对了(变成奇数了),说明第二行有错
- 算第二列,发现 1 的个数也不对了,说明第二列有错
行列确定即可定位,纠正只需翻转bit
2.2 循环冗余校验(CRC)
- 奇偶校验:最简单,只能查单 bit 错。
- Internet 校验和:软件算,用在传输层(TCP/UDP),简单快速但算不上特别严谨。
- CRC(循环冗余校验):则是硬件级别(网卡里)最强大、最广泛使用的差错检测技术。以太网、Wi-Fi 全都在用它。
2.2.1 CRC 的核心思想
位串的两种表示:
- 二进制位串:\(110101101\)(9 位长)
- 多项式:\(x^8 + x^7 + x^5 + x^3 + x^2 + 1\)
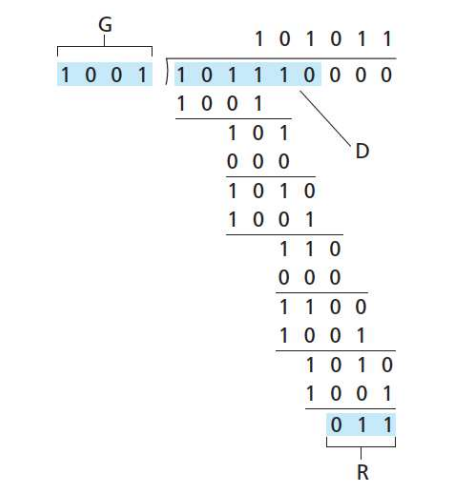
假设发送方和接收方提前约定一个 生成多项式 \(G\) 作为除数 发送方有一段数据 \(D\) 要发,但 \(D\) 直接除以 \(G\) 通常是除不尽的 发送方的任务就是:在 \(D\) 的尾巴上追加几个数字 \(R\),使得拼起来的新数字,刚好能被 \(G\) 整除
接收方收到这段拼起来的数据后,只需要做一件事:除以 \(G\)
- 如果余数是 0(能整除),说明数据在路上没出错
- 如果余数不是 0,说明数据被干扰了,直接丢弃
核心变量解释:
- \(D\):要发送的真实二进制数据
- \(G\):双方约定的除数,有 \(r+1\) 位长
- \(R\):你要算出来的附加在尾巴上的校验位,固定是 \(r\) 位
- \(D \cdot 2^r \text{ XOR } R\):这个数学公式的意思就是“把数据 \(D\) 左移 \(r\) 位(即在尾巴补 \(r\) 个 0),然后把 \(R\) 填进去”
2.2.2 CRC 的计算方法
需要:
等价于: 两边同 \(XOR\ R\),得到余数
等价于: 两边同除 \(G\),得到余数
模 2 运算的唯一法则:不进位,不借位,其实就是异或(XOR)
- 相同为
0(1 XOR 1 = 0,0 XOR 0 = 0) - 不同为
1(1 XOR 0 = 1,0 XOR 1 = 1)
故 CRC 的计算过程就是:把 \(D\) 左移 \(r\) 位(在尾巴补 \(r\) 个 0),然后用 \(G\) 去除(模 2 运算),得到的余数就是 \(R\)
 {width=350,style=“display:block;margin:auto”}
3 多点访问协议
两种类型的链路(一个子网内部链路连接形式):
- 点对点
- 拨号访问的 PPP
- 以太网交换机和主机之间的点对点链路
- 广播 (共享线路或媒体)
- 传统以太网
- HFC 上行链路
- 802.11 无线局域网
- 单个共享的广播型链路
- 2 个或更多站点同时传送: 冲突
- 多个节点在同一个时刻发送,则会收到 2 个或多个信号叠加
多路访问协议(介质访问控制协议:multiple access channel,MAC):
- 分布式算法 —— 决定节点如何使用共享信道
- 即:决定节点什么时候可以发送?
- 关于共享控制的通信必须用借助信道本身传输!
- 没有带外的信道,各节点使用其协调信道使用
理想的多路访问协议:
给定:R bps 的广播信道 必要条件:
-
当一个节点要发送时,可以 R 速率发送
-
当 M 个节点要发送,每个可以以 R/M 的平均速率发送
-
完全分布的:
- 没有特殊节点协调发送
- 没有时钟和时隙的同步
-
简单
MAC 协议的分类:3 大类
- 信道划分
- 把信道划分成小片(时间、频率、编码)
- 分配片给每个节点专用
- 随机访问
- 信道不划分,允许冲突
- 冲突后恢复
- 依次轮流
- 节点依次轮流
- 但是有很多数据传输的节点可以获得较长的信道使用权
3.1 信道划分协议
3.1.1 TDMA(时分)
TDMA: time division multiple access
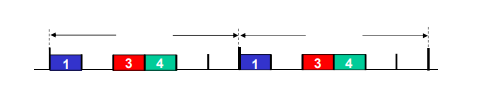
- 轮流使用信道,信道的时间分为周期
- 每个站点使用每周期中固定的时隙(长度 = 帧传输时间)传输帧
- 如果站点无帧传输,时隙空闲 -> 浪费
- 如:6 站 LAN,1、3、4 有数据报,时隙 2、5、6 空闲
3.1.2 FDMA(频分)
FDMA: frequency division multiple access
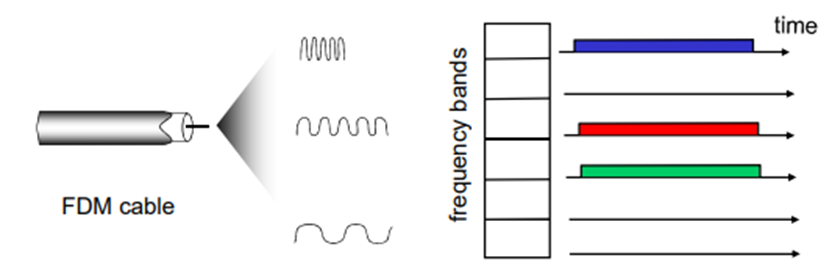
- 信道的有效频率范围被分成一个个小的频段
- 每个站点被分配一个固定的频段
- 分配给站点的频段如果没有被使用,则空闲
- 例如:6 站 LAN,1、3、4 有数据报,频段 2、5、6 空闲
3.2 随机访问协议
- 当节点有帧要发送时
- 以信道带宽的全部 R bps 发送
- 没有节点间的预先协调
- 两个或更多节点同时传输,会发生冲突
- 随机存取协议规定:
- 如何检测冲突
- 如何从冲突中恢复(如:通过稍后的重传)
- 随机 MAC 协议:
- ALOHA,时隙 ALOHA
- CSMA,CSMA/CD,CSMA/CA
3.2.1 时隙 ALOHA
假设:
- 所有帧是等长的
- 时间被划分成相等的时隙,每个时隙可发送一帧
- 节点只在时隙开始时发送帧
- 节点在时钟上是同步的
- 如果两个或多个节点在一个时隙传输,所有的站点都能检测到冲突
运行:
- 当节点获取新的帧,在下一个时隙传输
- 传输时没有检测到冲突,成功
- 节点能够在下一时隙发送新帧
- 检测时如果检测到冲突,失败
- 节点在每一个随后的时隙以概率 \(p\) 重传帧直到成功
- 退避机制,避免持续冲突
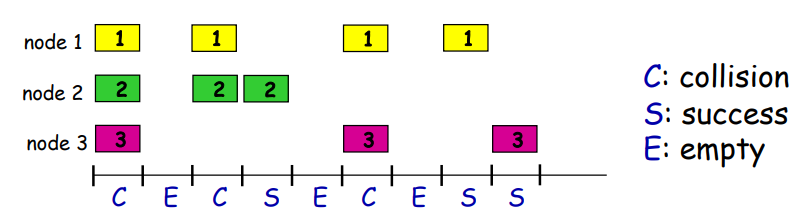
优点:
- 节点可以以信道带宽全速连续传输
- 高度分布:仅需要节点之间在时隙上的同步
- 简单
缺点:
- 存在冲突,浪费时隙
- 即使有帧要发送,仍然有可能存在空闲的时隙(概率问题)
- 检测碰撞的时间远小于发送整个数据包的时间,但不能及时止损
- 需要时钟上同步
时隙 ALOHA 的效率
当有很多节点,每个节点有很多帧要发送时,\(x\) % 的时隙是成功传输帧的时隙
- 假设 \(N\) 个节点,每个节点都有很多帧要发送,在每个时隙中的传输概率是 \(p\)
- 一个节点成功传输概率是 \(p(1-p)^{N-1}\)
- 任何一个节点的成功概率是 \(Np(1-p)^{N-1}\)
- \(N\) 个节点的最大效率:求出使 \(f(P) = Np(1-p)^{N-1}\) 最大的 \(p^*\)
- 代入 \(p^*\) 得到最大 \(f(p^*) = Np^*(1-p^*)^{N-1}\)
- \(N\) 为无穷大时的极限为 \(1/e = 0.37\)
最好情况:信道利用率 37%
3.2.2 CSMA(载波侦听多路访问)
入手点:发之前不管有无其他节点在传输
CSMA: 在传输前先侦听信道:
- 如果侦听到信道空闲,传送整个帧
- 如果侦听到信道忙,推迟传送
- 人类类比:不要打断别人正在进行的说话!
冲突仍然可能发生:
- 由传播延迟造成:两个节点可能侦听不到正在进行的传输
- 冲突:整个冲突帧的传输时间都被浪费了,是无效的传输(图中红黄区域)
- 传播延迟(距离)决定了冲突的概率
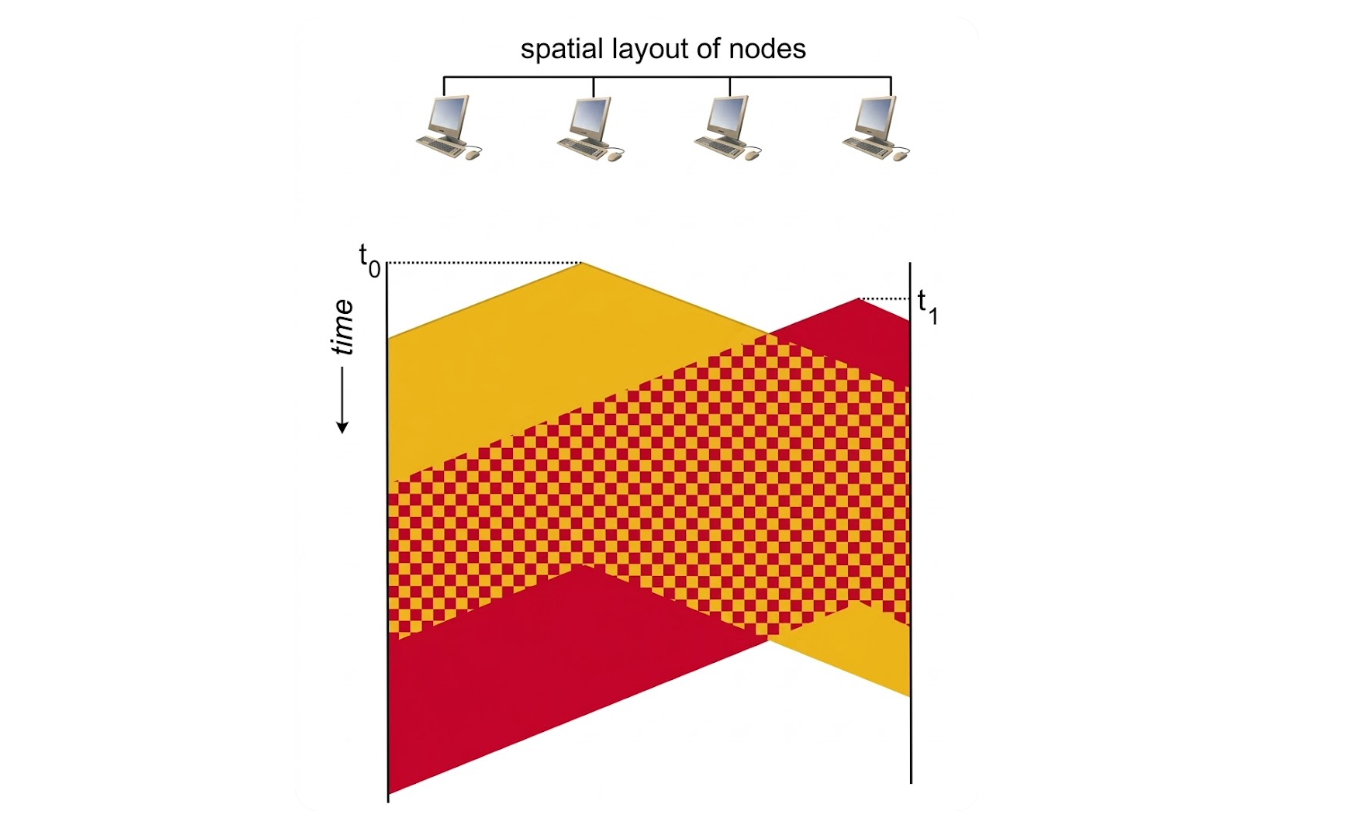
电磁波在空间中的传播
3.2.3 CSMA/CD(冲突检测)
- CSMA/CD(CS:事前侦听;CD:边说边听)
- 和在 CSMA 中一样发送前侦听信道
- 没有传完一个帧就可以在短时间内检测到冲突
- 冲突发生时则传输终止,减少对信道的浪费
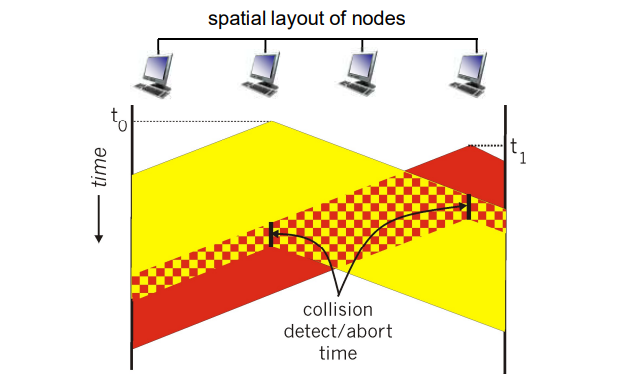
对信道的浪费减少了
以太网 CSMA/CD 算法
- 适配器获取数据报,创建帧
- 发送前:侦听信道 “CS”
- 闲:开始传送帧
- 忙:一直等到闲再发送
- 发送过程中,冲突检测 “CD”
- 没有冲突:成功
- 检测到冲突:放弃,之后尝试重发
- 发送方适配器检测到冲突,除放弃外,还发送一个
Jam信号,所有听到冲突的适配器也是如此- 强化冲突:让所有站点都知道冲突
- 如果放弃,适配器进入指数退避状态
- 在第 \(m\) 次失败后,适配器随机选择一个 \(\{0, 1, 2, 3, \dots, 2^{m}-1\}\) 中的 \(K\),等待 \(K \times 512\) 位时,然后转到步骤 2
指数退避:
-
目标:适配器试图适应当前负载,在一个变化的碰撞窗口中随机选择时间点尝试重发
- 高负载:重传窗口时间大,减少冲突,但等待时间长
- 低负载:使得各站点等待时间少,但冲突概率大
-
首次碰撞:在 \(\{0, 1\}\) 选择 \(K\);延迟 \(K \times 512\) 位时
-
第 2 次碰撞:在 \(\{0, 1, 2, 3\}\) 选择 \(K\)
-
第 10 次碰撞:在 \(\{0, 1, 2, 3, \dots, 1023\}\) 选择 \(K\)
本质上是在传输延迟和信道利用率之间进行动态的自适应妥协:
- 负载轻时:系统认为不需要妥协,优先保障低延迟(小窗口)
- 负载重时:系统判定当前首要任务是让数据能发出去,因此牺牲延迟,优先保障降低碰撞概率/维持整体吞吐率(大窗口)
3.2.4 线缆接入网络
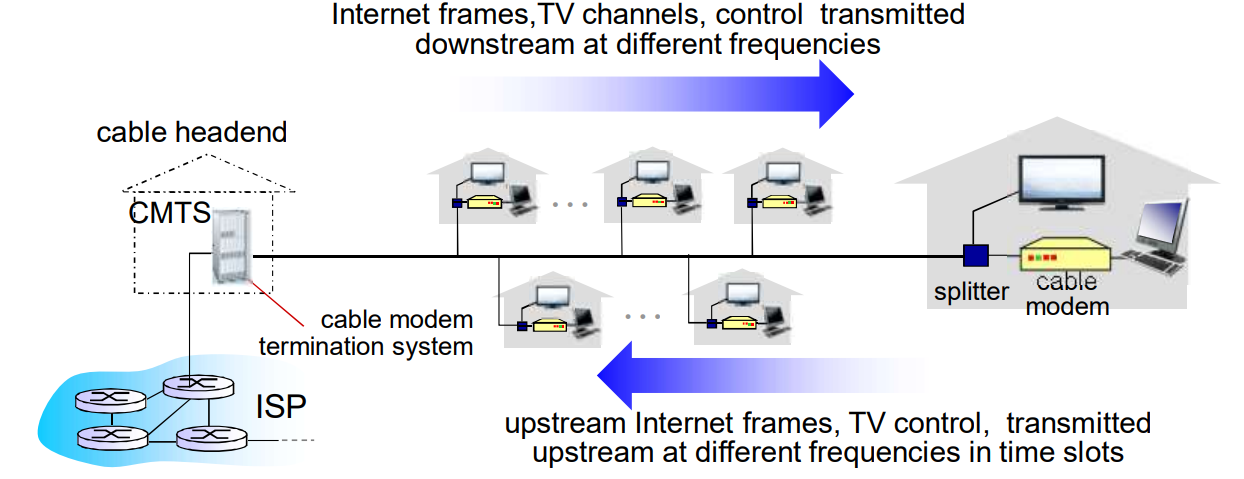
- 多个下行(广播)信道,FDM
- 下行:通过 FDM 分成若干信道,互联网、数字电视等
- 互联网信道:只有 1 个 CMTS 在其上传输(不存在冲突)
- 多个上行的信道,TDM
- 多路访问:
- 所有用户通过竞争(随机接入)来争夺特定的上行信道时隙
- 其余的时隙则采用 TDM 方式进行分配
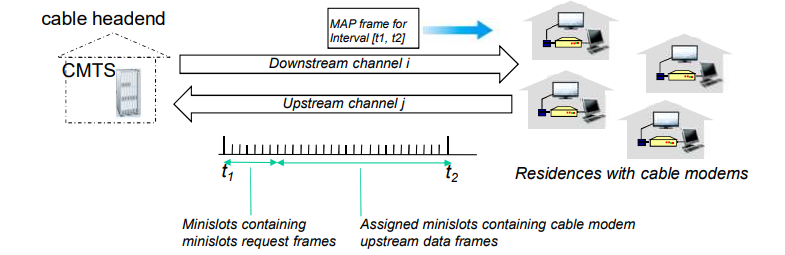
DOCSIS: data over cable service interface spec(电缆服务接口规范)
- 采用 FDM 进行信道的划分:若干上行、下行信道
- 下行信道:
- 在下行 MAP 帧中:CMTS 告诉各节点微时隙分配方案,分配给各站点的上行微时隙
- 另外:头端传输下行数据(给各个用户)
- 采用 TDM 的方式将上行信道分成若干微时隙:MAP 指定
- 站点采用分配给它的微时隙上行数据传输:分配
- 在特殊的上行微时隙中,各站点请求上行微时隙:竞争
- 各站点对于该时隙的使用是随机访问的
- 一旦碰撞(请求不成功,结果是:在下行的 MAP 中没有为它分配,则二进制退避)选择时隙上传输
预约是随机的
3.3 轮流协议
信道划分 MAC 协议
- 共享信道在高负载时是有效和公平的
- 在低负载时效率低下
- 只能等到自己的时隙开始发送或者利用 1/N 的信道频率发送
- 当只有一个节点有帧传时,也只能够得到 1/N 个带宽分配
随机访问 MAC 协议
- 在低负载时效率高:单个节点可以完全利用信道全部带宽
- 高负载时:冲突开销较大,效率极低,时间很多浪费在冲突中
轮流(Taking Turns)MAC 协议:有 2 者的优点!
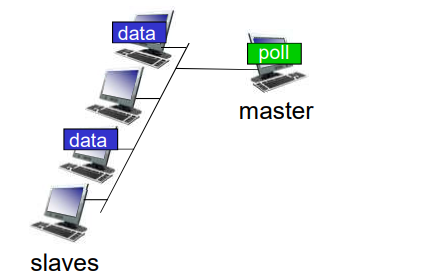
轮询式:
- 主节点邀请从节点依次传送
- 从节点一般比较 “dumb”
- 缺点:
- 轮询开销:轮询本身消耗信道带宽
- 等待时间:每个节点需等到主节点轮询后开始传输,即使只有一个节点,也需要等到轮询一周后才能够发送
- 单点故障:主节点失效时造成整个系统无法工作(可靠性差)
- 蓝牙使用轮询
令牌(环)传递式:
- 控制令牌(token)循环从一个节点到下一个节点传递
- 令牌最后要传递回第一个节点,形成一个环,才被吸收
- 一个发送方可能有多个接收方
- 令牌报文:特殊的帧
- 缺点:
- 令牌开销:本身消耗带宽
- 延迟:只有等到抓住令牌,才可传输
- 单点故障:
- 令牌丢失系统级故障,整个系统无法传输
- 复杂机制重新生成令牌
3.4 MAC 协议总结
- 信道划分:按时间、频率或者编码
- TDMA、FDMA、CDMA
- 随机访问(动态)
- ALOHA,S-ALOHA,CSMA,,CSMA/CD
- 载波侦听:在有些介质上很容易(wire: 有线介质),但在有些介质上比较困难(wireless: 无线)
- CSMA/CD:802.3 Ethernet 网中使用
- CSMA/CA:802.11 WLAN 中使用
- 依次轮流协议
- 集中:由一个中心节点轮询;分布:通过令牌控制
- 蓝牙、FDDI、令牌环
4 LANs
4.1 MAC 地址和 ARP
这里的 MAC 区别于之前的 MAC (Media Access Control,介质访问控制)
4.1.1 IP 地址和 MAC 地址
- 32bit IP 地址:
- 网络层地址
- 前 n-1 跳:用于使数据报到达目的 IP 子网
- 最后一跳:到达子网中的目标节点
- 最后一跳时 IP 地址的主机号才起作用
- LAN(MAC/物理/以太网)地址:
- 用于使帧从一个网卡传递到与其物理连接的另一个网卡(在同一个物理网络中)
- 48bit MAC 地址固化在适配器的 ROM,有时也可以通过软件设定
- e.g.: 1A-2F-BB-76-09-AD
IP 地址和 MAC 地址的作用不同
- IP 地址是分层的
- 一个子网所有站点网络号一致,路由聚集,减少路由表
- 希望网络层地址是配置的;IP 地址完成网络到网络的交付
- MAC 地址是一个平面的
- 网卡在生产时不知道被用于哪个网络,因此给网卡一个唯一的标示,用于区分一个网络内部不同的网卡即可
- 可以完成一个物理网络内部的节点到节点的数据交付
网络地址和 MAC 地址分离
- 分离好处
- 网卡坏了,IP 不变,可以捆绑到另外一个网卡的 MAC 上
- 物理网络还可以除 IP 之外支持其他网络层协议,链路协议为任意上层网络协议,如 IPX 等
- 捆绑的问题
- 如果仅仅使用 IP 地址,不用 MAC 地址,那么它仅支持 IP 协议
- 每次上电都要重新写入网卡 IP 地址
- 另外一个选择就是不使用任何地址;不用 MAC 地址,则每到来一个帧都要上传到 IP 层次,由它判断是不是需要接受,干扰一次
局域网上每个适配器:
- 一个唯一的 MAC 地址
- 一个局域网内唯一的 IP 地址
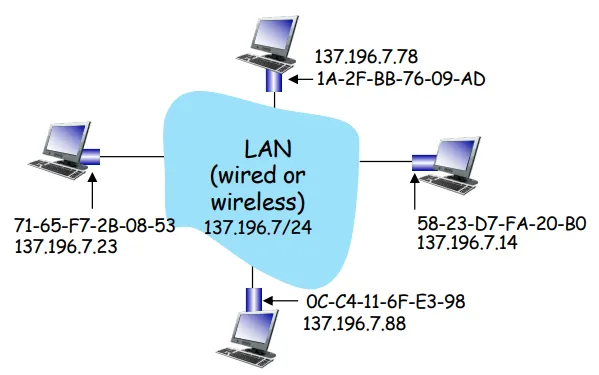
- MAC 平面地址 ➜ 支持移动
- 可以将网卡到接到其它网络
- IP 地址有层次 ➜ 不能移动
- 依赖于节点连接的 IP 子网,与子网的网络号相同(有与其相连的子网相同的网络前缀)
4.1.2 ARP
ARP: address resolution protocol(地址解析协议)
- 在 LAN 上的每个 IP 节点都有一个 ARP 表
- ARP 表:包括一些 LAN 节点 IP/MAC 地址的映射
<IP address; MAC address; TTL>- TTL 时间是指地址映射失效的时间,典型是 20min
A 要发送帧给 B(IP 地址已知),但 B 的 MAC 地址不在 A 的 ARP 表中:
- A 广播包含 B 的 IP 地址的 ARP 查询包
- Dest MAC address = FF-FF-FF-FF-FF-FF
- LAN 上的所有节点都会收到该查询包
- B 接收到 ARP 包,回复 A 自己的 MAC 地址
- 帧发送给 A
- 用 A 的 MAC 地址(单播)
- A 在自己的 ARP 表中,缓存 IP-to-MAC 地址映射关系,直到信息超时
- 软状态: 靠定期刷新维持的系统状态
- 定期刷新周期之间维护的状态信息可能和原有系统不一致
- 存是为了查得快,删是为了适应 IP 地址的动态变化
- ARP 是即插即用的
- 节点自己创建 ARP 的表项
- 无需网络管理员的干预
4.1.3 路由到其他 LAN(例子)
发送数据报:由 A 通过 R 到 B,假设 A 知道 B 的 IP 地址
- A 如何知道第一跳路由器 R 的 IP 地址?
- 通过 DHCP 自动分配一个 “默认网关”,这个网关就是它访问本子网外目标时必须经过的第一跳路由器
- A 如何知道 R 的 MAC 地址?
- 通过 ARP 协议
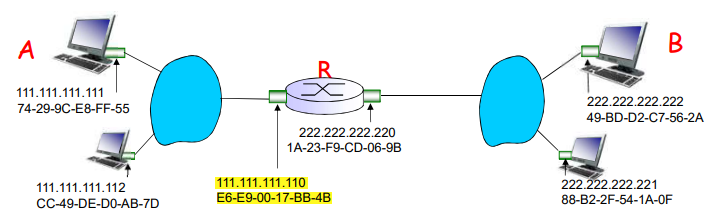
- 在 R 上有两个 ARP 表,分别对应两个 LAN
- 在源主机的路由表中,发现到目标主机的下一跳是 111.111.111.110
- 在源主机的 ARP 表中,发现其 MAC 地址是 E6-E9-00-17-BB-4B
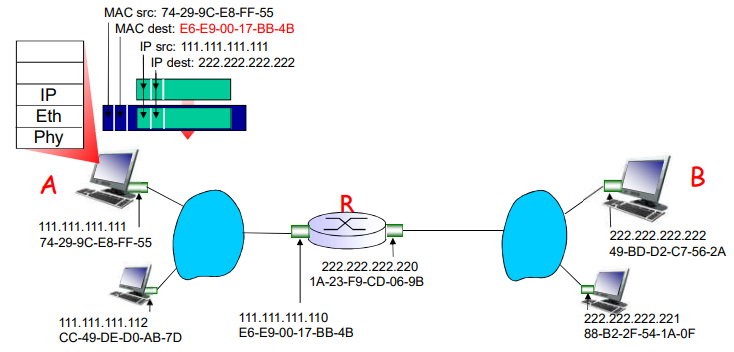
- A 创建数据报,源 IP 地址:A;目标 IP 地址:B
- A 创建一个链路层的帧,目标 MAC 地址是 R,该帧包含 A 到 B 的 IP 数据报
- 帧从 A 发送到 R
- 帧被 R 接收到,从中提取出 IP 分组,交给上层 IP 协议实体
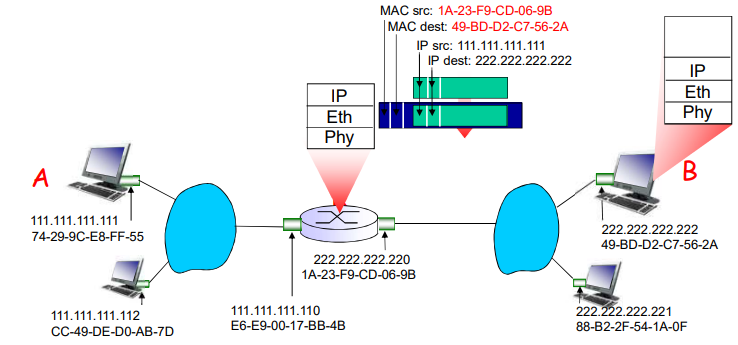
- R 转发数据报,数据报源 IP 地址为 A,目标 IP 地址为 B
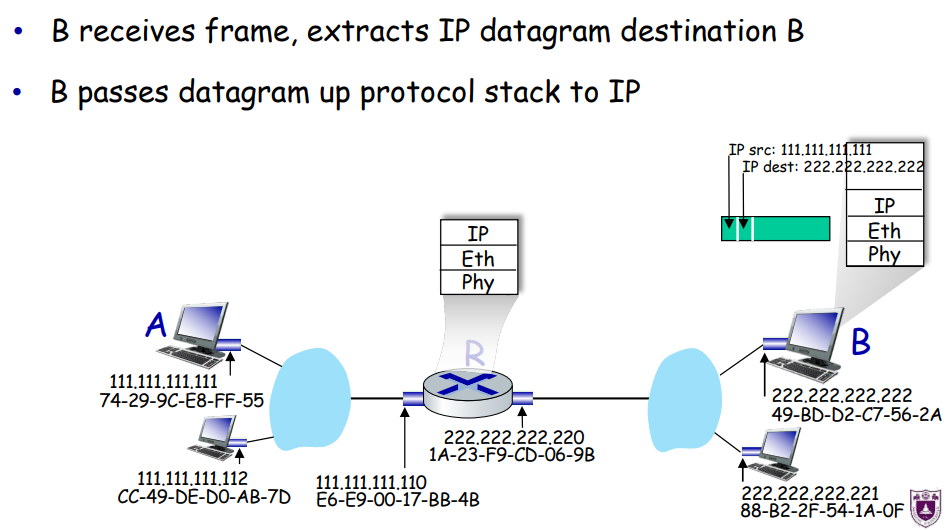
- R 创建一个链路层的帧,目标 MAC 地址为 B,帧中包含 A 到 B 的 IP 数据报
- 传输链路层帧
4.2 以太网
- 目前 最主流的 LAN 技术
4.2.1 物理拓扑
-
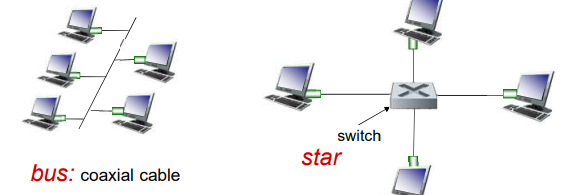
总线型拓扑
- 所有节点处于同一个冲突域,节点之间会发生数据碰撞
-
交换型拓扑:目前占据主导地位
- 中心部署有源二层交换机
- 每个 “辐条” 链路运行独立的以太网协议,节点之间不会发生碰撞
4.2.2 以太帧结构
发送方适配器在以太网帧中封装 IP 数据报,或其他网络层协议数据单元
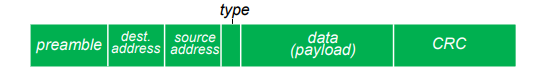
- 前导码:
- 用来同步接收方和发送方的时钟速率
- 地址:6 字节源 MAC 地址,目标 MAC 地址
- 若帧目标地址 = 本站 MAC 地址,或是广播地址,接收,递交帧中的数据到网络层
- 否则,适配器忽略该帧
- 类型:指出高层协议
- 大多情况下是 IP,但也支持其它网络层协议
- 用于在接收端上行解复用
- CRC:在接收方校验
- 如果没有通过校验,丢弃错误帧
4.2.3 以太网:无连接、不可靠的服务
- 无连接:帧传输前,发送方和接收方之间没有握手
- 不可靠:接收方适配器不发送 ACKs 或 NAKs 给发送方
- 如果发生了丢包,数据能不能被恢复,完全取决于最开始的发送方有没有使用像 TCP 这样具备可靠传输机制的上层协议
- 以太网的 MAC 协议:采用二进制退避的 CSMA/CD 介质访问控制形式
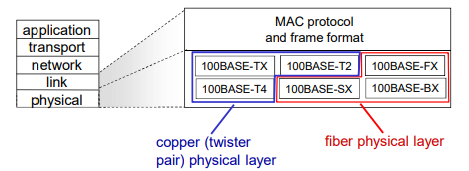
- 很多不同的以太网标准
- 相同的 MAC 协议(介质访问控制)和帧结构
- 不同的速率:2 Mbps、10 Mbps 、100 Mbps 、1Gbps、10Gbps
- 不同的物理层媒介:光纤,同轴电缆和双绞线
4.4 交换机
4.4.1 Switch
- 链路层设备:扮演主动角色(端口执行以太网协议)
- 对帧进行存储和转发
- 对于到来的帧,检查帧头,根据目标 MAC 地址进行选择性转发
- 当帧需要向某个(些)网段进行转发,需要使用 CSMA/CD 进行接入控制
- 通常一个交换机端口一个独立网段
- 透明:主机对交换机的存在可以不关心(网络层上看“一跳可达”)
- 通过交换机相联的各节点好像这些站点是直接相联的一样
- 有 MAC 地址;无 IP 地址
- 即插即用,自学习:
- 交换机无需配置
4.4.2 多路同时传输
- 主机有一个专用和直接到交换机的连接
- 交换机缓存到来的帧
- 对每个帧进入的链路使用以太网协议
- 没有碰撞;全双工
- 每条链路都是一个独立的碰撞域
- MAC 协议在其中的作用弱化了
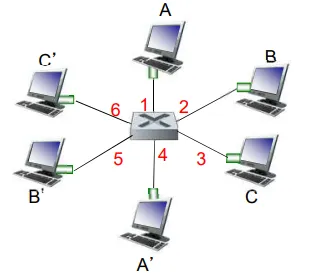
- 交换:A-to-A’ 和 B-to-B’ 可以同时传输,没有碰撞
- 但 A-to-A’ 和 C-to-A’ 不能同时传输
4.4.3 自学习
- Q: 交换机如何知道通过接口 1 到达 A,通过接口 5 到达 B′?
- A: 每个交换机都有一个交换表 switch table,每个表项:
- (主机的 MAC 地址,到达该 MAC 经过的接口,时戳)
- 比较像路由表!
- Q: 每个表项是如何创建的?如何维护的?
- 有点像路由协议?
交换机通过学习得到哪些主机(MAC 地址)可以通过哪些端口到达
- 当接收到帧,交换机学习到发送站点所在的端口(网段)
- 记录发送方源 MAC 地址 / 进入端口映射关系,在交换表中
| MAC addr | interface | TTL |
|---|---|---|
| A | 1 | 60 |
当交换机收到一个帧:
- 记录进入链路,发送主机的 MAC 地址(自学习)
- 使用目标 MAC 地址对交换表进行索引(目的地查表)
- 决策逻辑(过滤 / 转发 / 泛洪)
if entry found for destination
then {
  if dest on segment from which frame arrived
  then drop the frame // 过滤
  else forward the frame on interface indicated // 转发
}
else flood // 泛洪,除了帧到达的网段,向所有网络接口
- 过滤
- 如果查表发现,目标设备所在的端口,是刚刚接收这个帧的端口,交换机会选择丢弃这个帧
- 转发
- 如果查表发现目标设备在其他的端口上,交换机就会直接把这个帧从那个特定的目标端口发送出去
- 泛洪
- 在交换表中没有找到目标地址的记录,交换机会把这个数据帧复制,并向除了接收该帧的端口之外的所有其他端口广播发送
- 等回复,再自学习
- 交换机级联也同理
- 在交换表中没有找到目标地址的记录,交换机会把这个数据帧复制,并向除了接收该帧的端口之外的所有其他端口广播发送
假设主机 C 向主机 I 发送一个数据帧,随后主机 I 做出响应(回复 C),请展示 \(S_1, S_2, S_3, S_4\) 的交换表变化和数据帧的转发过程。
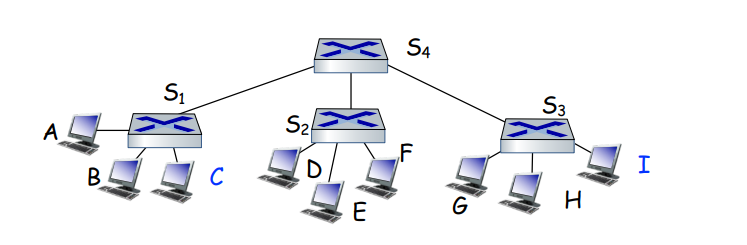
阶段一:C 发送数据帧给 I(C \(\rightarrow\) I)
此时,全网交换机的表都是空的。
- C \(\rightarrow\) \(S_1\):
- \(S_1\) 收到帧,记录源地址:C 在连接 C 的那个端口。
- \(S_1\) 查表发现不知道 I 在哪,于是泛洪。数据帧被发给主机 A、B 以及上联的 \(S_4\)。
- \(S_1\) \(\rightarrow\) \(S_4\):
- \(S_4\) 从连接 \(S_1\) 的端口收到该帧,记录源地址:C 在连接 \(S_1\) 的那个端口。
- \(S_4\) 也不知道 I 在哪,继续泛洪,把帧转发给 \(S_2\) 和 \(S_3\)。
- \(S_4\) \(\rightarrow\) \(S_2\) 和 \(S_3\):
- \(S_2\) 侧:\(S_2\) 收到帧,记录 C 在连接 \(S_4\) 的端口。因为不知道 I 在哪,向主机 D, E, F 泛洪。这三台主机发现目的 MAC 不是自己,直接丢弃该帧。
- \(S_3\) 侧:\(S_3\) 收到帧,记录 C 在连接 \(S_4\) 的端口。因为不知道 I 在哪,向主机 G, H, I 泛洪。
- 到达目的地:主机 I 收到该帧,匹配成功,接收数据。
📌 阶段一结束后的交换表状态: 所有的交换机(\(S_1, S_2, S_3, S_4\))都成功学到了:想要找 C,走通往 \(S_1\) 方向的那个端口就对了。
阶段二:I 做出响应回复 C(I \(\rightarrow\) C)
由于有了阶段一的铺垫,这次数据帧的传输将非常精准,不再需要全网泛洪。
- I \(\rightarrow\) \(S_3\):
- \(S_3\) 收到帧,记录源地址:I 在连接 I 的那个端口(别忘了回复也是要自学习的)。
- \(S_3\) 查找目的地址 C,发现表里有记录(走通往 \(S_4\) 的端口),于是精准单播(Unicast)转发给 \(S_4\)。
- \(S_3\) \(\rightarrow\) \(S_4\):
- \(S_4\) 收到帧,记录源地址:I 在连接 \(S_3\) 的那个端口。
- \(S_4\) 查找目的地址 C,表里有记录(走通往 \(S_1\) 的端口),精准单播转发给 \(S_1\)。(注意:此时 \(S_2\) 根本不会收到这个球,D, E, F 非常清静)。
- \(S_4\) \(\rightarrow\) \(S_1\):
- \(S_1\) 收到帧,记录源地址:I 在连接 \(S_4\) 的那个端口。
- \(S_1\) 查找目的地址 C,表里有记录,直接精准送达主机 C。
当这两个步骤完成后,各交换机的表中关于 C 和 I 的记录如下:
| 交换机 | 认识 C 的路径 | 认识 I 的路径 |
|---|---|---|
| \(S_1\) | 来自本地直连端口 | 来自通往 \(S_4\) 的上联端口 |
| \(S_4\) | 来自通往 \(S_1\) 的端口 | 来自通往 \(S_3\) 的端口 |
| \(S_3\) | 来自通往 \(S_4\) 的上联端口 | 来自本地直连端口 |
| \(S_2\) | 来自通往 \(S_4\) 的上联端口 | (不认识 I,因为 I 回复的包没经过 \(S_2\)) |
这就是自学习多交换机协同的奇妙之处:每个交换机不需要知道整个网络的拓扑全貌,它们只需要各司其职,记住“从哪个口能去往哪个 MAC 地址”即可。
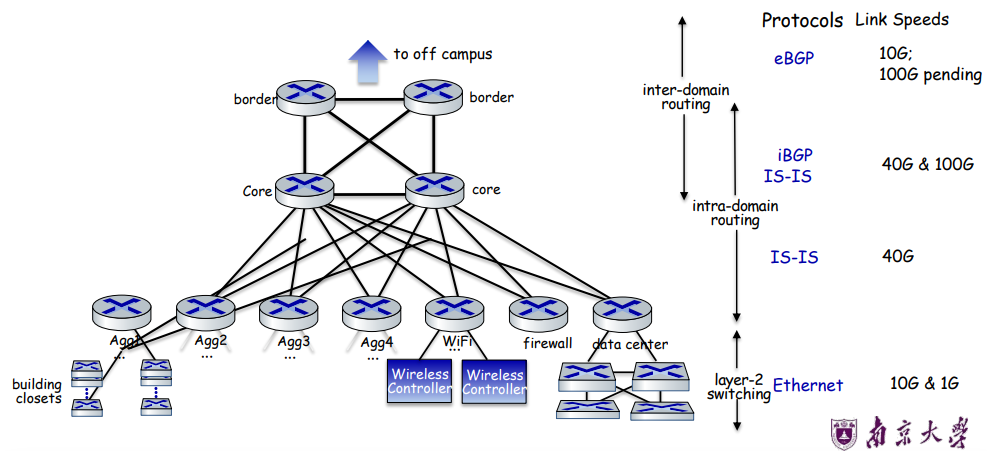
UMass Campus Network - Detail
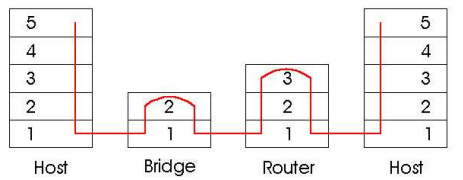
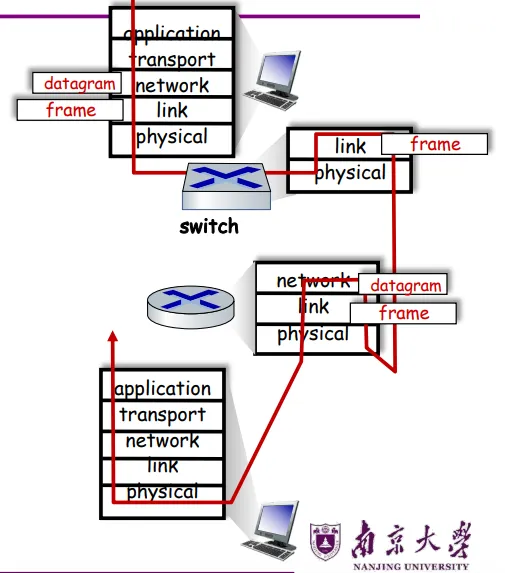
4.4.4 交换机 vs 路由器
- 都是存储转发设备,但层次不同
- 交换机:链路层设备(检查链路层头部)
- 路由器:网络层设备(检查网络层的头部)
- 都有转发表:
- 交换机:使用泛洪和自学习算法,MAC 地址计算转发表
- 路由器:使用路由算法,IP 地址计算路由表
4.5 虚拟局域网 (VLANs)
单一广播域:
- 扩展性:所有二层广播流量(ARP、DHCP、未知 MAC)必须穿越整个局域网
- 效率、安全、隐私问题
管理问题:
- CS 用户将办公室搬到 EE - 物理上连接到 EE 交换机,但希望保持逻辑上连接到 CS 交换机
虚拟局域网 (VLAN)
- 支持 VLAN 功能的交换机可以被配置为在单一物理局域网基础设施上定义多个虚拟局域网
基于端口的 VLAN
- 通过(交换机管理软件)对交换机端口进行分组,使得单个物理交换机作为多个虚拟交换机运行
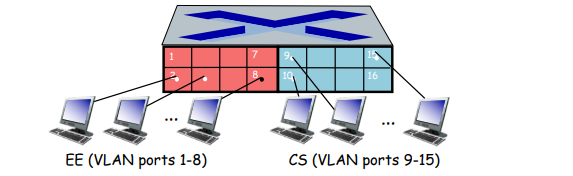
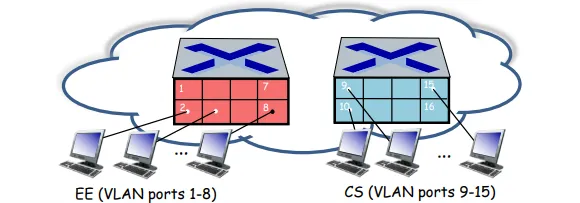
- 流量隔离:进出端口 1-8 的帧只能到达端口 1-8
- 也可以基于端点的 MAC 地址而不是交换机端口来定义 VLAN
- 动态成员资格:端口可以在 VLAN 之间动态分配
- VLAN 间转发:通过路由完成(就像独立的交换机一样)
- 在现实中,供应商出售交换机和路由器的组合设备
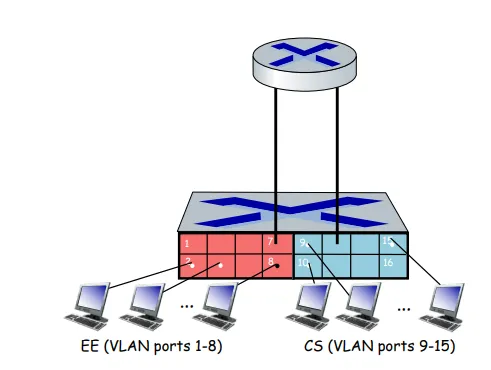
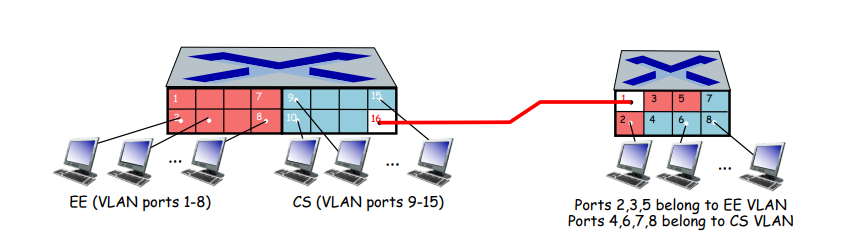
- 干道端口:在定义于多个物理交换机之间的 VLAN 中传输帧
- 在交换机之间的 VLAN 内部转发的帧不能是标准的 802.1 帧(必须携带 VLAN ID 信息)
- 802.1q 协议为在干道端口之间转发的帧添加/移除额外的头部字段
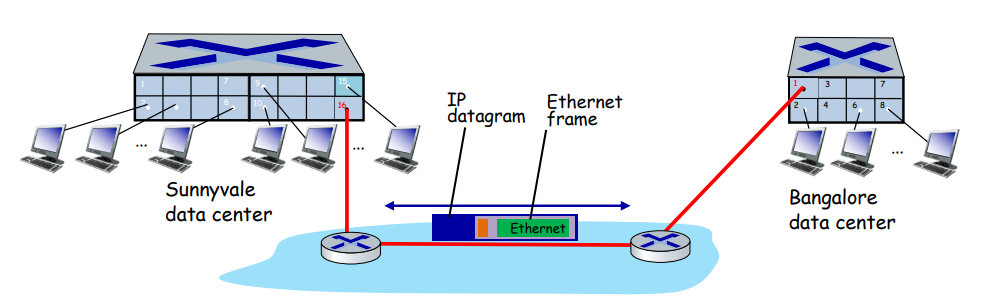
EVPN:以太网 VPN(又名 VXLAN)
二层以太网交换机在逻辑上相互连接(例如,使用 IP 作为底层网络)
- 站点之间在 IP 数据报中承载以太网帧
- “一种在三层网络之上叠加二层网络的隧道方案……运行在现有的网络基础设施之上,并提供了一种‘延伸’二层网络的手段。”
5 链路虚拟化:MPLS
MPLS: multi-protocol label switching(多协议标签交换)
目标:在支持 MPLS 的路由器网络中实现高速 IP 转发,使用固定长度的标签(代替最长前缀匹配)
- 使用固定长度标识符进行更快的查找
- 借鉴虚电路 (VC) 方法的思想
- 但 IP 数据报仍然保留 IP 地址
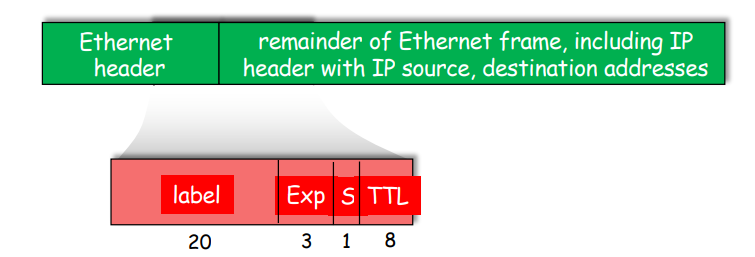
支持 MPLS 的路由器(标签交换路由器)
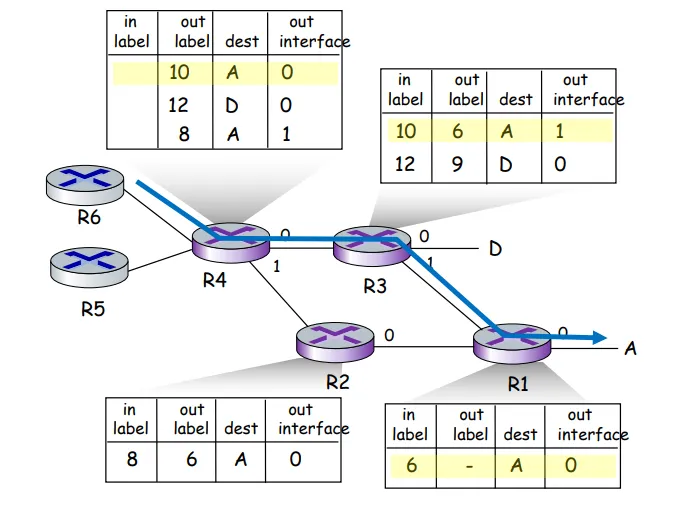
- 仅根据标签值将数据包转发到传出接口(不检查 IP 地址)
- MPLS 转发表不同于 IP 转发表
- 灵活性:MPLS 转发决策可以与 IP 不同
- 使用目的地址和源地址将流向同一目的地的流以不同方式路由(流量工程)
- 如果链路发生故障,快速重新路由流:预先计算的备份路径
MPLS vs IP paths
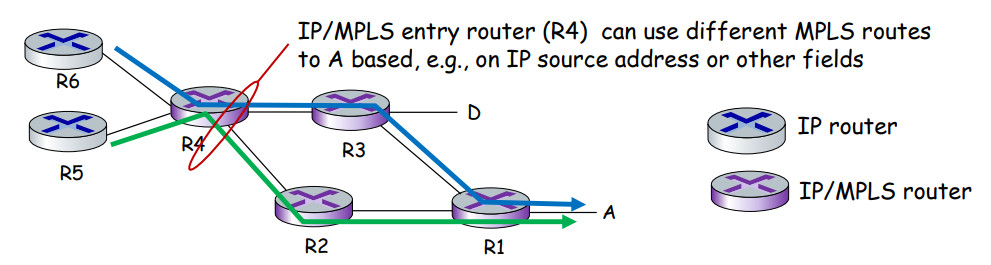
- IP 路由:通往目的地的路径仅由目的地址决定
- MPLS 路由:通往目的地的路径可以基于源地址和目的地址
- 通用转发的一种形式
- 快速重路由:预先计算备份路由以应对链路故障
MPLS 信令
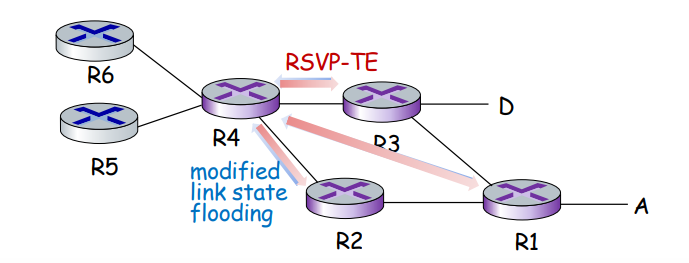
- 修改 OSPF、IS-IS 链路状态泛洪协议,以携带 MPLS 路由所需的信息:
- 例如,链路带宽、“已预留”链路带宽的数量
- 入口 MPLS 路由器使用 RSVP-TE 信令协议在下行路由器上建立 MPLS 转发
MPLS 转发表
6 数据中心网络
- 数万-数十万台主机构成,密集耦合、距离临近:
- 电子商务
- 内容服务器
- 搜索引擎,数据挖掘
- 挑战:
- 多种应用,每一种都服务海量的客户端
- 管理/负载均衡,避免处理、网络和数据的瓶颈
在交换机之间,机器阵列之间有丰富的互连措施
- 在阵列之间增加吞吐(多个可能的路由路径)
- 通过冗余度增加可靠性
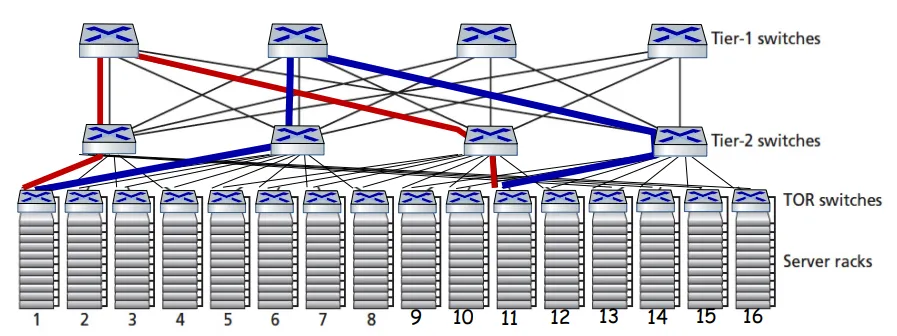
在机架 1 和 11 之间突出显示两条不相交的路径
负载均衡器:应用层路由
- 接受外部的客户端请求
- 将请求导入到数据中心内部
- 返回结果给外部客户端(对于客户端隐藏数据中心的内部结构)
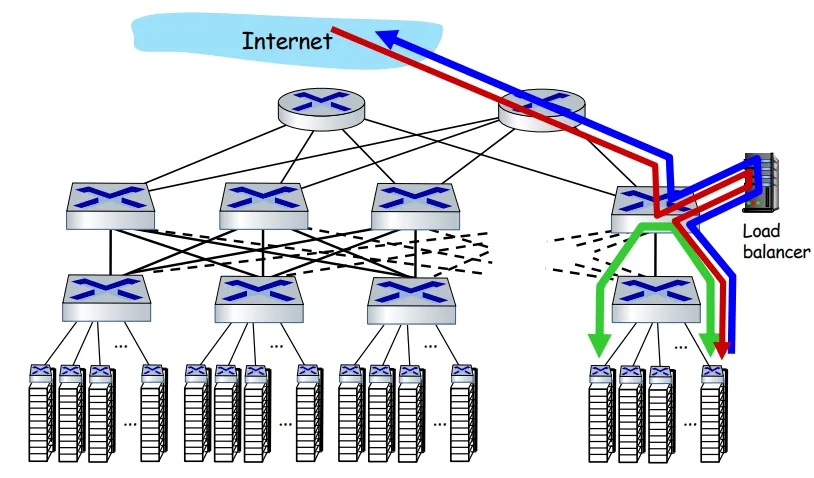
数据中心网络:协议创新
- 链路层:
- RoCE:融合以太网上的远程 DMA (RDMA)
- 传输层:
- ECN(显式拥塞通知)用于传输层拥塞控制(DCTCP, DCQCN)
- 逐跳(反压)拥塞控制的实验
- 路由,管理:
- SDN 广泛用于组织内部/之间的数据中心
- 将相关服务、数据尽可能放置在一起(例如,在同一机架或附近的机架),以最大限度地减少二层(tier-2)、一层(tier-1)通信
ORION: Google’s new SDN control plane for internal datacenter (Jupiter) + wide area (B4) network
- 路由(域内,iBGP),流量工程:在 ORION 核心之上的应用程序中实现
- 边缘到边缘的基于流的控制(例如,CoFlow 调度)以满足合同 SLA
- 管理:Orion 核心中的发布-订阅(pub-sub)分布式微服务,用于交换机信令/监控的 OpenFlow
注:
- 没有路由协议,拥塞控制(部分)也由 SDN 管理,而不是由协议管理
- 协议正在消亡吗?
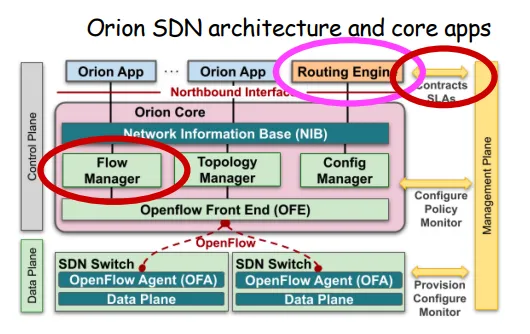
这一页课件进入了现代大规模互联网架构的硬核领域,讲解的是 Google 的 ORION 系统——这是 Google 用来统一管理其数据中心内部网络(Jupiter)和跨数据中心广域网(B4)的软件定义网络(SDN)控制平面。
传统网络靠每台交换机“各自为政”地跑分布式路由协议,而 Google 的思路是:通过一个中心化的超级大脑(SDN 控制器),去直接操控全网的所有交换机。
我们可以结合左侧的文本和右侧的架构图,从以下三个核心维度来理解:
1. ORION 的三大核心功能与架构映射
右侧的架构图展示了一个经典的 SDN 三层架构(自上而下:应用层 \(\rightarrow\) 控制平面 \(\rightarrow\) 数据平面)。左侧的三个点正好对应了图中的红圈部分:
1️⃣ 路由与流量工程(Routing & Traffic Engineering)
- 课件称:
routing (intradomain, iBGP), traffic engineering: implemented in applications on top of ORION core - 如何理解:在传统网络中,BGP 或 OSPF 路由协议是跑在每个物理路由器上的。但在 ORION 架构中,路由和流量工程(TE)被解耦出来,变成了运行在 ORION Core 之上的“上层应用程序”(即右图红圈的 Routing Engine)。这个引擎在全球视角下计算出最优路径,再下发给底层。
2️⃣ 边缘到边缘的流控(Edge-edge flow-based controls)
- 课件称:
edge-edge flow-based controls (e.g., CoFlow scheduling) to meet contract SLAs - 如何理解:数据中心有大量的分布式任务(比如 MapReduce/Spark 产生的 Shuffle 流量)。ORION 通过 Flow Manager(流量管理器,图左侧红圈)进行端到端的流调度(如 CoFlow 算法)。它能根据业务的 SLA(服务等级协议,右侧红圈的
Contracts SLAs),确保高优先级的业务不卡顿,大数据搬运任务有序进行,最大化拓扑带宽利用率。
3️⃣ 分布式管理与底座(Management)
- 课件称:
management: pub-sub distributed microservices in Orion core, OpenFlow for switch signaling/monitoring - 如何理解:Orion Core 内部是一个基于 发布-订阅(Pub-Sub) 模式的分布式微服务系统,围绕着 NIB(Network Information Base,网络信息库) 运转。
- 核心层通过 OpenFlow 前端(OFE) 与底层的物理数据平面(Data Plane)通信。
- 底层的 SDN Switch 上运行着 OFA(OpenFlow Agent),它们不运行复杂的路由协议,只负责听从 Orion 的 OpenFlow 指令去刷转发表,并把自身的链路状态、拥塞情况上报给控制层。
2. 底部 Note 的灵魂拷问:协议将死?(Are protocols dying?)
课件底部的 Note 提出了一个极具颠覆性的行业趋势:
no routing protocols, congestion control (partially) also managed by SDN rather than by protocol
- 消灭传统的路由协议:在 Orion 管辖的网络里,传统物理设备之间不再运行复杂的、收敛缓慢的分布式路由协议(如传统的 OSPF/IS-IS)。路径全由 Orion 算好直接下发。
- 接管拥塞控制:甚至连传统依赖 TCP 握手/滑动窗口/丢包反馈的传统拥塞控制,也被 SDN 控制器通过全局视角的流量调度机制给部分替代了。
❓ 那么,“Are protocols dying?”(协议要死了吗?)
这其实是老师留下的思考题。答案是:没有死,而是重构/集中化了。
- 传统的分布式网络协议在大规模单一实体(如 Google、Meta 的私有云)内部确实在被削弱或取代,取而代之的是由集中式控制器直接下发流表(Flow Table)。
- 但是,控制器内部、控制器与交换机之间(如 OpenFlow、gRPC、P4)、以及不同自治域(AS)之间的跨界互联(公网 BGP),依然高度依赖协议。只是协议的重心从“分布式计算路径”变成了“中心化状态上报与管控指令下发”。
💡 总结一句话
Google 的 ORION 课件展示了现代超大规模数据中心网络的设计终局:把网络设备的“大脑(控制面)”完全抽离并集群化,变成运行在服务器上的分布式微服务系统;而底层的交换机彻底降级为只管干苦力、听话转发的“肢体(数据面)”。
标题:6 链路层和局域网
作者:Zwing
创建于:2026-08-08 06:46:13
更新于:2026-08-07 23:07:52
链接:https://zanytriumph.github.io/posts/6 链路层和局域网.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可