
5 网络层:控制平面
转发: 将数据包从路由器的输入端口移动到合适的输出端口 → 数据平面 路由: 决定数据包从源端到目的端所经过的路径 → 控制平面
构建网络控制平面的两种方法:
- 传统路由器控制(Per-router control):每台路由器内部都包含独立的路由算法组件,各路由器在控制平面中进行逻辑上的交互
- 逻辑集中式控制(SDN):由远程控制器统一计算路由,并将转发表下发安装到各个路由器中
1 路由选择算法
1.1 路由 (route) 的概念
-
路由:按照某种指标找到一条从源节点到目标节点的较好路径
- 指标: 站数,延迟,费用,队列长度等,或者是一些单纯指标的加权平均
-
以网络为单位进行路由(路由信息通告 + 路由计算)
- 网络为单位进行路由,路由信息传输、计算和匹配的代价低
- 前提条件是:一个网络所有节点地址前缀相同,且物理上聚集
- 路由就是:计算网络到其他网络如何走的问题
-
网络到网络的路由 = 路由器 - 路由器之间路由
- 网络对应的路由器到其他网络对应的路由器的路由
- 在一个网络中:路由器 - 主机之间的通信(第一跳或者最后一跳),链路层解决
- 到了这个路由器就是到了这个网络
-
路由选择算法: 网络层软件的一部分,完成路由功能
1.2 路由选择算法引入
网络的图抽象
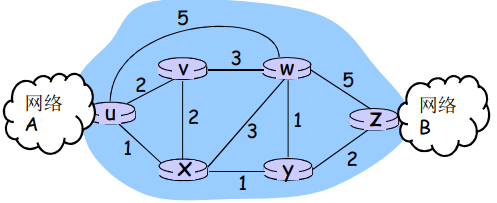
- 图: \(G = (N,E)\)
- \(N =\) 路由器集合 \(= \{ u, v, w, x, y, z \}\)
- \(E =\) 链路集合 \(= \{ (u,v), (u,x), (v,x), (v,w), (x,w), (x,y), (w,y), (w,z), (y,z) \}\)
- \(c(x,x')\) = 链路(边)的代价 \((x,x')\)
- 代价可能总为1
- 或是 链路带宽的倒数
- 或是 拥塞情况的倒数
路由的输入:拓扑、边的代价、源节点 路由的输出:源节点的汇集树
- 汇集树(最小代价树)
- 此节点到所有其它节点的最优路径形成的树
- 路由选择算法就是为所有路由器找到并使用汇集树
路由算法分类
全局:
- 所有的路由器拥有完整的拓扑和边的代价的信息
- “link state” LS 算法
分布式:
- 路由器只知道与它有物理连接关系的邻居路由器,和到相应邻居路由器的代价值
- 迭代地与邻居交换路由信息、计算路由信息
- “distance vector” DV 算法
静态:
- 路由随时间变化缓慢
- 非自适应算法:不能适应网络拓扑和通信量的变化,路由表是事先计算好的
动态:
- 路由变化很快
- 周期性更新
- 根据链路代价的变化而变化
- 自适应路由选择:能适应网络拓扑和通信量的变化
1.3 link state
链路状态路由选择 (link state routing)
1.3.1 发现相邻节点,获知对方网络地址*
- 一个路由器上电之后,向所有线路发送 HELLO 分组
- 其它路由器收到 HELLO 分组,回送应答,在应答分组中,告知自己的名字(全局唯一)
- 在 LAN 中,通过广播 HELLO 分组,获得其它路由器的信息,可以认为引入一个人工节点
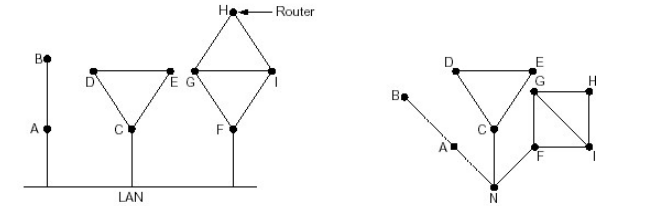
1.3.2 测量到相邻节点的代价*
- 实测法,发送一个分组要求对方立即响应
- 回送一个 ECHO 分组
- 通过测量时间可以估算出延迟情况
1.3.3 组装一个分组,描述相邻节点的情况*
- 发送者名称
- 序号: 版本号,每次发送新的通告,序号加 1
- 年龄: 这个通告的存活时间,防止旧数据永远留在网络里
- 列表: 给出它相邻节点,和它到相邻节点的延迟
1.3.4 将分组通过扩散的方法发到所有其它路由器*
- 顺序号: 用于控制无穷的扩散,每个路由器都记录 (源路由器,序号),根据序号发现重复的或老的就不扩散
- 具体问题1: 循环使用问题
- 具体问题2: 路由器崩溃之后序号从 0 开始
- 具体问题3: 序号出现错误
- 解决问题的办法: 年龄字段 (age)
- 生成一个分组时,年龄字段不为 0
- 每个一个时间段,AGE 字段减 1
- AGE 字段为 0 的分组将被抛弃
1.3.5 通过 Dijkstra 算法找出最短路径
- 路由器获得各站点 LS 分组和整个网络的拓扑
- 通过 Dijkstra 算法计算出到其它各路由器的最短路径 (汇集树)
- 将计算结果安装到路由表中
LS 的应用情况
- OSPF 协议是一种 LS 协议,被用于 Internet 上
- IS-IS: 被用于 Internet 主干中,Netware
符号标记:
- \(c(i,j)\): 从节点 \(i\) 到节点 \(j\) 的链路代价 (初始状态下非相邻节点之间的链路代价为\(∞\))
- \(D(v)\): 从源节点到节点 \(v\) 的当前路径代价
- \(p(v)\): 从源到节点 \(v\) 的路径前序节点
- \(N'\): 当前已经知道最优路径的的节点集合
节点标记: 每一个节点使用 \((D(v),p(v))\) 如:\((3,B)\) 标记
-
算法复杂度(计算层面)
- 基本逻辑:在包含 n 个节点的网络中,算法需要进行 n 次迭代。
- 操作细节:每次迭代都需要检查所有尚未加入集合 N 的节点 w。
- 复杂度结论:这导致总共需要 n(n+1)/2 次比较,因此时间复杂度为 O(n²)。
- 优化空间:存在更高效的实现方式,可以将复杂度降低至 O(n log n)。
-
消息复杂度(通信层面)
- 广播需求:每个路由器必须将其链路状态信息广播给其他 n 个路由器。
- 广播效率:利用高效的广播算法,从单一源点 disseminate(传播)一条广播消息仅需 O(n) 次链路跨越(link crossings)。
- 总体开销:由于每个路由器的消息都需要跨越 O(n) 条链路,整体消息复杂度为 O(n²)。
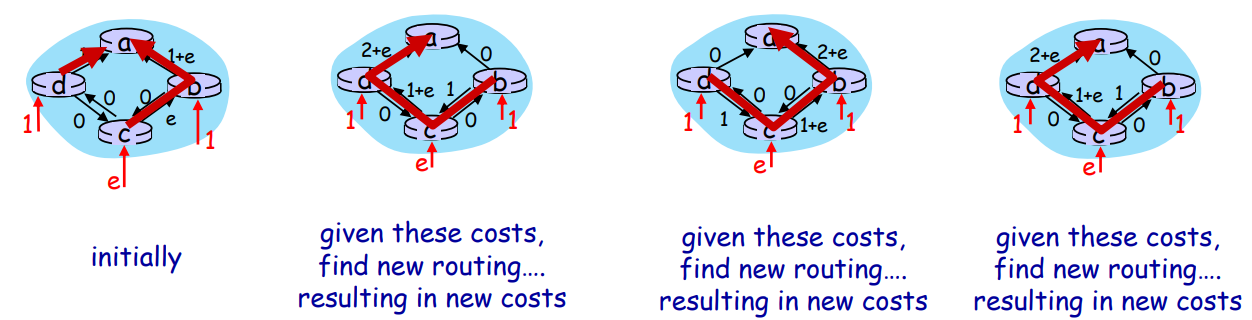
可能的震荡
- 链路代价 = 链路承载的流量
- 一开始计算出最轻载的路径,但由于各个分组均使用这个路径,导致这个路径变为重载,于是又计算出一个新的路径,而这个路径又变为重载,如此循环
1.4 distance vector
距离矢量路由选择 (distance vector routing)
- 动态路由算法之一
- 距离矢量路由选择的基本思想
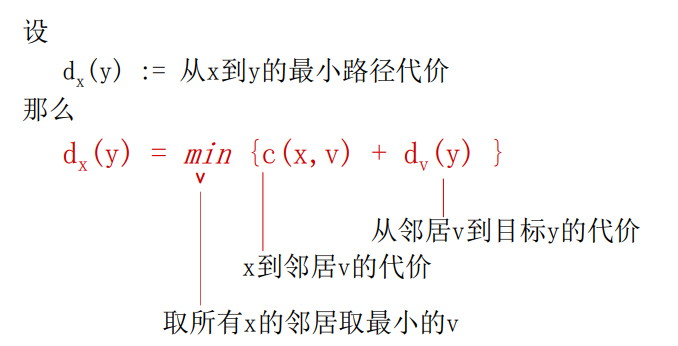
- 各路由器维护一张路由表(To, Next, cost)
- 各路由器与相邻路由器交换路由表
- 根据获得的路由信息,更新路由表
- 代价及相邻节点间代价的获得
- 跳数(hops),延迟(delay),队列长度
- 相邻节点间代价的获得:通过实测
- 路由信息的更新
- 根据实测得到本节点 A 到相邻站点的代价(如:延迟)
- 根据各相邻站点声称它们到目标站点 B 的代价
- 计算出本站点 A 经过各相邻站点到目标站点 B 的代价
- 找到一个最小的代价,和相应的下一个节点 Z,到达节点 B 经过此节点 Z,并且代价为 A-Z-B 的代价
- 其它所有的目标节点一个计算法
每个节点:
- 等待 (本地链路代价变化或者从邻居传送新的 DV 报文)
- 重新计算各目标代价估计值
- 如果到任何目标的 DV 发生变化,通告邻居
异步式、迭代:每次本地迭代被以下事件触发
- 本地链路代价变化了
- 从邻居来了 DV 的更新消息
分布式、自停止:每个节点只是在自己的 DV 改变之后向邻居通告
- 然后邻居们在有必要的时候通知他们的邻居
- 没有收到通知,不做动作
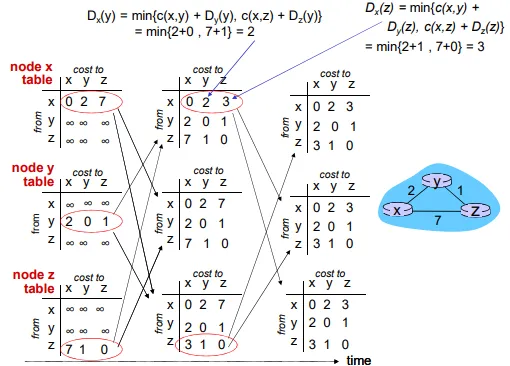 {width=800}
- 第一列:在最开始,每个节点只知道自己到直连邻居的链路代价
- 第二列:
- 所有节点将自己初始的距离向量(自己那一行)发送给直连邻居
- 邻居接收到 DV 后填入路由表,并重新计算自己那一行的代价
- 如有更新则继续通告邻居
- 第三列:没有任何节点的 DV 改变,此时路由表收敛完成
DV 的无穷计算问题
好消息传得快
“好消息”:一个新的节点接入,或者发现了一条更短的路径
场景设定:有一个线型拓扑网络 A - B - C - D - E。假设每个链路的代价(距离)都是 1。现在看各个节点是如何学习到 “前往节点 A 的距离” 的。具体过程:
- 初始状态: 只有 A 知道自己的存在,距离为 0。节点 B、C、D、E 都不知道如何到达 A,所以它们路由表里记录的到达A的距离都是无穷大(\(\infty\))。
- 第 1 次交换后: A 把自己的路由信息告诉了邻居 B。B 发现直接连着 A,于是 B 更新自己到达 A 的距离为 1。
- 第 2 次交换后: B 把 “我到 A 距离是 1” 告诉了 C。C 通过计算得出:我到 B 是 1,B 到 A 是 1,那我经过 B 到 A 的距离就是 2。
- 第 3 次交换后: C 把信息传给 D,D 算出自己到 A的距离是 3。
- 第 4 次交换后: D 把信息传给 E,E 算出自己到 A的距离是 4。
结论:好消息的传播速度是每一个交换周期前进一个路由器。如果网络有 \(N\) 个节点,最多需要 \(N-1\) 次交换,全网就能收敛(都知道了这条好路)。这非常快且高效。
坏消息传得慢(无穷计算问题)
“坏消息”:链路断开,或者代价变大
场景设定:网络原本已经稳定,大家都知道怎么去A(B=1, C=2, D=3, E=4)。突然,A 和 B 之间的链路断开了!(或者 A 宕机了)。
为什么会产生无穷计算?DV算法的一个致命弱点是:路由器只知道到达目的地的距离和下一跳是谁,但不知道完整的路径。具体过程:
- A-B 断开瞬间(第 1 次交换前):B 发现自己直连 A 的路断了,到 A 的距离变成了无穷大(\(\infty\))。
- 第 1 次交换:
- B 正在寻找新的出路,它收到了邻居 C 的路由信息。C 告诉 B:“嘿,我能到达 A,距离是2!”
- 盲点出现: B 根本不知道 C 的这条 “距离为 2” 的路,其实是原路返回必须经过 B 自己的(C \(\rightarrow\) B \(\rightarrow\) A)。B 天真地以为 C 有另一条神奇的路通向 A。
- 于是 B 更新了自己的路由表:我要经过 C 去 A,距离 = C 到 A 的距离 (2) + B 到 C 的距离 (1) = 3。
- (注:课件右下角的公式 =Min(left, right)+1 就是这个意思。B 在左边断路变成 \(\infty\) 和右边 C 的 2 之间取最小值,加上本身的链路开销 1,得到了 3。)
- 第 2 次交换:
- 由于 B 的路由信息变了(从 1 变成了 3),它把新消息告诉了 C。
- C 原本是经过 B 去 A 的。现在 C 听说它的下一跳 B 去 A 的距离变成了 3。
- C 只能无奈地跟着更新:我经过 B 去 A,距离 = B 到 A 的新距离 (3) + C 到 B 的距离(1) = 4。
- 后续交换(Ping-Pong 效应):
- 第 3 次交换:B 收到 C 的更新(C 变成 4 了),B 计算得出 4 + 1 = 5。
- 第 4 次交换:C 收到 B 的更新(B 变成 5 了),C 计算得出 5 + 1 = 6。
- 以此类推,B 和 C 就像踢皮球一样,把到达 A 的距离互相加1,数字越来越大:7, 8, 9…
结论:因为 B 和 C 形成了路由环路(Routing Loop),导致这个错误的信息会在它们之间无限循环递增,直到达到协议规定的“无穷大”值(INF,比如在RIP协议中16被定义为无穷大)。这就是所谓的 “无穷计算问题”。
水平分裂算法*
一种对无穷计算问题的解决办法
严格来说,课件展示的是带有 毒性逆转(Poison Reverse) 的水平分裂算法。
可以用一句大白话来概括这个算法的核心思想:“既然我是从你那儿学来的路线,我就绝不拿这条路线再反过来教你。”
具体逻辑:
-
核心机制:“善意谎言”(毒性逆转)
- 课件原话: “C知道要经过B才能到达A,所以C向B报告它到A的距离为INF;C告诉D它到A的真实距离”
- 详细解释: 在正常情况下,C去往A的路径是 C -> B -> A。C之所以知道怎么去A,完全是因为B告诉了它。
- 如果没有水平分裂: 当A-B断开时,C还会傻乎乎地告诉B:“我到A的距离是2哦”,从而误导B,引发上一页的死循环。
- 有了水平分裂(毒性逆转): C变得聪明了。它制定了一个规则:因为我的下一跳是B,所以在我发给B的路由更新里,我必须撒谎说我到A的距离是无穷大(INF)。 但对于不在这条路径上的邻居D,C依然报告真实的距离。
- 一边虚假,一边真实,“水平分裂”
-
破局过程:坏消息如何干净利落地传播
- 第一次交换:死循环被扼杀在摇篮里
- B发现自己直连A的链路断了,到A的距离变成了INF。
- 这时候B向周围打听出路。C收到了B的询问。
- 关键点来了:根据水平分裂规则,C之前发给B的报告里,一直宣称自己到A的距离是INF。所以B看到C的回复也是INF。
- B心里想:“原来C也去不了A啊”。于是B彻底死心,将自己到A的距离老老实实地保持为 INF。死循环没有发生!
- 第二次交换:C更新自己的状态
- 既然B去A的距离变成了INF,B在下一次交换时,会把这个“坏消息”告诉它的邻居C。
- C一看,自己去A的“下一跳”老大哥B都已经去不了A(INF)了,那自己肯定也去不了了。
- 于是,C也将自己到A的距离更新为 INF。
- 后续传播
- 接着,C再把INF告诉D,D再告诉E……
- 第一次交换:死循环被扼杀在摇篮里
最终结论:
- 课件原话: “…坏消息以一次交换一个路由器的速度传播”
- 详细解释: 采用了水平分裂算法后,“坏消息(链路断开)”不再像之前那样在两个节点之间来回踢皮球(无穷计算),而是像“好消息”一样,非常干脆、迅速地向后方传递。每一个交换周期,就有一个路由器更新为INF,网络迅速收敛到了正确的状态。
水平分裂的问题: 在某些拓扑形式下会失败(存在环路)
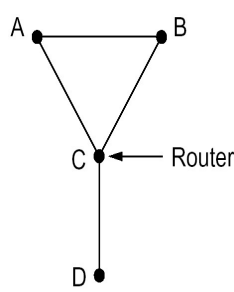
- A,B到D的距离为2,C到D的距离为1
- 如果C-D路径失败
- C获知到D为INF,从A,B获知到D的距离为INF,因此C认为D不可达
- A从C获知D的距离为INF,但从B处获知它到D的距离为2,因此A到B的距离为3,从B走
- B也有类似的问题
- 经过无限次之后,A和B都知道到D的距离为INF
1.5 LS 和 DV 算法的比较
消息复杂度:
- LS: \(n\) 路由器,发送报文 \(O(n^2)\) 个
- 局部的路由信息,全局传播
- DV: 只和邻居交换信息,总收敛消息量取决于网络变化
- 全局的路由信息,局部传播
收敛时间:
- LS: \(O(n^2)\) 算法,\(O(n^2)\) 消息交互量
- 有可能震荡
- DV: 不固定,可能收敛较慢
- 可能存在路由环路
- 无穷计算问题
健壮性: 路由器故障会发生什么(LS胜出):
- LS:
- 节点会通告不正确的链路代价
- 每个节点只计算自己的路由表
- 错误信息影响较小,局部,路由较健壮
- DV:
-
DV 节点可能通告对全网所有节点的不正确路径代价
-
每一个节点的路由表可能被其它节点使用
- 错误可以扩散到全网
-
2 因特网中自治系统内部的路由选择
科大
平面路由的问题
- 规模巨大的网络中,路由信息的存储、传输和计算代价巨大
- DV:距离矢量很大,且不能够收敛
- LS:几百万个节点的 LS 分组的泛洪传输,存储以及最短路径算法的计算
- 管理问题:
- 不同的网络所有者希望按照自己的方式管理网络
- 希望对外隐藏自己网络的细节
- 当然,还希望和其它网络互联
层次路由:将互联网分成一个个 AS (路由器区域)
- 某个区域内的路由器集合,自治系统 (AS)
- 一个 AS 用 AS Number(ASN)唯一标示
- 一个 ISP 可能包括 1 个或者多个 AS
路由变成了: 2个层次路由:
- AS 内部 路由:在同一个 AS 内路由器运行相同的路由协议
- “intra-AS” routing protocol:内部网关协议
- 不同的 AS 可能运行着不同的内部网关协议
- 能够解决规模和管理问题
- 如:RIP,OSPF,IGRP
- 网关路由器:AS 边缘路由器,可以连接到其他 AS
- AS 间 运行AS间路由协议
- “inter-AS” routing protocol:外部网关协议
- 解决 AS 之间的路由问题,完成 AS 之间的互联互通
层次路由的优点:
- 解决了规模问题
- 内部网关协议解决:AS 内部数量有限的路由器相互到达的问题,AS 内部规模可控
- 如 AS 节点太多,可分割 AS,使得 AS 内部的节点数量有限
- AS 之间的路由的规模问题
- 增加一个 AS,对于 AS 之间的路由从总体上来说,只是增加了一个节点 = 子网(每个 AS 可以用一个点来表示)
- 对于其他 AS 来说只是增加了一个表项,就是这个新增的 AS 如何走的问题
- 扩展性强:规模增大,性能不会减得太多
- 内部网关协议解决:AS 内部数量有限的路由器相互到达的问题,AS 内部规模可控
- 解决了管理问题
- 各个 AS 可以运行不同的内部网关协议
- 可以使自己网络的细节不向外透露
2.1 自治系统
-
自治系统(AS)的概念
- 路由器被聚合到称为 “自治系统” 或 “域”(Domains)的区域中。
- 这是网络管理的基本单元。
-
域内路由(Intra-AS / Intra-domain)
- 定义:指同一个 AS 内部路由器之间的路由。
- 协议要求:AS 内的所有路由器必须运行相同的域内路由协议。
- 灵活性:不同的 AS 之间可以运行不同的域内路由协议,互不干扰。
-
网关路由器(Gateway Router)
- 位置:位于 AS 的 “边缘”。
- 连接:拥有通往其他 AS 路由器的链路。
- 功能:既负责域内路由,也负责执行域间路由。
-
域间路由(Inter-AS / Inter-domain)
- 定义:指不同 AS 之间的路由。
- 执行者:由网关路由器专门负责处理跨域的路由选择与转发。
转发表由域内和域间路由算法共同配置,分别负责内部及外部目的地的路由条目。
- 域内路由 (Intra-AS Routing):专门用于确定自治系统(AS)内部目的地的转发条目
- 域间与域内路由协同 (Inter-AS & Intra-AS Routing):两者共同配合,用于确定外部目的地的转发条目
假设 AS1 中的路由器接收到目的地为 AS1 之外的数据报,路由器应该将数据包转发到AS1中的网关路由器,但是哪一个?
AS1 域间路由必须:
- 了解哪些目的地可以通过 AS2 到达,哪些通过 AS3 到达
- 将此可达性信息传播到 AS1 中的所有路由器
最常见的 intra-AS 路由协议
- RIP:路由信息协议
- 经典 DV:每 30 秒交换一次的 DVs
- 不再广泛使用
- EIGRP:增强的内部网关路由协议
- 基于 DV
- OSPF:开放最短路径优先
- link-state routing
- IS-IS 协议(ISO 标准,而不是 RFC 标准)本质上与 OSPF 相同
2.2 OSPF (Open Shortest Path First)
开放最短路径优先协议,自治系统内部的路由
- 开放性与协议类型
- OSPF 是公开可用的标准协议,属于经典的链路状态路由协议。
- 信息分发机制
- 每台路由器通过 IP 协议(不依赖TCP/UDP)向整个 AS 内的所有路由器泛洪链路状态通告
- 度量标准
- 支持多种链路成本度量方式,如带宽、延迟等
- 路由计算
- 每台路由器都拥有全网的完整拓扑视图,并运行 Dijkstra 算法来计算自身的转发表
- 安全性
- 所有 OSPF 报文均经过认证,以防止恶意入侵和伪造路由信息
层次化的 OSPF 路由
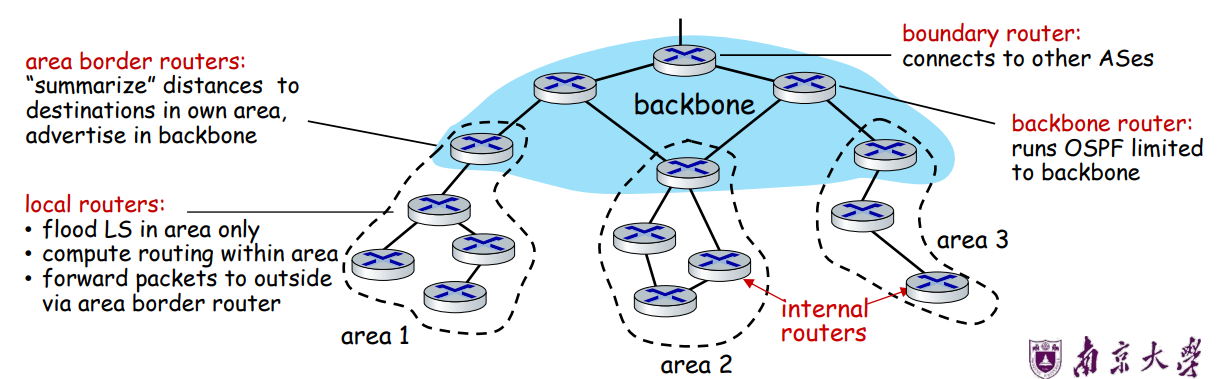
- 2 个级别的层次性: 本地,骨干
- 链路状态通告仅仅在本区域(本地/骨干)范围内进行
- 每一个节点拥有本地区域的拓扑信息
- 关于其他区域,只知道去它的方向,通过区域边界路由器(最短路径)
- 区域边界路由器: “汇总(聚集)” 到自己区域内网络的距离,向其它区域边界路由器通告
- 骨干路由器: 仅仅在骨干区域内,运行 OSPF 路由
- 边界路由器: 连接其它的 AS
3 ISP 之间的路由选择:BGP
3.1 互联网 AS 间路由:BGP
- BGP (Border Gateway Protocol): 边界网关协议,自治区域间路由协议 “事实上的” 标准
- “将互联网各个 AS 粘在一起的胶水”
- BGP 提供给每个 AS 以以下方法:
- eBGP: 从相邻的 ASes 那里获得子网可达信息
- iBGP: 将获得的子网可达信息传遍到 AS 内部的所有路由器
- 根据子网可达信息和策略来决定到达子网的 “好” 路径
- 允许子网向互联网其他网络通告 “我在这里”
- 基于距离矢量算法
- 不仅仅是距离矢量,还包括到达各个目标网络的详细路径(AS 序号的列表)能够避免简单 DV 算法的路由环路问题
网关路由器(Gateway Router) 是连接两个不同网络的 “关口” 设备,最常见的作用是将局域网(LAN,例如你家里的Wi-Fi网络或公司内部网络)连接到广域网(WAN,通常就是互联网)。
为了方便理解,你可以把它想象成一个封闭小区的大门保安室。小区内的居民(你的手机、电脑等设备)相互之间可以自由串门交流(局域网内部通信),但如果居民想要出小区(访问互联网),或者外面的人要送快递进来(从互联网下载数据),都必须经过这个大门保安室。
网关路由器的核心功能:
网关路由器之所以被称为“网关”,是因为它不仅负责指路,还负责不同网络环境之间的转换和管理。
它的主要功能包括:
- 路由转发 (Routing): 就像交通警察一样,它负责读取数据包上的地址信息,并决定将数据送往哪个方向。
- 网络地址转换 (NAT): 这是网关路由器最关键的功能之一。你家里的所有设备(手机、电视、电脑)在局域网内用的都是“私有IP地址”(比如
192.168.1.x)。当这些设备要上网时,网关路由器会把这些私有IP统一转换成运营商分配的“公网IP地址”。这就好比全公司对外共用一个分机总机号码。 - 安全与防火墙 (Firewall): 作为内外网络的唯一出入口,它充当着第一道防线,通过内置的防火墙规则来阻挡来自外部互联网的未经授权访问和恶意攻击。
- 动态IP分配 (DHCP): 当有新设备(如朋友的手机)连接到你的网络时,网关路由器会自动为它分配一个局域网IP地址,确保它能正常通信而不会与现有设备冲突。
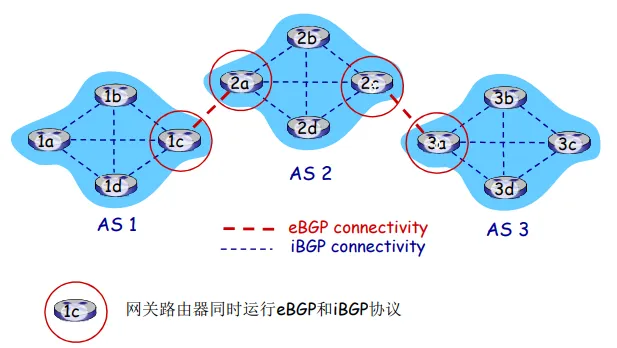
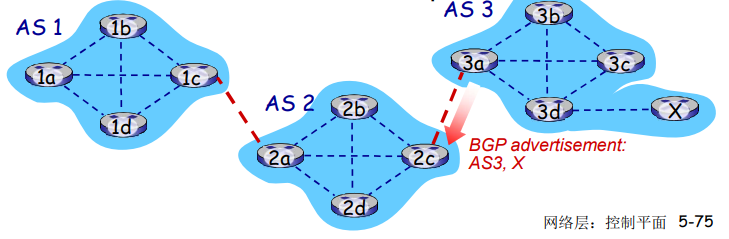
BGP 会话: 2 个 BGP 路由器 (“peers”) 在一个半永久的 TCP 连接上交换 BGP 报文:
- 当 AS3 网关路由器 3a 向 AS2 的网关路由器 2c 通告路径:AS3, X(新上线)
- 3a 参与 AS 内路由运算,知道本 AS 所有子网 X 信息
- 语义上:AS3 向 AS2 承诺,它可以向子网 X 转发数据报
- 3a 是 2c 关于 X 的下一跳(next hop)
BGP 路由
- 当通告一个子网前缀(destination)时,通告包括 BGP 属性
- prefix + attributes = “route”
- 2 个重要的属性:
- AS-PATH: 前缀的通告所经过的 AS 列表
- 检测环路;多路径选择
- 在向其它 AS 转发时,需要将自己的 AS 号加在路径上
- NEXT-HOP: 从当前 AS 到下一跳 AS 有多个链路,告诉对方通过哪个转发
- AS-PATH: 前缀的通告所经过的 AS 列表
- 基于策略的路由(经济策略、政治策略):
- 当一个网关路由器接收到了一个路由通告,使用输入策略来接受或过滤(
- 过滤原因例 1:不想经过某个AS,转发某些前缀的分组
- 过滤原因例 2:已经有了一条往某前缀的偏好路径
- 策略也决定了是否向它别的邻居通告收到的这个路由信息
- 当一个网关路由器接收到了一个路由通告,使用输入策略来接受或过滤(
BGP 路径通告
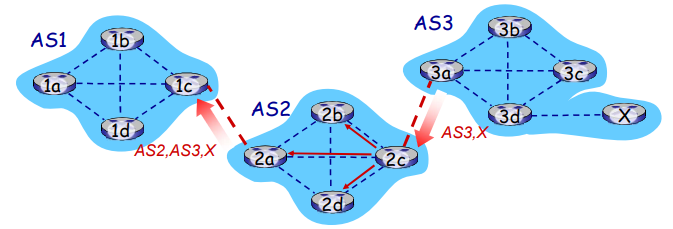
- 路由器 AS2.2c 从 AS3.3a 接收到的 AS3.X 路由通告 (通过 eBGP)
- 基于 AS2 的输入策略,AS2.2c 决定接收 AS3.X 的通告,而且通过 iBGP 向 AS2 的所有路由器进行通告
- 基于 AS2 的策略,AS2 路由器 2a 通过 eBGP 向 AS1.1c 路由器通告 AS2,AS3.X 路由信息
- 路径上加上了 AS2 自己作为 AS 序列的一跳
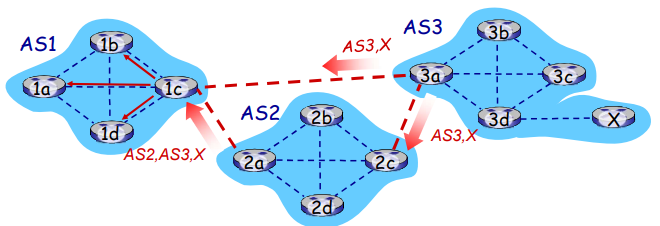
网关路由器可能获取有关一个子网 X 的多条路径,从多个 eBGP 会话上:
- AS1 网关路由器 1c 从 2a 学习到路径:AS2,AS3,X
- AS1 网关路由器 1c 从 3a 处学习到路径 AS3,X
- 基于策略,AS1 路由器 1c 选择了路径:AS3,X,而且通过 iBGP 告诉所有 AS1 内部的路由器
BGP 报文
- 使用 TCP 协议交换 BGP 报文
- BGP 报文:
OPEN:打开 TCP 连接,认证发送方UPDATE:通告新路径(或者撤销原路径)KEEPALIVE:在没有更新时保持连接,也用于对OPEN请求确认NOTIFICATION:报告以前消息的错误,也用来关闭连接
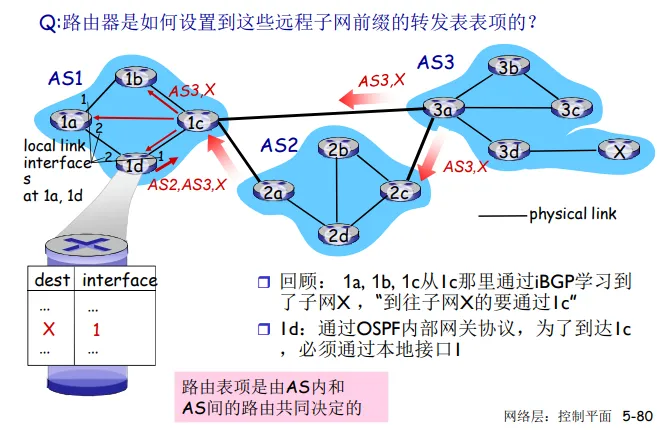
BGP,OSPF,转发表表项
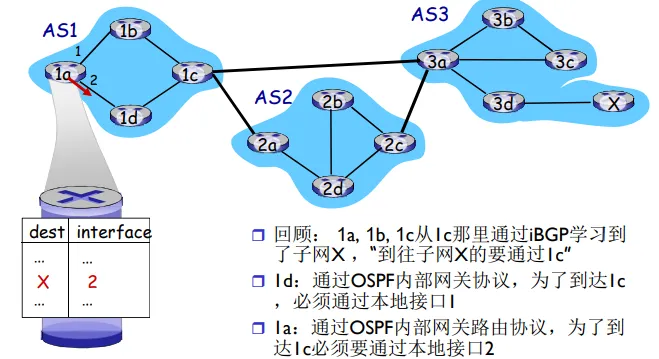
BGP 路径选择
- 路由器可能获得一个网络前缀的多个路径,路由器必须进行路径的选择,路由选择可以基于:
- 本地偏好值属性: 偏好策略决定
- 最短 AS-PATH: AS 的跳数
- 最近的 NEXT-HOP 路由器: 热土豆路由
- 附加的判据: 使用 BGP 标示
- 一个前缀对应着多种路径,采用消除规则直到留下一条路径
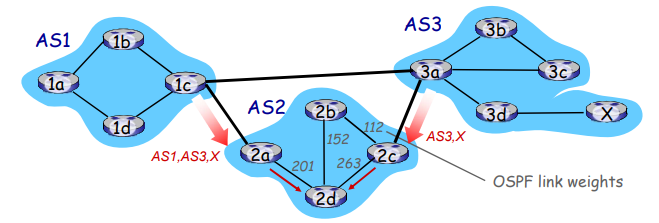
- 2d 通过 iBGP 获知,它可以通过 2a 或者 2c 到达 X
- 热土豆策略:选择具备最小内部区域代价的网关作为往 X 的出口(如:2d 选择 2a,即使往 X 可能有比较多的 AS 跳数):不要操心域间的代价!
热土豆策略:最小内部区域代价
BGP: 通过路径通告执行策略
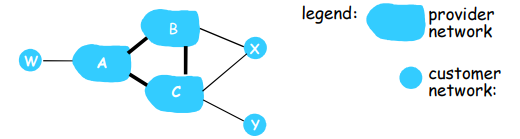
假设一个 ISP 只想 路由流量 到/去往它的客户网络 (不想承载其他 ISPs 之间的流量,即不通告:不是去往我的客户,也不是来自我的客户)
- A 向 B 和 C 通告路径 Aw
- B 选择不向 C 通告 BAw:
- B 从 CBAw 的路由上无法获得收益,因为 C,A,w 都不是 B 的客户
- C 从而无法获知 CBAw 路径的存在:每个 ISP 感知到的网络和真实不一致
- C 可能会通过 CAw(而不是使用 B)最终路由到 w
- A,B,C 是 提供商网络:
- X,W,Y 是桩网络(stub networks)或者叫端网络(ppt:客户网络)
- X 是双重接入的,多宿桩网络,接入了 2 个网络
- 策略强制让 X:
- X 不想路由 从 B 通过 X 到 C 的分组
- 因而 X 就不通告给 B,它实际上可以路由到 C
为什么内部网关协议和外部网关协议如此不同?
策略:
- Inter-AS: 管理员需要控制通信路径,谁在使用它的网络进行数据传输
- Intra-AS: 一个管理者,所以无需策略
- AS 内部的各子网的主机尽可能地利用资源进行快速路由
规模:
- AS 间路由必须考虑规模问题,以便支持全网的数据转发
- AS 内部路由规模不是一个大的问题
- 如果 AS 太大,可将此 AS 分成小的 AS;规模可控
- AS 之间只不过多了一个点而已
- 或者 AS 内部路由支持层次性,层次性路由节约了表空间,降低了更新的数据流量
性能:
- Intra-AS: 关注性能
- Inter-AS: 策略可能比性能更重要
4 SDN 控制平面
4.1 SDN
- 互联网络网络层:历史上都是通过分布式、每个路由器的实现
- 单个路由器包含了:交换设备硬件、私有路由器 OS 和其上运行的互联网标准协议(IP, RIP, IS-IS, OSPF, BGP)的私有实现
- 需要不同的中间盒来实现不同网络层功能:防火墙,负载均衡设备和 NAT …
传统方式:每-路由器控制平面
- 在每一个路由器中的单独路由器算法元件,在控制平面进行交互
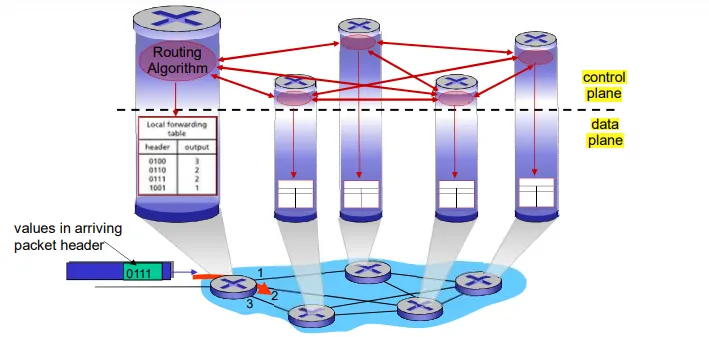
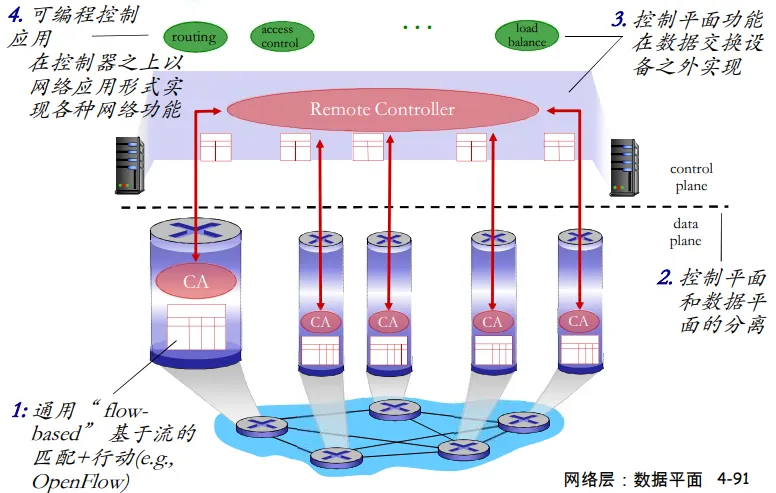
SDN方式:逻辑上集中的控制平面
一个不同的(通常是远程的)控制器与本地控制代理(CAs)交互 远程控制器负责计算,在路由器上安装转发表
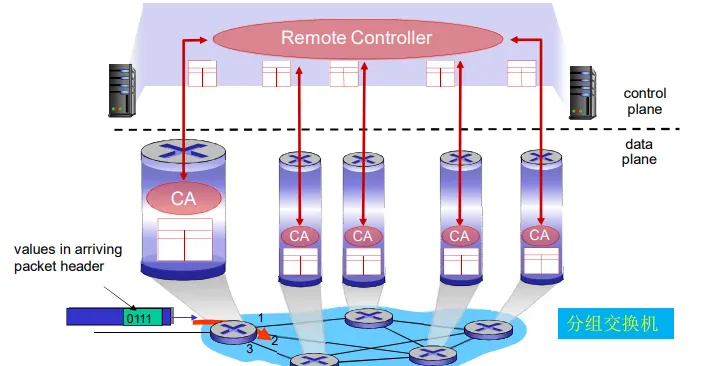
- 网络管理更加容易:避免路由器的错误配置,对于通信流的弹性更好
- 基于流表的转发(OpenFlow API),允许 “可编程” 的路由器
- 集中式 “编程” 更加容易:集中计算流表然后分发
- 传统分布式 “编程” 困难:在每个单独的路由器上分别运行分布式的算法得到转发表
- 控制平面的开放实现(非私有)
- 新的竞争生态
类比: 主框架到 PC 的演变
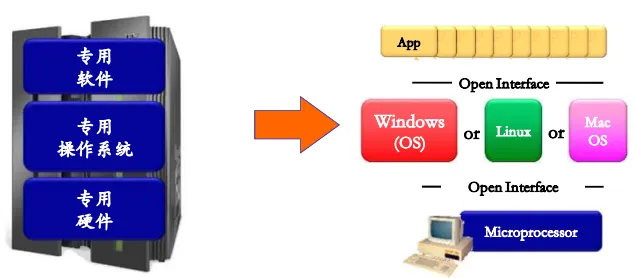
垂直集成:封闭,私有,创新缓慢,产业规模小 -> 水平集成:开放接口,快速创新,产业巨大
4.2 流量工程:传统路由实现比较困难
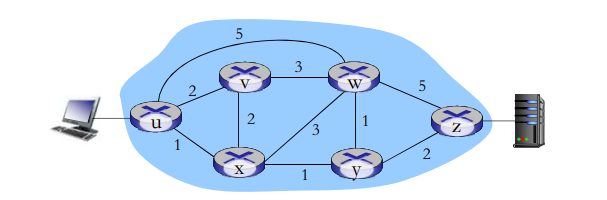
Q: 网管如果需要 u 到 z 的流量走 uvwz,x 到 z 的流量走 xwyz,怎么办? A: 需要定义链路的代价,流量路由算法以此运算(IP 路由面向目标,无法操作)(或者需要新的路由算法)!
只是链路权重控制旋钮,错! 不仅仅链路代价是控制旋钮,控制平面的策略也是
Q: 如果网管需要将 u 到 z 的流量分成 2 路:uvwz 和 uxyz (负载均衡),怎么办? A: 无法完成(在原有体系下只有使用新的路由选择算法,而在全网部署新的路由算法是个大的事情)
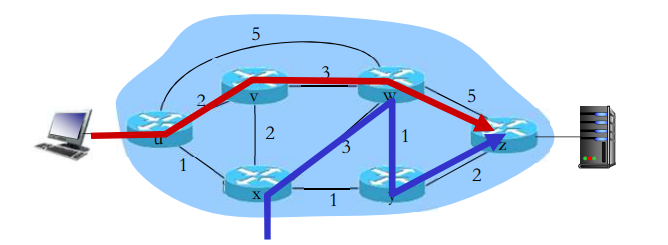
Q: 如果需要 w 对蓝色的和红色的流量采用不同的路由,怎么办? A: 无法操作(基于目标的转发,采用 LS, DV 路由)
SDN 特点:
4.2 SDN 架构
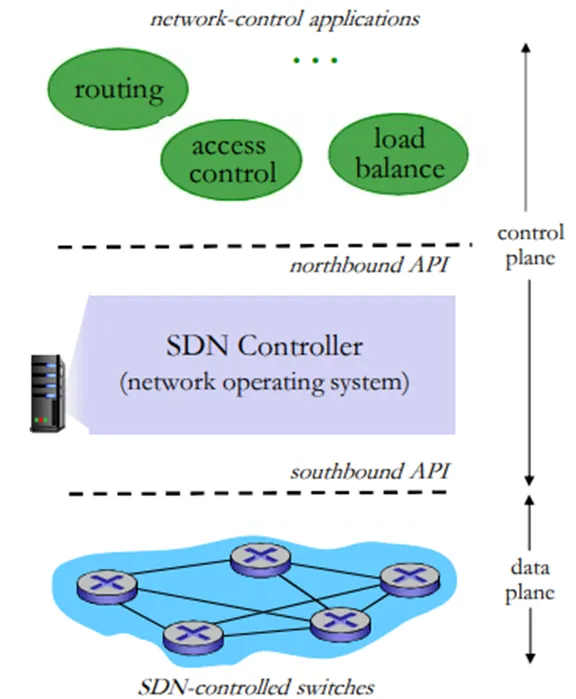
数据平面交换机:
- 快速,简单,商业化交换设备
- 采用硬件实现通用转发功能
- 流表被控制器计算和安装
- 基于南向 API(例如 OpenFlow),SDN 控制器访问基于流的交换机
- 定义了哪些可以被控制哪些不能
- 也定义了和控制器的协议(e.g., OpenFlow)
SDN 控制器 (网络OS):
- 维护网络状态信息
- 通过上面的北向 API 和网络控制应用交互
- 通过下面的南向 API 和网络交换机交互
- 逻辑上集中,但是在实现上通常由于性能、可扩展性、容错性以及鲁棒性采用分布式方法
网络控制应用:
- 控制的大脑:采用下层提供的服务(SDN 控制器提供的 API),实现网络功能
- 路由器 交换机
- 接入控制 防火墙
- 负载均衡
- 其他功能
- 非绑定:可以被第三方提供,与控制器厂商以通常上不同,与分组交换机厂商也可以不同
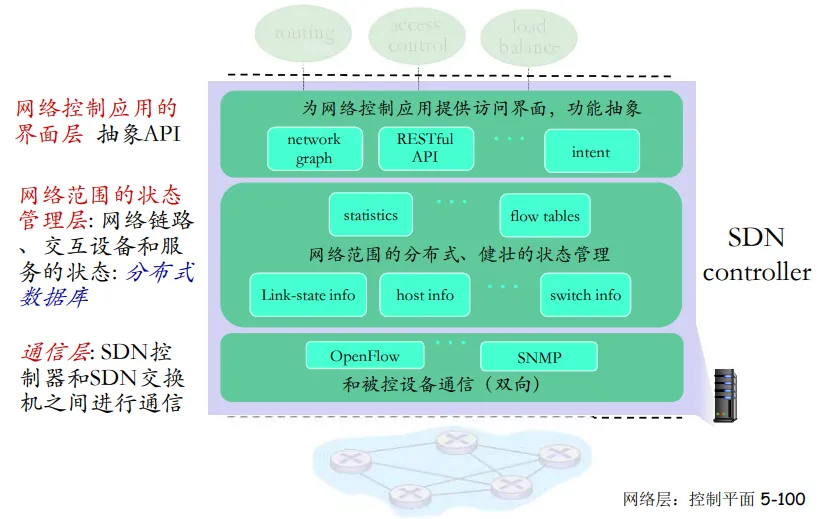
SDN 控制器里的元件:
4.3 OpenFlow 协议
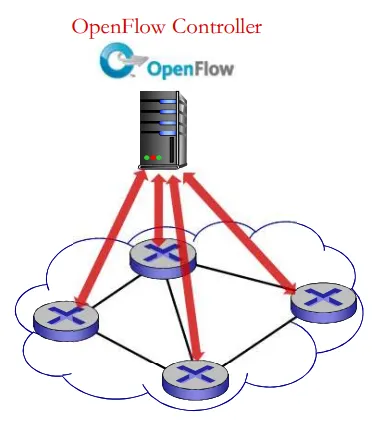
- 控制器和 SDN 交换机交互的协议
- 通过南向接口
- 采用 TCP 来交换报文
- 加密可选
- 3 种 OpenFlow 报文类型
- 控制器 - 交换机
- 异步(交换机 - 控制器)
- 对称 (misc)
一些关键的控制器到交换机的报文(往下走):
- 特性:控制器查询交换机特性,交换机应答
- 配置:交换机查询/设置交换机的配置参数
- 修改状态:增加删除修改 OpenFlow 表中的流表
- packet-out:控制器可以将分组通过特定的端口发出
一些关键的交换机到控制器的报文(往上走):
- 分组进入: 将分组(和它的控制)传给控制器,见来自控制器的 packet-out 报文
- 流移除: 在交换机上删除流表项
- 端口状态: 通告控制器端口的变化
幸运的是,网络管理员不需要直接通过创建/发送流表来编程交换机,而是采用在控制器上的更高等级抽象
控制/数据平面交互的例子:
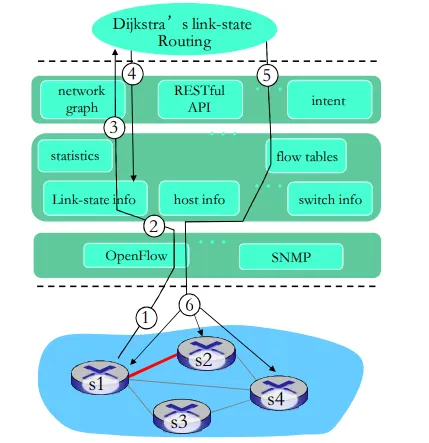
- S1,经历了链路失效,采用 OpenFlow 报文通告控制器: 端口状态报文
- SDN 控制器接收 OpenFlow 报文,更新链路状态信息
- Dijkstra 路由算法应用被调用(前面注册过这个状态变化消息)
- Dijkstra 路由算法访问控制器中的网络拓扑信息,链路状态信息计算新路由
- 链路状态路由 app 和 SDN 控制器中流表计算元件交互,计算出新的所需流表
- 控制器采用 OpenFlow 在交换机上安装新的需要更新的流表
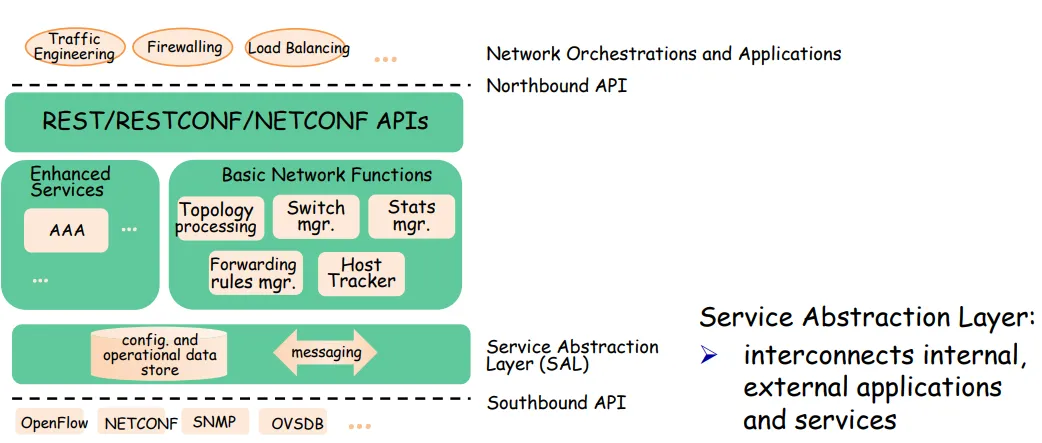
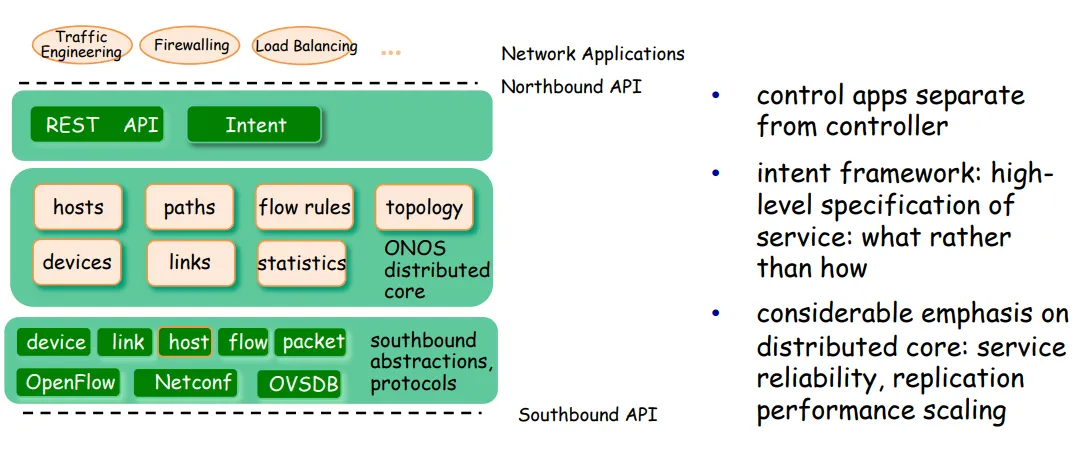
4.2 SDN 控制器
- OpenDaylight (ODL) 控制器
- ONOS 控制器
4.3 SDN 面临的挑战
- 强化控制平面:可信、可靠、性能可扩展性、安全的分布式系统
- 对于失效的鲁棒性: 利用控制平面可靠分布式系统的强大理论
- 可信任,安全:从开始就进行铸造
- 网络、协议满足特殊任务的需求
- e.g., 实时性,超高可靠性、超高安全性
- 互联网络范围内的扩展性
- 而不是仅仅在一个 AS 的内部部署,全网部署
SDN 与传统网络协议的未来
- SDN 计算与路由器计算转发表对比:
- 仅仅是逻辑集中计算与协议计算的一个例子
- 可以设想基于 SDN 计算的拥塞控制:
- 控制器根据路由器报告的(发给控制器的)拥塞水平来设定发送方速率
网络功能的实现(SDN 与协议)将如何演变?
5 ICMP
ICMP(Internet Control Message Protocol)互联网控制信息协议
5.1 ICMP 的基本概念与定位
-
主要功能:ICMP 是由主机、路由器使用的协议,主要用于在网络层传达控制信息
-
两大核心应用场景:
- 错误报告:当网络出现问题时(例如主机不可达、网络不可达、端口或协议不可达等),向源主机报告错误。
- Echo 请求和回复:用于测试网络连通性,最典型的应用就是我们常用的
ping命令。
-
在协议栈中的位置:
- ICMP 在逻辑上属于网络层协议。
- 但从封装结构上看,它是在 IP 协议之上的。也就是说,ICMP 消息是作为数据被封装在 IP 数据报(IP Datagram)的有效载荷中进行传输的。
-
ICMP 报文结构:类型、代码加上导致错误的 IP 数据报的前 8 个字节
| Type | Code | description |
|---|---|---|
| 0 | 0 | echo reply (ping) |
| 3 | 0 | dest. network unreachable |
| 3 | 1 | dest host unreachable |
| 3 | 2 | dest protocol unreachable |
| 3 | 3 | dest port unreachable |
| 3 | 6 | dest network unknown |
| 3 | 7 | dest host unknown |
| 4 | 0 | source quench (congestion control - not used) |
| 8 | 0 | echo request (ping) |
| 9 | 0 | route advertisement |
| 10 | 0 | router discovery |
| 11 | 0 | TTL expired |
| 12 | 0 | bad IP header |
5.2 路由追踪与 ICMP
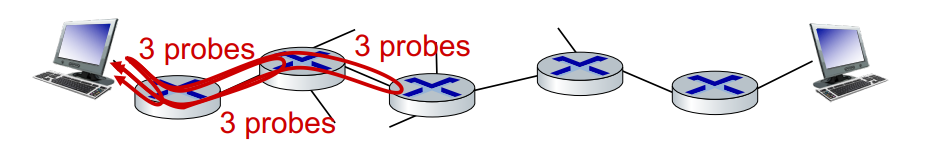
- 源向目的地发送多组 UDP 报文段
- 第 1 组 TTL = 1,第 2 组 TTL = 2,依此类推
- 第 n 组中的数据报到达第 n 个路由器:
- 路由器丢弃数据报并向源发送 ICMP 报文(类型 11,代码 0)
- ICMP 报文可能包含路由器名称及 IP 地址
- 当 ICMP 报文到达源时:记录往返时间 (RTTs)
停止条件:
- UDP 报文段最终到达目的主机
- 目的地返回 ICMP “端口不可达” 报文(类型 3,代码 3)
- 源停止发送
6 网络管理和 SNMP
6.1 网络管理的基本概念
- 自治系统(“网络”):成千上万相互交互的硬件/软件组件。
- 其他需要监控、配置、控制的复杂系统:喷气式飞机、核电站、其他
“网络管理包括硬件、软件和人员要素的部署、集成和协调,以监视、测试、轮询、配置、分析、评估和控制网络和要素资源,以合理的成本满足实时、操作性能和服务质量要求。”
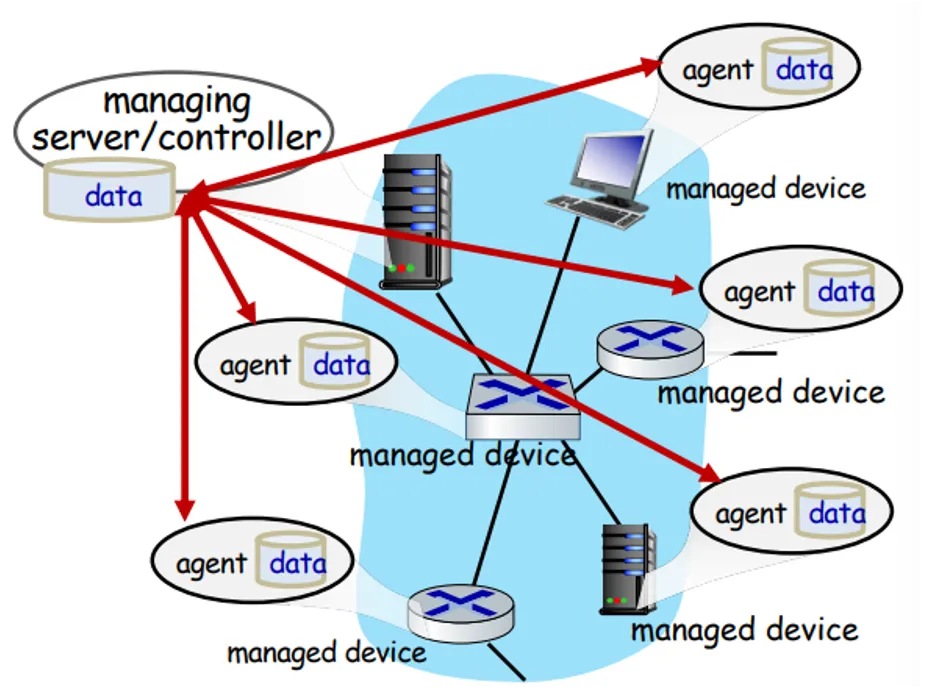
网络管理的组件
- 管理服务器:
- 应用程序,通常由网络管理员参与控制回路
- 被管设备:
- 具有可管理、可配置硬件和软件组件的设备
- 网络管理协议: .
- 管理服务器用于查询、配置、管理设备的协议
- 设备用于向管理服务器报告数据和事件的协议
- 数据:
- 设备 “状态”:配置数据、运行数据、设备统计信息
网络运营商的管理方法
- CLI (Command Line Interface):
- 运营商直接向单个设备下发指令(输入、脚本)(例如,通过ssh)
- SNMP/MIB:
- 运营商使用简单网络管理协议(SNMP)查询/设置设备数据(MIB)
- NETCONF/YANG:
- 更抽象、全网范围、整体性
- 强调多设备配置管理
6.2 SNMP 协议
传递 MIB 信息和命令的两种方式:
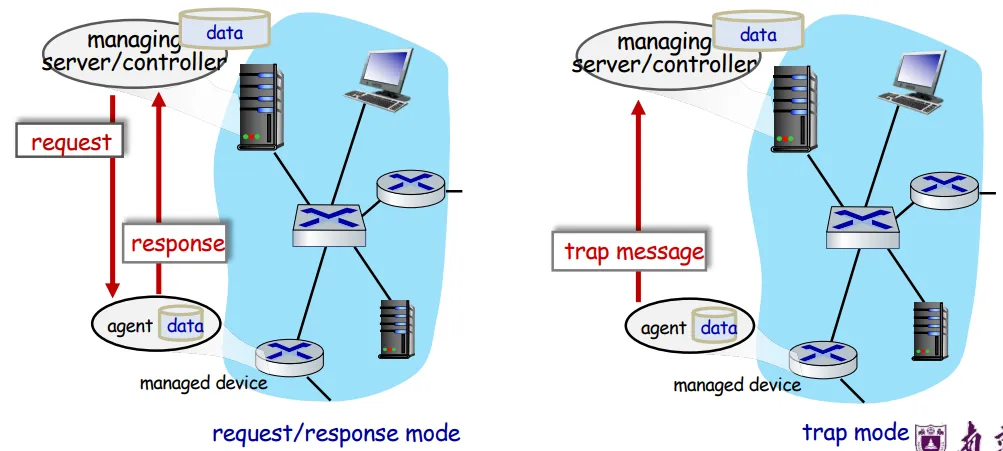
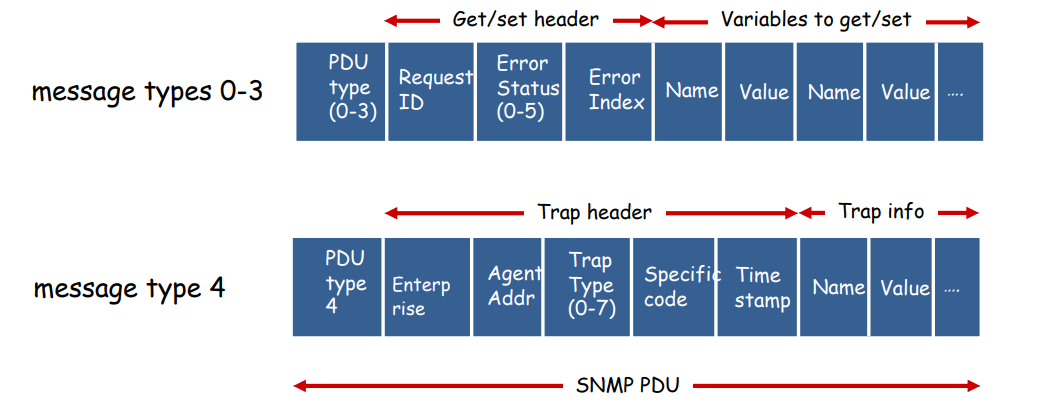
Message types (消息类型):
| 消息类型 | 功能 |
|---|---|
| GetRequestGetNextRequestGetBulkRequest | 管理器到代理:“给我数据”(数据实例、列表中的下一个数据、数据块) |
| SetRequest | 管理器到代理:设置MIB值 |
| Response | 代理到管理器:值,对请求的响应 |
| Trap | 代理到管理器:通知管理器发生异常事件 |
管理信息库 (MIB)
- 管理设备的运行(和部分配置)数据
- 收集到设备 MIB 模块中
- 管理信息结构(SMI):数据定义语言
- UDP 协议的 MIB 变量示例:
| Object ID | Name | Type | Comments |
|---|---|---|---|
| 1.3.6.1.2.1.7.1 | UDPInDatagrams | 32-bit counter | total # datagrams delivered |
| 1.3.6.1.2.1.7.2 | UDPNoPorts | 32-bit counter | # undeliverable datagrams (no application at port) |
| 1.3.6.1.2.1.7.3 | UDPErrors | 32-bit counter | # undeliverable datagrams (all other reasons) |
| 1.3.6.1.2.1.7.4 | UDPOutDatagrams | 32-bit counter | total # datagrams sent |
| 1.3.6.1.2.1.7.5 | udpTable | SEQUENCE | one entry for each port currently in use |
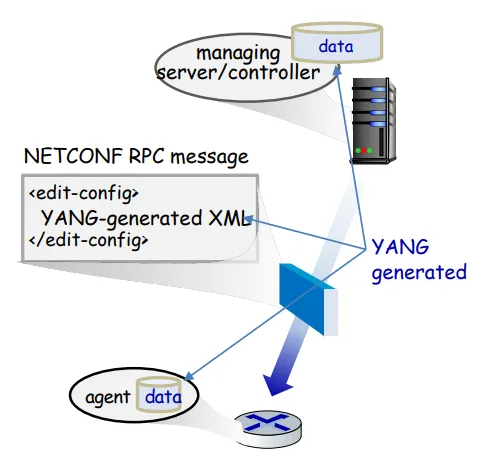
6.3 NETCONF
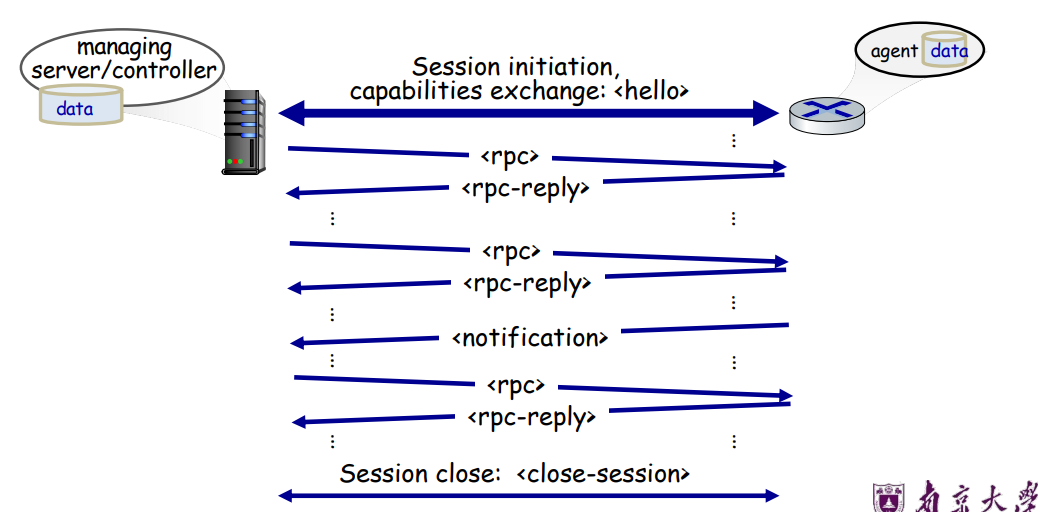
- 目标:在全网范围内主动管理/配置设备
- 在管理服务器和被管理网络设备之间进行操作 * 操作:检索、设置、修改、激活配置 * 跨多个设备的原子提交操作 * 查询运行数据和统计信息 * 订阅设备的通知
- 远程过程调用(RPC)范式 * NETCONF 协议消息以 XML 编码 * 通过安全、可靠的传输(例如,TLS)协议交换
NETCONF 初始化、交换、关闭
选定的 NETCONF 操作
| NETCONF 操作 | 描述 |
|---|---|
<get-config> |
检索给定配置的全部或部分。一个设备可能有多个配置。 |
<get> |
检索配置状态和运行状态数据的全部或部分。 |
<edit-config> |
更改被管设备上指定的(可能是正在运行的)配置。被管设备的 <rpc-reply> 包含 <ok> 或带回滚的 <rpc-error>。 |
<lock>, <unlock> |
锁定(解锁)被管设备上的配置数据存储(以阻止来自其他来源的 NETCONF、SNMP 或 CLI 命令)。 |
<create-subscription>, <notification> |
启用来自被管设备的事件通知订阅 |
NETCONF RPC 消息样例
<?xml version="1.0" encoding="UTF-8"?>
<rpc message-id="101"> <!-- note message id -->
  <edit-config>
    <target>
      <running/> <!-- change the running configuration -->
    </target>
    <config>
      <top xmlns="http://example.com/schema/1.2/config">
        <interface>
          <name>Ethernet0/0</name> <!-- change MTU of Ethernet 0/0 interface to 1500 -->
          <mtu>1500</mtu>
        </interface>
      </top>
    </config>
  </edit-config>
</rpc>
6.4 YANG
- 用于指定NETCONF网络管理数据的结构、语法、语义的数据建模语言
- 具有内置数据类型,类似于 SMI
- 描述设备功能的 XML 文档可以从 YANG 描述生成
- 可以表达数据之间的约束,这些约束必须由有效的 NETCONF 配置满足
- 确保 NETCONF 配置满足正确性、一致性约束
标题:5 网络层:控制平面
作者:Zwing
创建于:2026-08-08 06:47:13
更新于:2026-08-07 23:07:52
链接:https://zanytriumph.github.io/posts/5 网络层-控制平面.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可