
2 应用层
网络核心没有应用层功能,网络应用只在端系统上存在
1 应用层协议原理
1.1 网络应用的体系结构
- 可能的应用架构:
- 客户-服务器模式(C/S)
- 对等模式(P2P)
- 混合体:客户-服务器和对等体系结构
1.1.1 客户-服务器(C/S)体系结构
- 服务器:
- 一直运行
- 固定的 IP 地址和周知的端口号(约定)
- 扩展性:服务器场
- 数据中心进行扩展
- 扩展性差
- 客户端:
- 主动与服务器通信
- 与互联网有间歇性的连接
- 可能是动态 IP 地址
- 不直接与其它客户端通信
1.1.2 对等体(P2P)体系结构
- (几乎)没有一直运行的服务器
- 任意端系统之间可以进行通信
- 每一个节点既是客户端又是服务器
- 自扩展性:新 peer 节点带来新的服务能力,当然也带来新的服务请求
- 参与的主机间歇性连接且可以改变 IP 地址
- 难以管理
1.1.3 C/S 和 P2P 体系结构的混合体
- 即时通信
- 在线检测:集中
- 当用户上线时,向中心服务器注册其 IP 地址
- 用户与中心服务器联系,以找到其在线好友的位置
- 两个用户之间聊天:P2P
- 在线检测:集中
1.2 进程通信
进程:在主机上运行的应用程序
- 在同一个主机内,使用进程间通信机制通信(操作系统定义)
- 不同主机,通过交换报文(Message)来通信
- 使用 OS 提供的通信服务
- 按照应用协议交换报文
- 借助传输层提供的服务
客户端进程:发起通信的进程 服务器进程:等待连接的进程 P2P 架构的应用也有客户端进程和服务器进程之分
分布式进程通信需要解决的问题:
- 问题1:进程标示和寻址问题(服务用户)
- 问题2:传输层-应用层如何提供服务
- 位置:层间界面的 SAP (TCP/IP :socket)
- 形式:应用程序接口 API (TCP/IP :socket API)
- 问题3:如何使用传输层提供的服务,实现应用进程之间的报文交换,实现应用(用户使用服务)
- 定义应用层协议:报文格式,解释,时序等
- 编制程序,使用 OS 提供的 API ,调用网络基础设施提供通信服务传报文,实现应用时序等
1.2.1 对进程进行编址(addressing)
- 进程为了接收报文,必须有一个标识即:SAP(发送也需要标识)
- 主机:唯一的 32 位 IP 地址
- 仅仅有 IP 地址不能够唯一标示一个进程
- 在一台端系统上有很多应用进程在运行
- 所采用的传输层协议:TCP or UDP
- 端口号(Port Numbers)
- 主机:唯一的 32 位 IP 地址
- 一些知名端口号的例子:
- HTTP: TCP 80
- Mail: TCP 25
- FTP:TCP 2
- 一个进程:用 IP + port 标示 —— 端节点
- 本质上,一对主机进程之间的通信由 2 个端节点构成
1.2.2 传输层提供的服务-需要穿过层间的信息
- 层间接口必须要携带的信息
- 要传输的报文
- 谁传的:应用进程的标示:IP+TCP(UDP) 端口
- 传给谁:对方的应用进程的标示:对方的 IP+TCP(UDP) 端口
- 传输层实体(TCP 或者 UDP 实体)根据这些信息进行 TCP 报文段(UDP 数据报)的封装
- 源端口号,目标端口号,数据等
- 将 IP 地址往下交 IP 实体,用于封装 IP 数据报:源 IP,目标 IP
- 如果 Socket API 每次传输报文,都携带如此多的信息,太繁琐易错,不便于管理
- 用个代号标示通信的双方或者单方:socket
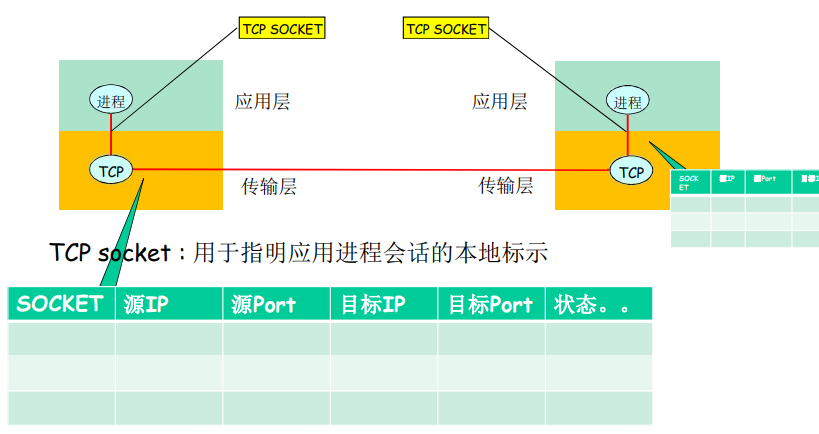
- TCP socket:
- TCP服务,两个进程之间的通信之前要建立连接
- 两个进程通信会持续一段时间,通信关系稳定
- 可以用一个整数表示两个应用实体之间的通信关系,本地标示
- TCP socket:源IP,源端口,目标IP,目标端口
- TCP服务,两个进程之间的通信之前要建立连接
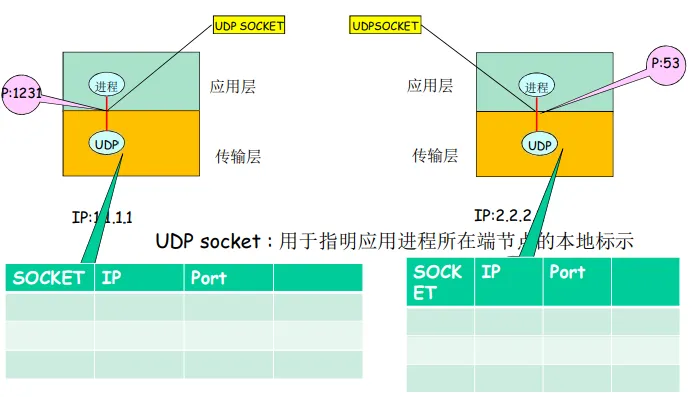
- UDP socket:
- UDP 服务,两个进程之间的通信之前无需建立连接
- 每个报文都是独立传输的
- 前后报文可能给不同的分布式进程
- 因此,只能用一个整数表示本应用实体的标示
- 因为这个报文可能传给另外一个分布式进程
- UDP socket:本IP,本端口
- 但是传输报文时:必须要提供对方 IP,port
- 接收报文时: 传输层需要上传对方的 IP,port
- UDP 服务,两个进程之间的通信之前无需建立连接
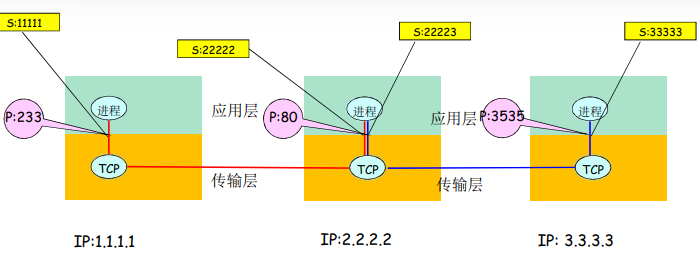
TCP 之上的套接字(socket)
- 对于使用面向连接服务(TCP)的应用而言,套接字是 4 元组的一个具有本地意义的标示
- 4元组:(源IP,源port,目标IP,目标port)
- 唯一地指定了一个会话(2个进程之间的会话关系)
- 应用使用这个标示,与远程的应用进程通信
- 不必在每一个报文的发送都要指定这 4 元组
- 简单,便于管理
UDP之上的套接字(socket)
- 对于使用无连接服务(UDP)的应用而言,套接字是 2 元组的一个具有本地意义的标示
- 2 元组:IP,port (源端指定)
- UDP套接字指定了应用所在的一个端节点(end point)
- 在发送数据报时,采用创建好的本地套接字(标示 ID),就不必在发送每个报文中指明自己所采用的 ip 和 port
- 但是在发送报文时,必须要指定对方的 ip 和 udp port (另外一个段节点)
套接字(Socket)
- 进程向套接字发送报文或从套接字接收报文
- 套接字 <-> 门户
- 发送进程将报文推出门户,发送进程依赖于传输层设施在另外一侧的门户将报文交付给接收进程
- 接收进程从另外一端的门户收到报文(依赖于传输层设施)
1.2.3 如何使用传输层提供的服务实现应用
- 定义应用层协议:报文格式,解释,时序等
- 编制程序,通过 API 调用网络基础设施提供通信服务传报文,解析报文,实现应用时序等
应用层协议
- 定义了:运行在不同端系统上的应用进程如何相互交换报文
- 交换的报文类型:请求和应答报文
- 各种报文类型的语法:报文中的各个字段及其描述
- 字段的语义:即字段取值的含义
- 进程何时、如何发送报文及对报文进行响应的规则
- 应用协议仅仅是应用的一个组成部分
- Web应用:HTTP协议,web客户端,web服务器,HTML
1.3 应用对传输层的服务的评价指标
数据丢失率
- 有些应用则要求100%的可靠数据传输(如文件)
- 有些应用(如音频)能容忍一定比例以下的数据丢失
延迟
- 一些应用 出于有效性考虑,对数据传输有严格的时间限制
- Internet 电话、交互式游戏
吞吐
- 一些应用(如多媒体)必须需要最小限度的吞吐,从而使得应用能够有效运转
- 一些应用能充分利用可供使用的吞吐(弹性应用)
安全性
- 机密性
- 完整性
- 可认证性(鉴别)
| 应用 | 数据丢失率 | 吞吐 | 时间敏感性 |
|---|---|---|---|
| 文件传输 | 不能丢失 | 弹性 | 不 |
| 不能丢失 | 弹性 | 不 | |
| Web 文档 | 不能丢失 | 弹性 | 不 |
| 实时音视频 | 容忍丢失 | 音频:5kbps-1Mbps 视频:100kbps-5Mbps |
是,100ms |
| 存储音视频 | 容忍丢失 | 同上 | 是,几秒 |
| 交互式游戏 | 容忍丢失 | 几kbps ~10kbps | 是,100ms |
| 即时讯息 | 不能丢失 | 弹性 | 是和不是 |
1.4 Internet 传输层提供的服务
TCP 服务:
- 可靠的传输服务
- 流量控制:发送方不会淹没接受方
- 拥塞控制:当网络出现拥塞时,能抑制发送方
- 不能提供的服务:时间保证、最小吞吐保证和安全
- 面向连接:要求在客户端进程和服务器进程之间建立连接
UDP 服务:
- 不可靠数据传输
- 不提供的服务:可靠,流量控制、拥塞控制、时间、带宽保证、建立连接
UDP 存在的必要性:
- 能够区分不同的进程,而 IP 服务不能
- 在 IP 提供的主机到主机端到端功能的基础上,区分了主机的应用进程
- 无需建立连接,省去了建立连接时间,适合事务性的应用
- 不做可靠性的工作,例如检错重发,适合那些对实时性要求比较高而对正确性要求不高的应用
- 因为为了实现可靠性(准确性、保序等),必须付出时间代价(检错重发)
- 没有拥塞控制和流量控制,应用能够按照设定的速度发送数据
- 而在TCP上面的应用,应用发送数据的速度和主机向网络发送的实际速度是不一致的,因为有流量控制和拥塞控制
| 应用 | 应用层协议 | 下层的传输协议 |
|---|---|---|
| SMTP [RFC 2821] | TCP | |
| 远程终端访问 | Telnet [RFC 854] | TCP |
| Web | HTTP [RFC 2616] | TCP |
| 文件传输 | FTP [RFC 959] | TCP |
| 流媒体 | 专用协议(如 RealNetworks) | RTP, RTSP, TCP or UDP |
| Internet电话 | 专用协议(如 Dialpad) | SIP on UDP |
安全性:
TCP & UDP
- 都没有加密
- 明文通过互联网传输,甚至密码
原件无
SSL(Secure Socket Layer)
- 在TCP上面实现,提供加密的TCP连接
- 私密性
- 数据完整性
- 端到端的鉴别
SSL是在应用层的(也可以说传输)
- 应用采用SSL库,SSL库使用TCP通信
SSL socket API
- 应用通过 API 将明文交给 socket,SSL 将其加密在互联网上传输
2 Web 与 HTTP
2.1 Web
Web 页:由一些对象组成
对象可以是 HTML 文件,JPEG 图像,Java 小程序,声音剪辑文件等
Web 页含有一个基本的 HTML 文件,该基本 HTML 文件又包含若干对象的引用(链接)
通过 URL 对每个对象进行引用(唯一标识符),URL 格式:
<protocol>://<host>:<port>/<path>?query_string
- Protocol:对象的传输或解释方法,如 http、ftp、Gopher
- Host:对象所在主机的 DNS 名称或 IP 地址
- Path:包含该对象的文件路径名
- Query_string:发送给服务器应用的名称/值对
2.2 HTTP 概况
HTTP: 超文本传输协议
- Web 的应用层协议
- 客户/服务器模式
- 客户:请求、接收和显示 Web 对象的浏览器
- 服务器:对请求进行响应,发送对象的 Web 服务器
2.3 HTTP 使用 TCP
- 客户发起一个与服务器的 TCP 连接(建立套接字),端口号为 80
- 服务器接受客户的 TCP 连接
- 在浏览器(HTTP 客户端)与 Web 服务器(HTTP 服务器)交换 HTTP 报文(应用层协议报文)
- TCP 连接关闭
HTTP 是无状态的,服务器并不维护关于客户的任何信息
维护状态的协议很复杂
- 必须维护历史信息(状态)
- 如果服务器/客户端死机,它们的状态信息可能不一致,二者的信息必须是一致
- 无状态的服务器能够支持更多的客户端
- 每个请求-响应独立处理
- 服务器无需保留状态
- 优点:提高服务器端的可扩展性
- 故障处理更简单
- 可以处理更高的请求速率
- 请求顺序无关紧要
- 缺点:某些应用需要持久状态
- 需要唯一标识用户或存储临时信息
2.4 HTTP 连接
2.4.1 非持久 HTTP
- 最多只有一个对象在TCP连接上发送
- 下载多个对象需要多个TCP连接
- HTTP/1.0 使用非持久连接
假设用户输入URL:www.someSchool.edu/someDept/home.index
(包含文本和10个就jpeg图像的引用)
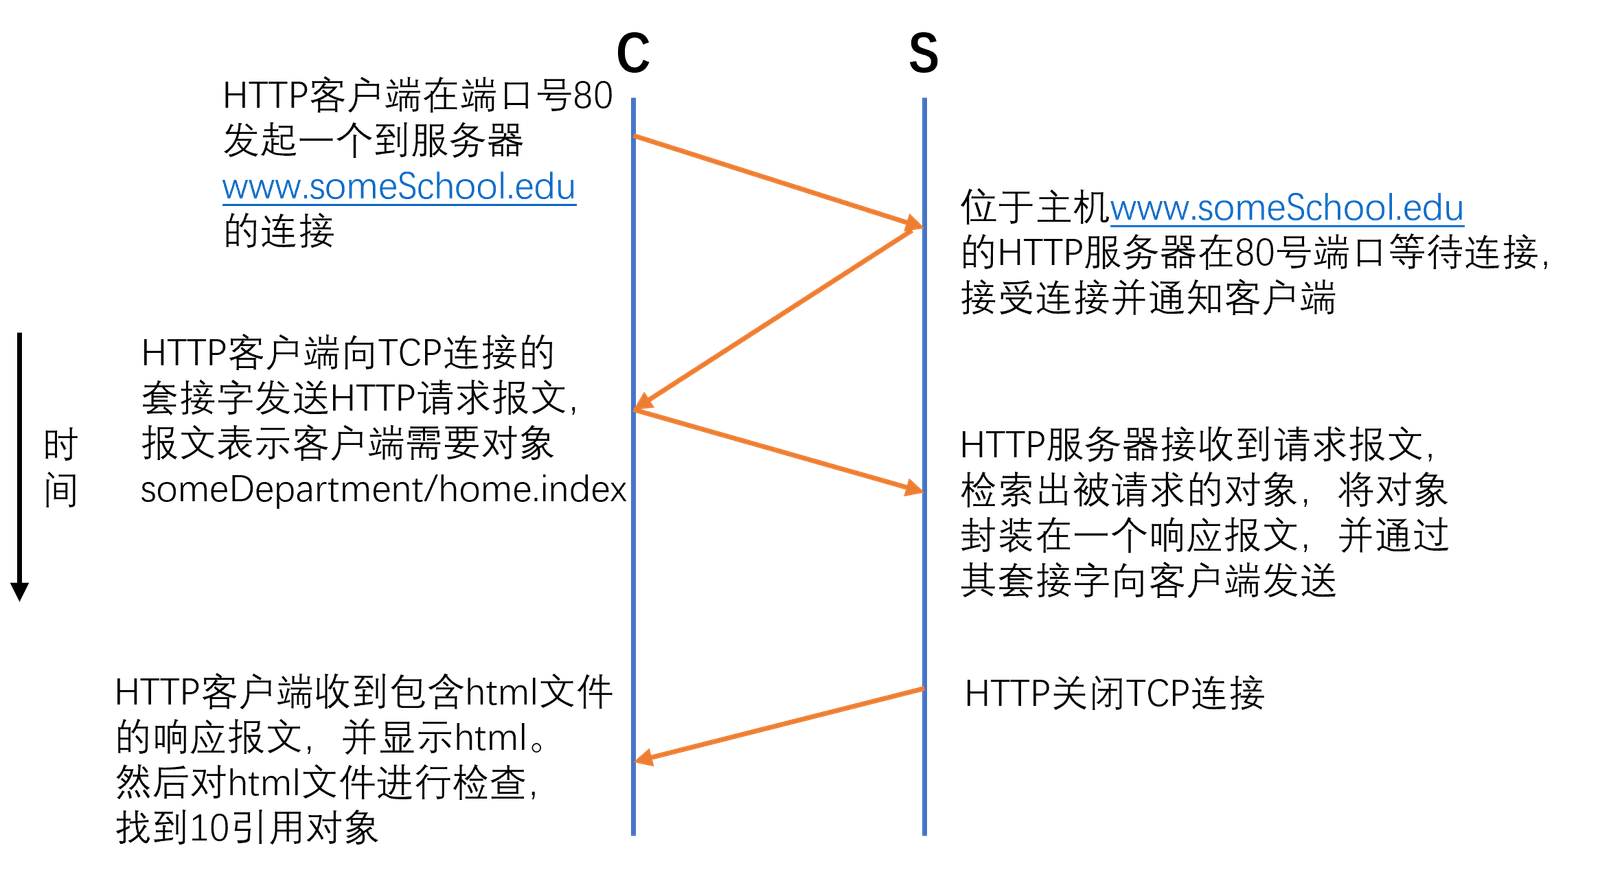
对10jpeg对象,重复以上步骤
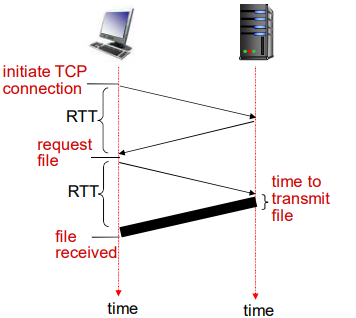
2.4.2 响应时间模型
往返时间 RTT(round-trip time):
- 一个小的分组从客户端到服务器,再回到客户端的时间(传输时间忽略)
响应时间:2RTT + 传输时间
- 一个RTT用来发起 TCP 连接
- 一个 RTT 用来 HTTP 请求并等待 HTTP 响应
- 文件传输时间
2.4.3 持久 HTTP
- 多个对象可以在一个(在客户端和服务器之间的)TCP连接上传输
- HTTP/1.1 默认使用持久连接
非持久HTTP的缺点:
- 每个对象要 2 个 RTT
- 操作系统必须为每个 TCP 连接分配资源
- 但浏览器通常打开并行 TCP 连接,以获取引用对象
原件补充:并行/并发请求 (Concurrent requests and responses)
核心机制:客户端同时打开多个 TCP 连接,并行地发送请求和接收响应
- 客户端 😊:网页加载变快了,体验很好。
- 内容提供商 (Server) 😊:用户满意,服务器也能并发处理。
- 网络 (Network) 😡 为什么?
原因:这会造成网络拥塞。如果有成千上万个客户端同时对服务器发起多个并行连接,网络上的 TCP 连接数会呈指数级暴增。这不仅会吃满路由器的缓存,还会导致严重的丢包和竞争,对脆弱的整体网络环境非常不友好。
持久HTTP:
- 在多个请求之间维持 TCP 连接
- 包括当前页面之后的传输
- 客户端或服务器可以断开连接
- 优点
- 避免连接建立和拆除的开销
- 允许底层(如 TCP)学习 RTT 和带宽特性
- HTTP/1.1 的默认模式
非流水方式的持久 HTTP:
- 客户端只能在收到前一个响应后才能发出新的请求
- 每个引用对象花费一个 RTT
流水方式的持久 HTTP:
- HTTP/1.1 的默认模式
- 客户端遇到一个引用对象就立即产生一个请求
- 所有引用(小)对象只花费一个 RTT 是可能的
性能对比:获取 n 个小对象
时间主要取决于延迟
- 逐个获取:~2n RTT
- m 个并发:~2[n/m] RTT
- 持久连接:~(n+1)RTT
- 流水线:~2 RTT
- 流水线/持久连接:首次~2 RTT,后续 RTT
性能对比:获取 n 个大对象(每个大小为 F)
时间主要取决于带宽
- 逐个获取:~nF/B
- m 个并发:~[n/m]F/B
- 假设与大量用户共享,且每个 TCP 连接获得相同带宽
- 流水线和/或持久连接:~nF/B
- 唯一有帮助的是获得更多带宽
2.5 HTTP 请求报文
两种类型的 HTTP 报文:请求、响应
HTTP 请求报文:ASCII (人能阅读)
method URL HTTP-Version CRLF
header-field-name:value1 CRLF
...
header-field-name:valueN CRLF
CRLF
[Entity-body]
- 第一行称为请求行
- 中间部分为首部行
- 最后一行换行回车符,表示报文结束
GET /somedir/page.html HTTP/1.1
Host: www.someschool.edu
User-agent: Mozilla/4.0
Connection: close
Accept-language:fr
2.5.1 提交表单输入
- Post 方式
- 网页通常包括表单输入
- 包含在实体主体(entity body)中的输入被提交到服务器
- URL 方式:
- 方法:GET
- 输入通过请求行的 URL 字段上载
www.somesite.com/animalsearch?monkeys&banana

http://www.baidu.com/s?wd=xx+yy+zzz&cl=3
- 参数:wd,cl
- 参数值:XX+YY+zzz,3
2.5.2 方法类型
- HTTP/1.0
- GET
- POST
- HEAD:要求服务器在响应报文中不包含请求对象->故障跟踪
- HTTP/1.1
- GET, POST, HEAD
- PUT:将实体主体中的文件上载到URL字段规定的路径
- DELETE:删除URL字段规定的文件
2.6 HTTP 响应报文
HTTP/1.1 200 OK\r\n
Connection: close\r\n
Date: Thu, 06 Aug 1998 12:00:15 GMT\r\n
Server: Apache/1.3.0 (Unix) \r\n
Last-Modified: Mon, 22 Jun 1998 …... \r\n
Content-Length: 6821\r\n
Content-Type: text/html\r\n
\r\n
data data data data data ...
- 第一行是状态行(协议版本、状态码和相应状态信息)
- 中间部分为首部行
- 最后的是数据,如请求的HTML文件
2.7 用户-服务器状态:cookies
大多数主要的门户网站使用 cookies,解决 HTTP 协议“无状态”的特性
4个组成部分:
- 在HTTP响应报文中有一个 cookie 的首部行
- 在HTTP请求报文含有一个 cookie 的首部行
- 在用户端系统中保留有一个 cookie 文件,由用户的浏览器管理
- 在Web站点有一个后端数据库
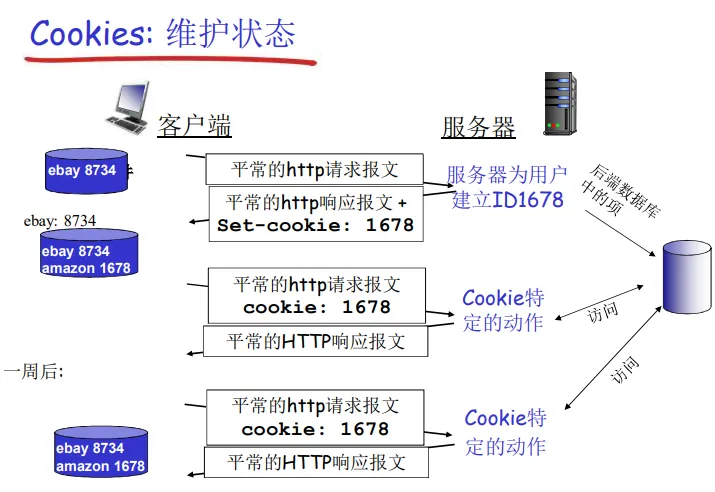
Cookies 能带来什么:用户验证、购物车、推荐、用户状态(Web email)
如何维持状态:
- 协议端节点:在多个事务上,发送端和接收端维持状态
- cookies: http 报文携带状态信息
Cookies and privacy
- Cookies permit servers to learn a lot about user
- User may supply name and Email to servers
- Search engines may use cookies to obtain info across sites
- Hacked browser may do bad things with cookies
2.8 Web 缓存 (代理服务器)
目标:不访问原始服务器,就满足客户的请求
- 用户设置浏览器: 通过缓存访问 Web
- 浏览器将所有的 HTTP 请求发给缓存
- 在缓存中的对象:缓存直接返回对象
- 如对象不在缓存,缓存请求原始服务器,然后再将对象返回给客户端
- 缓存既是客户端又是服务器
- 通常缓存是由 ISP 安装 (大学、公司、居民区 ISP)
- “正向代理”
使用 Web 缓存的好处:
- 降低客户端的请求响应时间
- 可以大大减少一个机构内部网络与 Internent 接入链路上的流量
- 互联网大量采用了缓存:可以使较弱的 ICP 也能够有效提供内容
假设
- 平均对象大小 = 100kb
- 机构内浏览器对原始服务器的平均请求率为 = 15请求/s
- 平均到浏览器的速率:1.5Mbps
- 机构内部路由器到原始服务器再返回到路由器的的延时(Internet 延时)= 2s
- 接入链路带宽:1.54Mbps
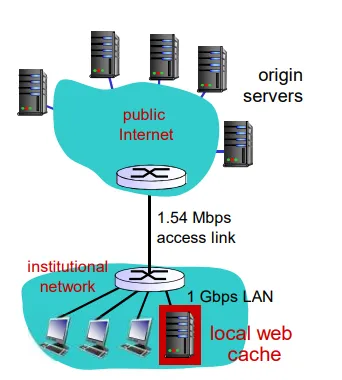
结果
- LAN 的流量强度 = 15%
- 接入链路上的流量强度 = 99%(\(1.5 / 1.54 \approx 0.99\))
- 总延时 = LAN 延时 + 接入延时 + Internet 延时 = ms + 分 + 2s
如果增加链路带宽,流量强度降低,总延迟降低,但是昂贵
安装本地缓存:
- 假设缓存命中率0.4
- 40%请求在缓存中被满足
- 其他60%的请求需要被原始服务器满足
- 接入链路利用率:
- 60%的请求采用接入链路
- 经过接入链路到达浏览器的数据速率 = 0.6*1.50 Mbps = 0.9 Mbps
- 利用率 = 0.9/1.54 = 0.58
- 总体延迟:
- = 0.6 * (从原始服务器获取对象的延迟) + 0.4 * (从缓存获取对象的延迟)
- = 0.6 (2.01) + 0.4 (~msecs)
- = ~ 1.2 secs
- 比安装154Mbps链路还来得小 (而且比较便宜)
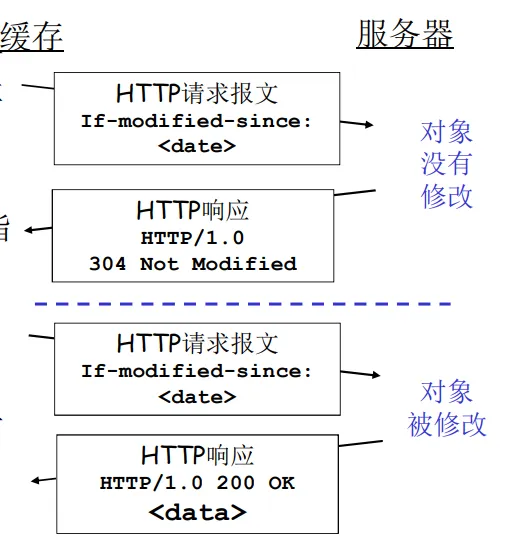
条件GET方法
目标:如果缓存器中的对象拷贝是最新的,就不发送对象
缓存器: 在HTTP请求中指定缓存拷贝的日期 If-modified-since:<date>
Caching: Where?
- Client (browser)
- Forward proxies
- Reverse proxies
- Content Distribution Network
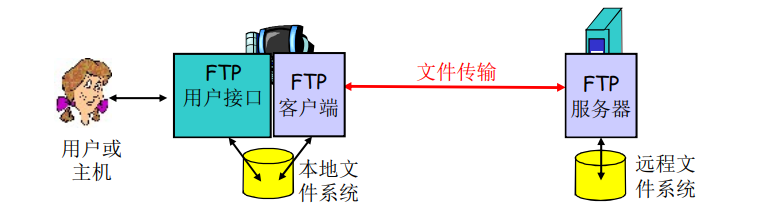
3 FTP
文件传输协议(File Transfer Protocol)
- 向远程主机上传输或接收文件
- 客户/服务器模式
- 客户端:发起传输的一方
- 服务器:远程主机
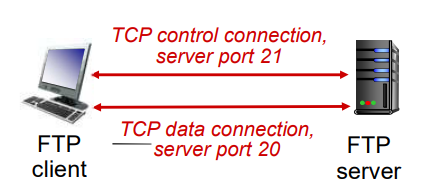
控制连接与数据连接分开
-
FTP 客户端与 FTP 服务器通过端口 21 联系,并使用 TCP 为传输协议
-
客户端通过控制连接获得身份确认
-
客户端通过控制连接发送命令浏览远程目录
-
收到一个文件传输命令时,服务器打开一个到客户端的数据连接(服务器主动向客户端)
-
一个文件传输完成后,服务器关闭连接
-
服务器打开第二个TCP数据连接用来传输另一个文件
-
FTP服务器维护用户的状态信息:当前路径、用户帐户与控制连接对应
-
有状态
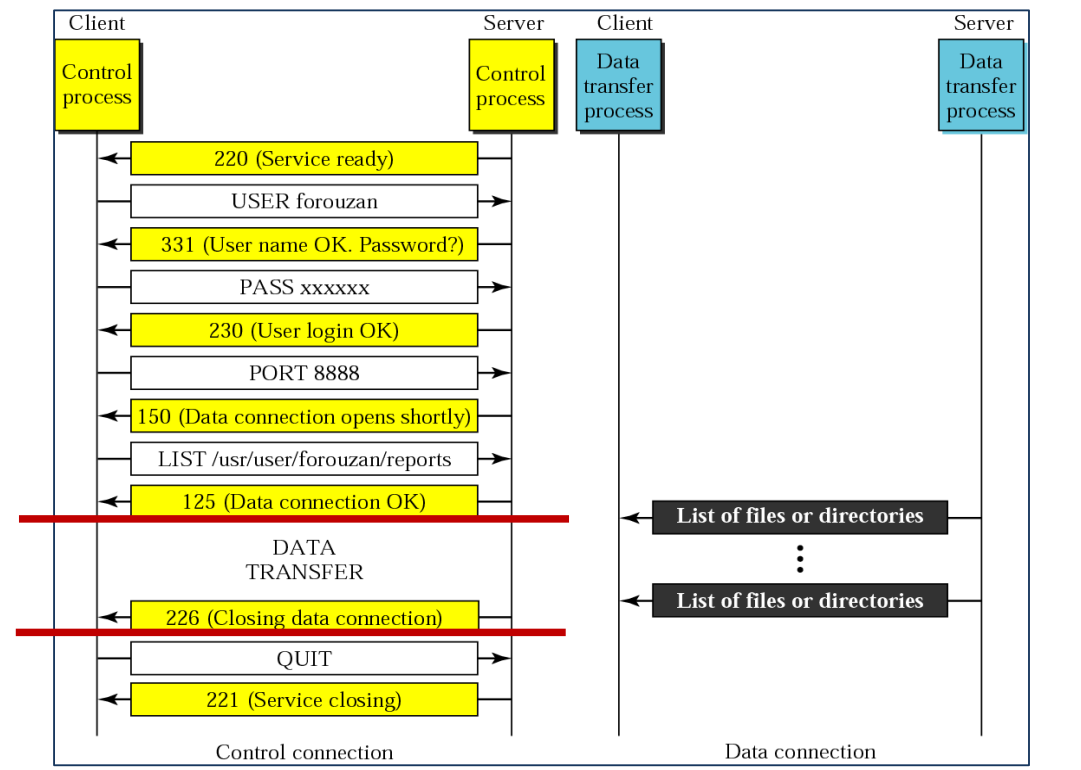
| Sample commands: | Sample return codes: |
|---|---|
| • Sent as ASCII text over control channel | • Status code and phrase (as in HTTP) |
| • USER username | • 331 Username OK, password required |
| • PASS password | • 125 data connection already open; transfer starting |
| • LIST return list of file in current directory | • 425 Can’t open data connection |
| • RETR filename retrieves (gets) file | • 452 Error writing file |
| • STOR filename stores (puts) file onto remote server |
4 EMail
• 互联网上使用最广泛的应用之一 • SMTP:简单邮件传输协议 – 传送简单文本消息 • MIME:多用途互联网邮件扩展 – 传送其他类型数据,如语音、图像、视频片段 • POP:邮局协议 – 从服务器检索邮件,包括身份验证和下载 • IMAP:Internet 邮件访问协议 – 操作服务器上存储的邮件
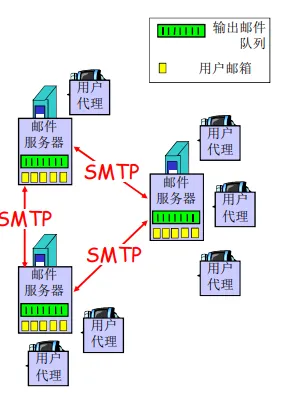
3个主要组成部分:
- 用户代理
- 又名 “邮件阅读器”
- 撰写、编辑和阅读邮件
- 输出和输入邮件保存在服务器上
- 邮件服务器
- 邮箱中管理和维护发送给用户的邮件
- 输出报文队列保持待发送邮件报文
- 邮件服务器之间的 SMTP 协议:发送 email 报文
- 客户:发送方邮件服务器
- 服务器:接收方邮件服务器
- 简单邮件传输协议:SMTP
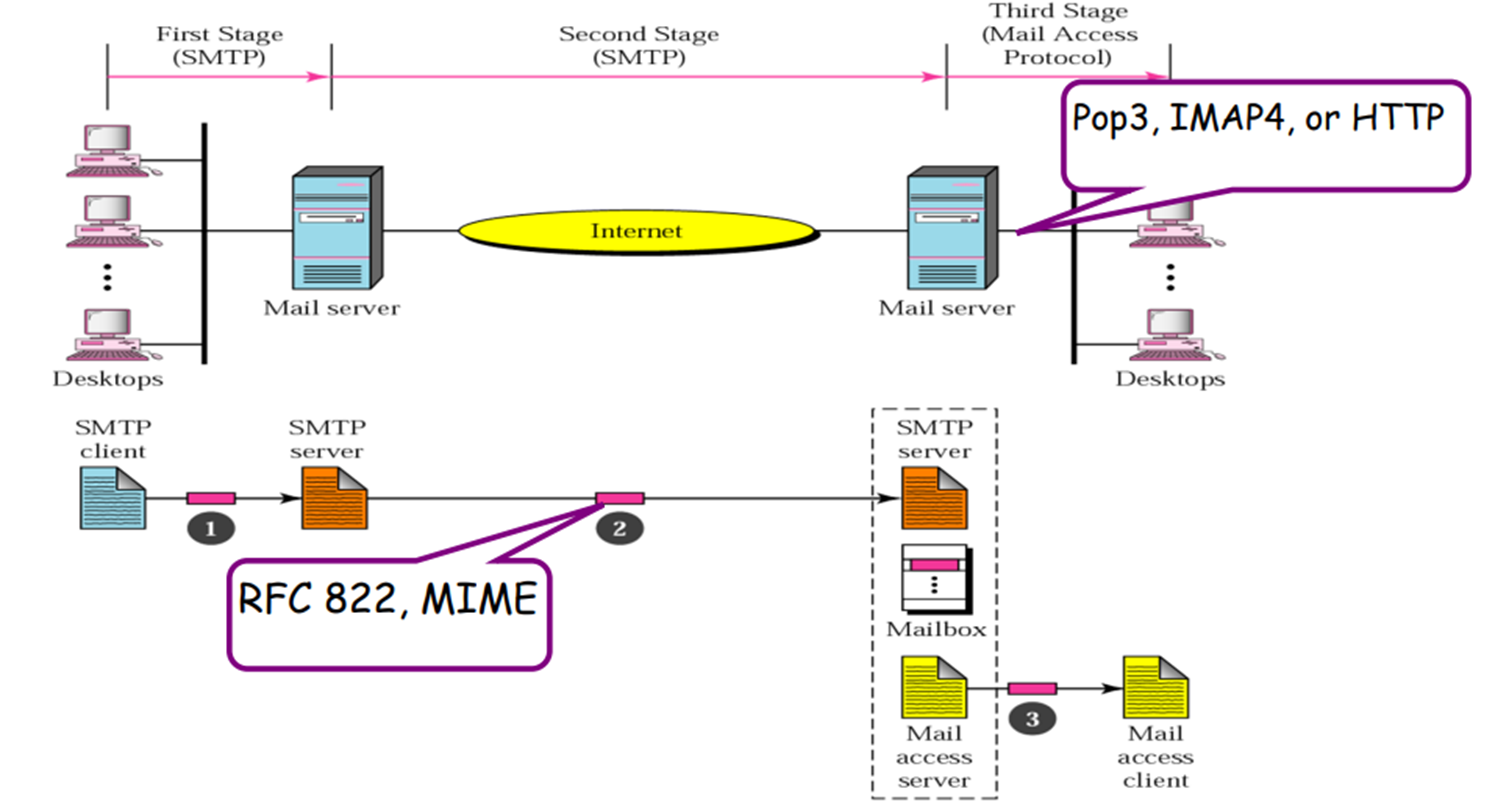
4.1 邮件传递的阶段
- 第一阶段
- 邮件从本地用户代理发送到本地 SMTP 服务器
- 用户代理充当 SMTP 客户端
- 本地服务器充当 SMTP 服务器
- 第二阶段
- 邮件由本地服务器中继到远程 SMTP 服务器
- 此时本地服务器充当 SMTP 客户端
- 第三阶段
- 远程用户代理使用邮件访问协议访问远程服务器上的邮箱
- POP3 或 IMAP4
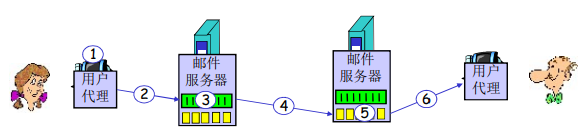
- Alice 使用用户代理撰写邮件并发送给 bob@someschool.edu
- Alice 的用户代理将邮件发送到她的邮件服务器,邮件放在报文队列中
- SMTP 的客户端打开到 Bob 邮件服务器的 TCP 连接
- SMTP 客户端通过 TCP 连接发送 Alice 的邮件
- Bob 的邮件服务器将邮件放到Bob的邮箱
- Bob 调用他的用户代理阅读邮件
4.2 SMTP
- 使用 TCP 在客户端和服务器之间传送报文,端口号为 25
- 直接传输:从发送方服务器到接收方服务器
- 传输过程依赖于写在邮件“信封”上的信息(即消息头)
- 路径追踪:协议允许在消息头中添加日志信息,以显示邮件传输所经过的路径
- 传输的 3 个阶段
- 握手
- 传输报文
- 关闭
- 命令/响应交互
- 命令:ASCII 文本
- 响应:状态码和状态信息
- 不包含格式定义:SMTP 本身不涵盖邮件消息的具体格式或数据内容
SMTP 的可靠性
- 通过 TCP 连接从发送方向接收方传输邮件
- 依赖 TCP 提供可靠服务
- 不保证能够恢复丢失的邮件
- 没有对发件人(用户)的端到端确认
- 错误指示的传递无法保证
- 仅表明邮件已到达主机,但未必到达用户
- 通常被认为是可靠的
SMTP:总结
- SMTP 使用持久连接
- SMTP 要求报文(首部和主体)为 7 位 ASCII 编码
- SMTP 服务器使用 CRLF.CRLF 决定报文的尾部
HTTP比较:
- HTTP:拉(pull)
- SMTP:推(push)
- 二者都是ASCII形式的命令/响应交互、状态码
- HTTP:每个对象封装在各自的响应报文中
- SMTP:多个对象包含在一个报文中
4.3 邮件访问协议
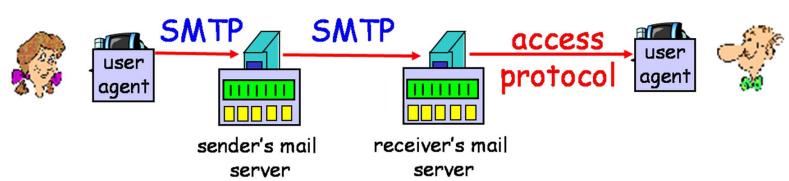
前两跳是“推”,最后一跳是“拉”
SMTP: 传送到接收方的邮件服务器 邮件访问协议:从服务器访问邮件(Mail access protocol)
- POP:邮局访问协议(Post Office Protocol)
- 用户身份确认 (代理<–>服务器) 并下载
- IMAP:Internet 邮件访问协议(Internet Mail Access Protocol)
- 更多特性 (更复杂)
- 在服务器上处理存储的报文
- HTTP:Hotmail , Yahoo! Mail等
- 方便
4.3.1 POP3 协议
- 用户确认阶段
- 客户端命令:
- user: 申明用户名
- pass: 口令
- 服务器响应
- +OK
- -ERR
- 客户端命令:
- 事物处理阶段, 客户端:
- list: 报文号列表
- retr: 根据报文号检索报文
- dele: 删除
- quit
4.3.2 POP3 与 IMAP
POP3 协议通过“下载并删除”或“下载并保留”模式在本地管理邮件,属于无状态协议;而 IMAP 协议则将所有邮件集中存储在服务器端,支持多设备同步访问、文件夹管理以及跨会话的状态保持(如已读、回复状态)
POP3
- 操作模式:
- 下载并删除:这是默认模式。邮件被下载到客户端后从服务器删除。缺点是如果用户更换客户端(例如从办公室换到家里),无法重新读取之前的邮件。
- 下载并保留:邮件在服务器上保留副本。这允许用户在不同客户端上获取邮件的副本,解决了移动办公的需求。
- 状态特性:
- 跨会话无状态:POP3 不记录用户在服务器上的操作状态。一旦会话结束,服务器不知道用户是否阅读或处理了邮件。
IMAP
- 集中存储:
- 所有邮件都保存在服务器这一“单一位置”。
- 复杂用例支持:
- 支持多用户或多设备同时访问同一邮箱。例如,Bob 在办公室阅读邮件时,他的妻子可以在家里同时访问同一个邮箱,数据保持同步。
- 组织与管理:
- 允许用户在服务器上创建文件夹来组织邮件。
- 状态保持:
- 跨会话有状态:IMAP 会在服务器上记录用户的操作状态。
- 记录内容:包括文件夹名称、邮件ID与文件夹的映射关系,以及邮件的具体状态(如:已读、已回复、已删除)。
4.4 邮件报文格式
SMTP:交换 email 报文的协议
- 首部行:如
- To: Alice@sina.com
- From: Bob@gmail.com
- Subject: Dinner tonight
- 与 SMTP 命令不同
- 主体
- 报文,只能是 ASCII 码字符
- Mail destinations: Mailbox @ SMTP Server
- Mailbox: Name of mailbox on the SMTP server
- SMTP Server: DNS name or IP of the SMTP server
首部
空行 <-
主体
4.5 MIME
MIME:多媒体邮件扩展(multimedia mail extension)
解决 SMTP 只支持 7 位的 ASCII 码的问题
- 核心功能与扩展性
- 扩展并自动化了邮件的编码机制
- 允许用户将独立的组件整合到单封邮件中
- 除了普通文本,邮件现在可以包含:程序、图片、音频、视频
- 主要特性
- 向后兼容性:与现有的邮件系统完全兼容
- 编码方式:所有内容均被编码为 7 位 ASCII 格式
- 非 MIME 系统处理:对于不支持 MIME 的旧系统,MIME 的头部信息和分隔符会被直接忽略,从而避免乱码或错误
- 可扩展性:MIME 架构是开放的。只要发送方和接收方就编码方案达成一致,即可支持新的数据类型
- 向后兼容性:与现有的邮件系统完全兼容
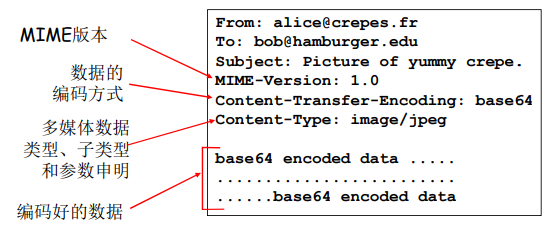
• 5 new mail header fields
- MIME version
- Content type
- Content transfer encoding
- Content Id
- Content Description
• Number of content formats defined • Transfer encoding defined
5 DNS
DNS 域名系统(Domain Name System),用于实现域名到IP地址的转换
DNS 的必要性
- IP地址标识主机、路由器
- 存在着 “字符串” — IP 地址的转换的必要性
- 人类用户提供要访问机器的“字符串”名称
- 由DNS负责转换成为二进制的网络地址
DNS系统需要解决的问题:
- Q1 如何命名设备
- 用有意义的字符串:好记,便于人类用使用
- 解决一个平面命名的重名问题:层次化命名
- Q2 如何完成名字到IP地址的转换
- 分布式的数据库维护和响应名字查询
- Q3 如何维护
- 增加或者删除一个域,需要在域名系统中做哪些工作
5.2 DNS 总体思路和目标
主要思路
- 分层的、基于域的命名机制
- 若干分布式的数据库完成名字到IP地址的转换
- 运行在UDP之上端口号为53的应用服务
- 核心的Internet功能,但以应用层协议实现
- 在网络边缘处理复杂性
主要目的
- 实现主机名-IP地址的转换
- 其它目的
- 主机别名到规范名字的转换:Host aliasing
- 邮件服务器别名到邮件服务器的正规名字的转换:Mail server aliasing
- 负载均衡:Load Distribution
5.3 Q1 DNS 名字空间
DNS域名结构
- 一个层面命名设备会有很多重名
- DNS 采用层次树状结构的命名方法
- Internet 根被划为几百个顶级域
- 每个(子)域下面可划分为若干子域
- 树叶是主机
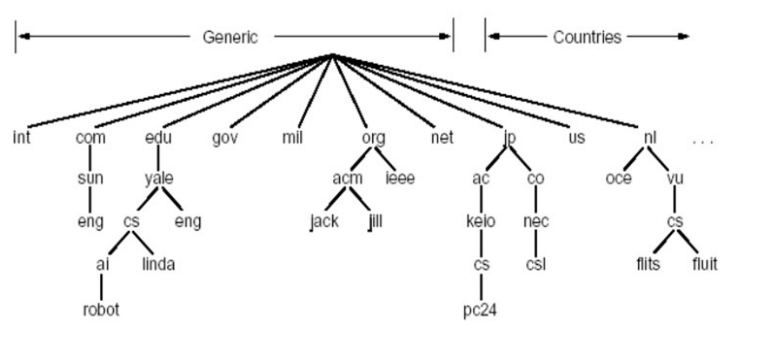
域名(Domain Name)
- 从本域往上,直到树根
- 中间使用“.”间隔不同的级别
- 域的域名:可以用于表示一个域
- 主机的域名:一个域上的一个主机
假设你正在为一个小游戏项目搭建网络架构,并且你注册了一个域的域名叫 mygame.com。
- 域的使用:mygame.com 是你拥有的整个资产的名称。
- 主机的分配:
- 你配置了一台运行着 Spring Boot 后端程序的 Linux 虚拟机,你可以给这台主机分配一个域名:api.mygame.com。
- 你可能还有另一台专门运行 MySQL 的数据库服务器,你可以给这台主机分配域名:db.mygame.com。
- 前端 React 页面所在的 Web 服务器,主机域名可以是 www.mygame.com。
在这个例子中,api、db、www 都是特定主机的名称,而它们共同归属于 mygame.com 这个域。当客户端发起网络请求时,DNS 最终会将这些“主机的域名”解析为你那些虚拟机的具体 IP 地址。
域名的管理
域与物理网络无关
- 域遵从组织界限,而不是物理网络
- 一个域的主机可以不在一个网络
- 一个网络的主机不一定在一个域
- 域的划分是逻辑的,而不是物理的
5.4 Q2 解析问题-名字服务器
- 一个名字服务器的问题
- 可靠性问题:单点故障
- 扩展性问题:通信容量
- 维护问题:远距离的集中式数据库
- 区域(zone)
- 区域的划分由区域管理者自己决定
- 将DNS名字空间划分为互不相交的区域,每个区域都是树的一部分
- 名字服务器:
- 每个区域都有一个名字服务器:维护着它所管辖区域的权威信息
- 名字服务器允许被放置在区域之外,以保障可靠性
权威DNS服务器:组织机构的DNS服务器,提供组织机构服务器(如Web和mail)可访问的主机和IP之间的映射
组织机构可以选择实现自己维护或由某个服务提供商来维护
TLD服务器
- 顶级域(TLD)服务器:负责顶级域名和所有国家级的顶级域名
区域名字服务器维护资源记录(Resource Record, RR)
资源记录
- 作用:维护域名-IP地址(其它)的映射关系
- 位置:Name Server的分布式数据库中
RR格式: (domain_name, ttl, type,class,Value)
- Domain_name: 域名
- Ttl: time to live: 生存时间(权威,缓冲记录)
DNS大致工作过程
- 应用调用解析器(resolver)
- 解析器作为客户向Name Server发出查询报文(封装在UDP段中)
- Name Server返回响应报文(name/ip)
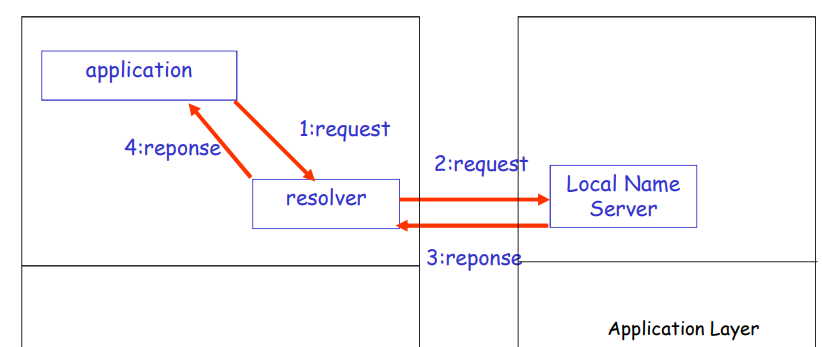
本地名字服务器(Local Name Server):
- 并不严格属于层次结构
- 每个ISP(居民区的ISP、公司、大学)都有一个本地DNS服务器
- 也称为 “默认名字服务器”
- 当一个主机发起一个DNS查询时,查询被送到其本地DNS服务器
- 起着代理的作用,将查询转发到层次结构中
名字服务器 (Name Server)
名字解析过程:
- 目标名字在Local Name Server中
- 情况1:查询的名字在该区域内部(权威应答)
- 情况2:缓存(caching)
当与本地名字服务器不能解析名字时,联系根名字服务器顺着根-TLD一直找到权威名字服务器
递归查询
- 名字解析负担都放在当前联络的名字服务器上
- 问题:根服务器的负担太重
- 解决办法:迭代查询
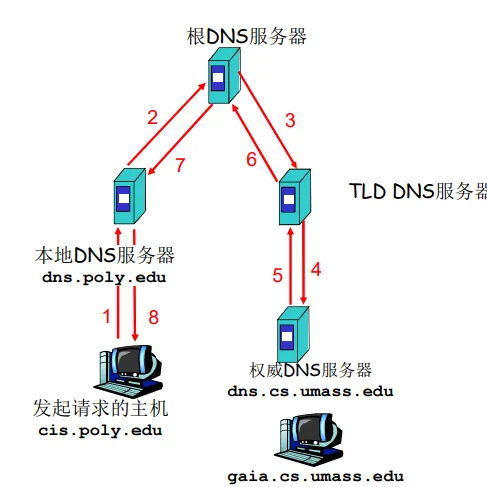
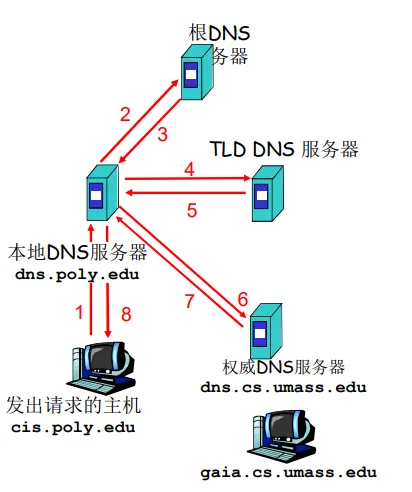
迭代查询
- 根(及各级域名)服务器返回的不是查询结果,而是下一个NS的地址
- 最后由权威名字服务器给出解析结果
- 当前联络的服务器给出可以联系的服务器的名字
DNS协议、报文*
DNS协议:查询和响应报文的报文格式相同
|<--- 2 bytes ---->|<--- 2 bytes ---->|
+------------------+------------------+
|  identification  |     flags        |
+------------------+------------------+
|  # questions     | # answer RRs     |
+------------------+------------------+
| # authority RRs  | # additional RRs |
+------------------+------------------+
| questions (variable # of questions) | 一个查询的Name, type字段
+------------------+------------------+
|    answers (variable # of RRs)      | 对应查询的RR记录
+------------------+------------------+
|    authority (variable # of RRs)    | 权威服务器的记录
+------------------+------------------+
| additional info (variable # of RRs) | 权威服务器的记录
+------------------+------------------+
报文首部
- 标识符(ID):16位
- flags:
- 查询/应答
- 希望递归
- 递归可用
- 应答为权威
提高性能:缓存
- 一旦名字服务器学到了一个映射,就将该映射缓存起来
- 根服务器通常都在本地服务器中缓存着
- 使得根服务器不用经常被访问
- 目的:提高效率
- 可能存在的问题:如果情况变化,缓存结果和权威资源记录不一致
- 解决方案:TTL(默认2天)
5.5 Q3 维护问题:新增一个域
- 在上级域的名字服务器中增加两条记录,指向这个新增的 子域的域名 和 域名服务器的地址
- 在新增子域的名字服务器上运行名字服务器,负责本域的名字解析:名字 -> IP地址
例子:在 com 域中建立一个 “Network Utopia”
- 到注册登记机构注册域名 networkutopia.com
- 需要向该机构提供权威DNS服务器(基本的、和辅助的)的名字和IP地址
- 登记机构在com TLD服务器中插入两条RR记录: (networkutopia.com, dns1.networkutopia.com, NS) (dns1.networkutopia.com, 212.212.212.1, A)
- 在networkutopia.com的权威服务器中确保有
- 用于Web服务器的www.networkuptopia.com的类型为A的记录
- 用于邮件服务器mail.networkutopia.com的类型为MX的记录
攻击DNS(结论:DNS比较健壮)。
6 P2P 应用
6.1 纯P2P架构
- 没有(或极少)一直运行的服务器
- 任意端系统都可以直接通信
- 利用peer的服务能力
- Peer 节点间歇上网,每次IP地址都有可能变化
6.2 文件分发:C/S vs P2P
从一台服务器分发文件(大小 F)到 N 个 peer 需要多少时间?
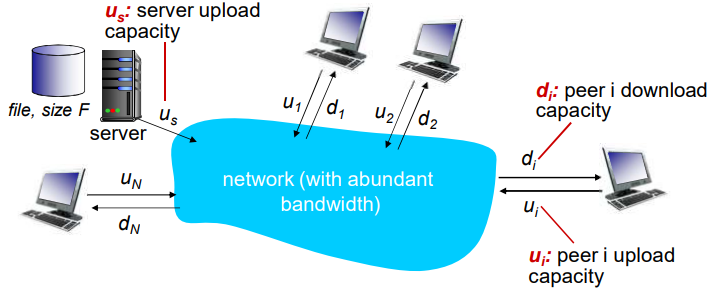
C/S模式
-
服务器传输:都是由服务器发送给 peer,服务器必须顺序传输(上载)N 个文件拷贝:
- 发送一个 copy:\(F/u_s\)
- 发送 N 个 copy:\(NF/u_s\)
-
客户端:每个客户端必须下载一个文件拷贝
- \(d_{min}\) = 客户端最小的下载速率
- 下载带宽最小的客户端下载的时间:\(F/d_{min}\)
采用 C-S 方法将一个 \(F\) 大小的文件分发给 \(N\) 个客户端耗时:
- 当 \(N\) 很小时 \(F/d_{min}\) 为主导(本质是客户端下载带宽 \(d_{min}\)),一般不考虑
- 当 \(N\) 很大时 \(NF/u_s\) 为主导(本质是服务器上载带宽 \(u_s\)),而 \(NF/u_s\) 随着 \(N\) 的增大而线性增大
P2P模式
-
服务器传输:最少需要上载一份拷贝
- 发送一个拷贝的时间:\(F/u_s\)
-
客户端:每个客户端必须下载一个拷贝
- 最小下载带宽客户端单耗时:\(F/d_{min}\)
-
客户端:所有客户端总体下载量 \(NF\)
- 除了服务器可以上载,其他所有的 peer 节点都可以上载
- 最大上载带宽是:\(u_s + Σu_i\)
采用 P2P 方法将一个 \(F\) 大小的文件分发给 \(N\) 个客户端耗时:
- \(NF/(u_s + \sum u_i)\):分子随着N线性变化,但分母也在变
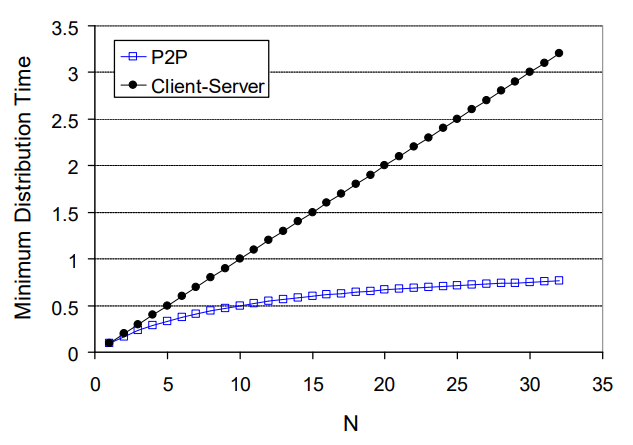
P2P 详细内容:略
7 CDN
- 视频流量:占据着互联网大部分的带宽
- 挑战:规模性-如何服务者
- 单个超级服务器无法提供服务
- 挑战:异构性
- 不同用户拥有不同的能力(例如:有线接入和移动用户;带宽丰富和受限用户)
- 解决方案: 分布式的,应用层面的基础设施
7.2 多媒体流化服务:DASH*
DASH: Dynamic, Adaptive Streaming over HTTP
- 服务器:
- 将视频文件分割成多个块
- 每个块独立存储,编码于不同码率(8-10种)
- 告示文件(manifest file): 提供不同块的URL
- 客户端:
- 先获取告示文件
- 周期性地测量服务器到客户端的带宽
- 查询告示文件,在一个时刻请求一个块,HTTP头部指定字节范围
- 如果带宽足够,选择最大码率的视频块
- 会话中的不同时刻,可以切换请求不同的编码块 (取决于当时的可用带宽)
“智能” 客户端: 客户端自适应决定
- 什么时候去请求块 (不至于缓存挨饿,或者溢出)
- 请求什么编码速率的视频块 (当带宽够用时,请求高质量的视频块)
- 哪里去请求块 (可以向离自己近的服务器发送URL,或者向高可用带宽的服务器请求)
7.3 CDN: 内容分发网络
CDN: Content Delivery Network
选择1: 单个的、大的超级服务中心
- 服务器到客户端路径上跳数较多,瓶颈链路的带宽小导致停顿
- “二八规律” 决定了网络同时充斥着同一个视频的多个拷贝,效率低(付费高、带宽浪费、效果差)
- 单点故障,性能瓶颈
- 周边网络的拥塞
评述:相当简单,但是这个方法不可扩展
选项2: 通过CDN,全网部署缓存节点,存储服务内容,就近为用户提供服务,提高用户体验
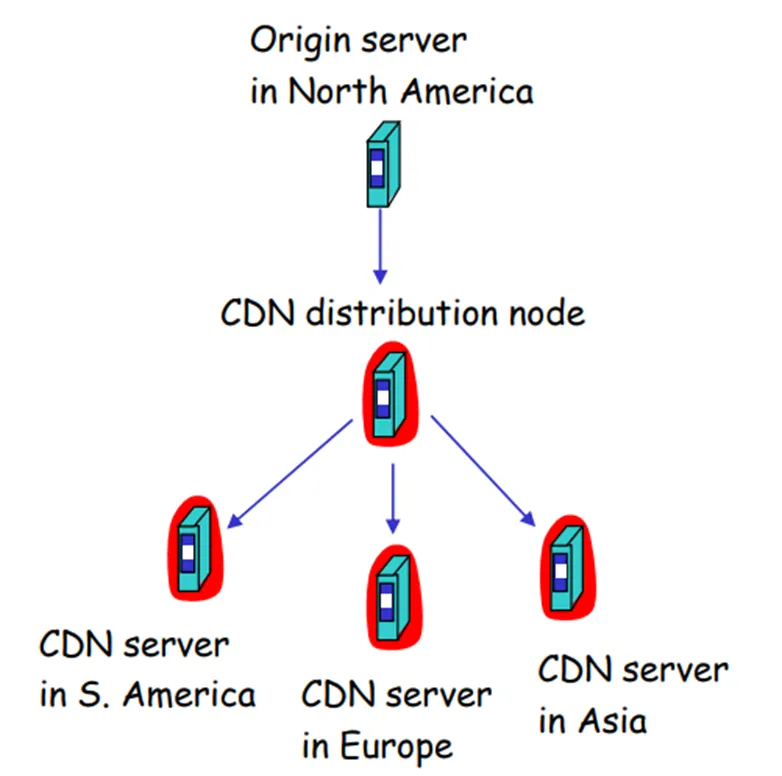
部署缓存节点策略:
- 深入部署模式
- 将 CDN 服务器深入到许多接入网
- 更接近用户,数量多,离用户近,管理困难
- 集中部署 / 带回式模式
- 部署在少数(10个左右)关键位置,如将服务器簇安装于POP附近(离若干1st ISP POP较近)
- 采用租用线路将服务器簇连接起来
CDN: 在CDN节点中存储内容的多个拷贝
用户从CDN中请求内容
- 重定向到最近的拷贝,请求内容
- 如果网络路径拥塞,可能选择不同的拷贝
内容复制
- 内容提供者(源服务器)是 CDN 的客户
- CDN 在 CDN 服务器中复制客户的内容
- 当提供者更新内容时,CDN 更新其服务器
- 使用权威 DNS 服务器重定向请求
支撑技术
- DNS
- 一个名称映射到多个地址
- 路由
- 基于内容的路由(到最近的 CDN 服务器)
- URL 重写
- 重定向策略
- 负载均衡、网络延迟、缓存/内容局部性
重定向
- CDN 创建一张“地图”,指示各叶 ISP 与 CDN 服务器之间的距离
- 当查询到达权威 DNS 服务器时
- 服务器确定查询来源于哪个 ISP
- 使用“地图”确定最佳 CDN 服务器
- CDN 服务器创建一个应用层覆盖网络
- 用户代理:与上层应用和下层网络进行交互
- 实现用户界面和应用层协议,例如
- Web:浏览器、Web 服务器
- Email:邮件阅读器、邮件服务器
- 流媒体音/视频:媒体播放器、媒体服务器
标题:2 应用层
作者:Zwing
创建于:2026-08-08 06:50:13
更新于:2026-08-07 23:07:52
链接:https://zanytriumph.github.io/posts/2 应用层.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可