
第6章 关系数据理论
1 问题的提出
如何评价关系模式设计的好坏?如何设计性能良好的关系模式?
关系数据库的规范化理论,就是为了解决上述两个问题而提出的关系数据库设计理论
关系模式常见的问题:数据冗余度高、更新异常、插入异常、删除异常
范式:是对一个关系中允许存在的数据依赖的要求
如果一个关系模式满足高级别范式对数据依赖的要求,那么它肯定也满足低级别范式对函数依赖的要求
如果某一关系模式 \(R\) 满足范式 \(n\) 的要求,则称关系模式 \(R\) 为第 \(n\) 范式,可简记为 \(R\in nNF\)
一个低一级范式的关系模式,通过模式分解可以转换为若干个高一级范式的关系模式的集合,这种过程就叫规范化
2 函数依赖与码
设 \(R(U)\) 是一个属性集 \(U\) 上的关系模式, \(X\) 和 \(Y\) 是 \(U\) 的子集。若对于 \(R(U)\) 的任意一个可能的关系 \(r\) , \(r\) 中不可能存在两个元组在 \(X\) 上的属性值相等,而在 \(Y\) 上的属性值不等,则称 “ \(X\) 函数确定 \(Y\) ”或 “ \(Y\) 函数依赖于 \(X\) ”,记作 \(X \rightarrow Y\) 。
如果存在函数依赖 \(X \rightarrow Y\)
- \(X\) 称为这个函数依赖的决定因素
- \(Y\) 称为这个函数依赖的依赖因素
若 \(X \rightarrow Y\) , 并且 \(Y \rightarrow X\) , 则记为 \(X \leftrightarrow Y\) 若 \(Y\) 不函数依赖于 \(X\) , 则记为 \(X \nrightarrow Y\)
学生关系 \(Student(Sno, Sname, Ssex, Sage, Sdept)\)
- \(Sno → Ssex\)
- \(Sno → Sage\)
- \(Sno → Sdept\)
在关系模式 \(R(U)\) 中,对于 \(U\) 的子集 \(X\) 和 \(Y\),
- 如果 \(X \rightarrow Y\) 但 \(Y \not\subseteq X\),则称 \(X \rightarrow Y\) 是 ‘非平凡函数依赖’
- 如果 \(X \rightarrow Y\) 但 \(Y \subseteq X\),则称 \(X \rightarrow Y\) 是 ‘平凡函数依赖’
对于任一关系模式,平凡函数依赖都是必然成立的
在关系 \(SC(Sno, Cno, Grade)\) 中
- 非平凡函数依赖:\((Sno, Cno) → Grade\)
- 有平凡函数依赖:\((Sno, Cno) → Sno,(Sno, Cno) → Cno\)
在 \(R(U)\) 中,如果 \(X \rightarrow Y\),并且对于 \(X\) 的任何一个真子集 \(X'\),都有 \(X' \nrightarrow Y\),则称 \(Y\) 对 \(X\) 完全函数依赖,记作 \(X \xrightarrow{F} Y\)
如果 \(X \rightarrow Y\),但 \(Y\) 不完全依赖于 \(X\),则称 \(Y\) 对 \(X\) 部分函数依赖,记作 \(X \xrightarrow{P} Y\)
- 由于 \(Sno \nrightarrow Grade\),\(Cno \nrightarrow Grade\),\(Sno \rightarrow Sdept\)
- 因此 \((Sno,Cno) \xrightarrow{F} Grade\),\((Sno,Cno) \xrightarrow{P} Sdept\)
在 \(R(U)\) 中,如果 \(X \rightarrow Y\),\(Y \nsubseteq X\),\(Y \not\rightarrow X\),\(Y \rightarrow Z\),\(Z \nsubseteq Y\),则称 \(Z\) 对 \(X\) 传递函数依赖。记为:\(X \xrightarrow{\text{传递}} Z\)
在定义里加上条件 \(Y \nsubseteq X\) 和 \(Z \nsubseteq Y\),是因为:如果 \(Y \subseteq X\) 或 \(Z \subseteq Y\),则 \(X \rightarrow Z\) 就是一个直接函数依赖,并且是一个部分函数依赖或平凡函数依赖
在关系 \(Student(Sno, Sdept, Mname, Cno, Grade)\) 中
- 有:\(Sno \rightarrow Sdept\),\(Sdept \not\rightarrow Sno\),\(Sdept \rightarrow Mname\)
- 所以,\(Sno \xrightarrow{\text{传递}} Mname\)
在学生关系 \(Student(Sno, Sname, Ssex, Sage, Sdept)\) 中
- 假设学生不允许有同名,则有:\(Sno \leftrightarrow Sname\)
- 此时,\(Sno \rightarrow Sdept\) 和 \(Sname \rightarrow Sdept\) 都是直接函数依赖
设 \(K\) 为 \(R(U,F)\) 中的属性或属性组合。若 \(K \xrightarrow{F} U\) ,则 \(K\) 称为 \(R\) 的一个候选码,简称 ‘码’
- 如果 \(K \to U\) (可能是部分函数依赖,也可能是完全函数依赖),则 \(K\) 称为 \(R\) 的一个超码
- 候选码是最小的超码,候选码的真子集一定不是超码
- 候选码的超集是超码
- 如果关系 \(R\) 的所有属性 \(U\) 是 \(R\) 的码,称为全码
- 若关系模式 \(R\) 有多个候选码,则选定其中的一个做为主码
- \(S(Sno, Sdept, Sage)\) 中,单个属性 \(Sno\) 是码(也是超码),\((Sno,Sdept)\) 是超码但不是码
包含在任何一个候选码中的属性,称为主属性 不包含在任何码中的属性称为非主属性
- \(SC(Sno, Cno, Grade)\) 中,只有一个候选码 \((Sno, Cno)\),所以 \(Sno\) 和 \(Cno\) 是关系 SC 的 2 个主属性,\(Grade\) 是关系 SC 的非主属性
\(R\) 中属性或属性组 \(X\) 并非 \(R\) 的码,但 \(X\) 是另一个关系模式的码,则称 \(X\) 是 \(R\) 的外部码,也称外码
- \(SC(Sno, Cno, Grade)\) 中,\(Sno\) 不是码,\(Sno\) 是 \(S(Sno, Sdept, Sage)\) 的码,则 \(Sno\) 是 SC 的外码
具体场景中函数依赖的发现:使用 左边 \(\rightarrow\) 右边 的表,左边的属性从一个开始并累加(组合),右边固定为某一个属性,检查左边与右边是否能达成 多对一 的关系
题目约束 + 常识性判断?
3 范式与规范化
3.1 1NF
如果一个关系模式 \(R\) 的所有属性都是不可分的基本数据项,则 \(R∈1NF\)
第一范式是对关系模式的最起码的要求,不满足第一范式的数据库模式不能称为关系数据库
3.2 2NF
若关系模式 \(R∈1NF\),并且每一个非主属性都完全函数依赖于任何一个候选码,则 \(R∈2NF\)
不允许存在 “非主属性对候选码的部分函数依赖”
\(SLC(Sno,Sdept,Sloc,Cno,Grade)\),\(Sloc\) 为学生的住处,并且每个系的学生住在同一个地方。\(SLC\) 的码为 \((Sno,Cno)\)
- 函数依赖有
- \((Sno, Cno) \xrightarrow{F} Grade\)
- \(Sno \rightarrow Sdept, (Sno, Cno) \xrightarrow{P} Sdept\)
- \(Sno \rightarrow Sloc, (Sno, Cno) \xrightarrow{P} Sloc\)
- \(Sdept \rightarrow Sloc\)
- 非主属性 \(Sdept\) 和 \(Sloc\) 部分函数依赖于码 \((Sno, Cno)\)
- 关系模式 \(SLC\) 不属于 2NF
3.3 3NF
设关系模式 \(R(U,F) \in 1NF\),若 \(R\) 中不存在这样的码 \(X\)、属性组 \(Y\) 及非主属性 \(Z\) (\(Z \nsubseteq Y\)),使得 \(X \rightarrow Y\),\(Y \rightarrow Z\) 成立,\(Y \nleftrightarrow X\),则称 \(R(U,F) \in 3NF\)
不允许存在 “非主属性对于候选码的传递函数依赖”
3.4 BCNF
设关系模式 \(R(U,F) \in 1NF\),若 \(X \to Y\) 且 \(Y \nsubseteq X\) 时 \(X\) 必含有码,则 \(R(U,F) \in BCNF\)
在关系模式 \(R(U, F)\) 中,如果每一个决定属性集都包含候选码,则 \(R ∈ BCNF\),即
只要某个箭头左边的属性(集)不能唯一确定表里的所有数据,它就不满足 BCNF
3.5 4NF
设关系模式 \(R(U,F) \in 1NF\),若对于 \(R\) 的每个非平凡多值依赖 \(X \to \to Y(Y \nsubseteq X)\),\(X\) 都含有码,则 \(R(U,F) \in 4NF\)
4 Armstrong 公理系统
由一组函数依赖推理规则构成的公理系统
作用:① 从一组函数依赖求得蕴涵的函数依赖;② 关系模式的码的计算
三条基本规则:
- 自反律:若 \(Y ⊆ X ⊆U\),则 \(X→Y\)
- 增广律:若 \(X→Y\) 且 \(Z⊆U\),则 \(XZ \to YZ\)
- 传递律:若 \(X→Y\) 且 \(Y→Z\),则 \(X→Z\)
三条扩充规则:
- 合并规则:若 \(X \rightarrow Y\) 且 \(X \rightarrow Z\) ,则 \(X \rightarrow YZ\)
- 分解规则:若 \(X \rightarrow Y\) 且 \(Z \subseteq Y\) ,则 \(X \rightarrow Z\)
- 伪传递规则:若 \(X \rightarrow Y\) 且 \(WY \rightarrow Z\) ,则 \(XW \rightarrow Z\)
设 \(F\) 为属性集 \(U\) 上的一组函数依赖,\(X \subseteq U\), \(X_F^+ = \{ A \mid X \rightarrow A \text{ 能由 } F \text{ 根据 Armstrong 公理导出}, A \in U \}\)
\(X_F^+\) 称为属性集 \(X\) 关于函数依赖集 \(F\) 的闭包
【计算示例】 已知关系模式 \(R(U, F)\) ,其中:\(U = \{A, B, C, D, E\}\) , \(F = \{AB \rightarrow C, B \rightarrow D, C \rightarrow E, EC \rightarrow B, AC \rightarrow B\}\). 求 \((AB)_F^+\) 。
- \(X^{(0)} = AB\)
- 计算 \(X^{(1)}\) :
- 逐一扫描集合 \(F\) 中的各个函数依赖,寻找左部为 \(X^{(0)}\) 的子集的函数依赖;
- 得到两个函数依赖: \(AB \rightarrow C, B \rightarrow D\) . 于是: \(Y = \{C, D\}\)
- 于是: \(X^{(1)} = Y \cup X^{(0)} = \{A, B, C, D\}\)
- 因为 \(X^{(1)} \neq X^{(0)}\) ,所以计算 \(X^{(2)}\) :
- 逐一扫描集合 \(F\) 中的各个函数依赖,寻找左部为 \(X^{(1)}\) 的子集的函数依赖;
- 得到两个函数依赖: \(C \rightarrow E, AC \rightarrow B\) . 于是: \(Y = \{B, E\}\)
- 于是: \(X^{(2)} = Y \cup X^{(1)} = \{A, B, C, D, E\}\)
- 因为 \(X^{(2)}\) 已等于全部属性集合 \(U\) ,所以 \((AB)_F^+ = X^{(2)} = \{A, B, C, D, E\}\) .
【补充算法1】寻找与函数依赖集 \(F\) 等价的极小函数依赖集 \(G\)
- 右部单一化(消除右边的多个属性): 令初始的 \(G = F\) 。检查 \(G\) 中每一个函数依赖,如果右边包含多个属性,比如 \(X \rightarrow (A_1, A_2, \dots, A_n)\),将其拆分为多个右部只有一个属性的函数依赖:\(X \rightarrow A_1, X \rightarrow A_2, \dots, X \rightarrow A_n\) 。
- 消除部分函数依赖(左部最小化):
检查 \(G\) 中每一个左边有多个属性的函数依赖 \(X \rightarrow A\) 。
- 针对左部 \(X\) 中的每一个属性 \(B\),计算去掉 \(B\) 之后的属性集闭包 \((X - B)^+_G\) 。
- 如果 \(A \in (X - B)^+_G\),说明属性 \(B\) 是多余的,用新的函数依赖 \((X - B) \rightarrow A\) 替换掉原来的 \(X \rightarrow A\) 。
- 消除冗余的函数依赖(去掉多余的规则):
对 \(G\) 中的每一个函数依赖 \(X \rightarrow A\) 进行逐一检查 :
- 假装把它从 \(G\) 中删掉,得到一个临时集合 \(G' = G - \{X \rightarrow A\}\) 。
- 在这个临时集合 \(G'\) 的基础下,计算左部 \(X\) 的属性集闭包 \(X^+_{G'}\) 。
- 如果 \(A \in X^+_{G'}\),说明即使没有这条规则,我们依然能通过其他规则推导出 \(A\)。因此,这条规则是冗余的,直接从 \(G\) 中永久删除它 。
- 合并规则: 为了书写简洁,可以将左部相同的函数依赖重新合并起来,例如将 \(X \rightarrow A_1\) 和 \(X \rightarrow A_2\) 合并为 \(X \rightarrow A_1 A_2\) 。
计算出极小函数依赖集的结果,也要主动结合 Armstrong 公理进行 “常识性” 检查 对形如 \(AX \rightarrow A\) 的式子(平方函数依赖),直接删除
5 模式分解
模式分解的目标:既有 ‘无损连接’,又要 ‘保持函数依赖’(但不一定能满足)
符号定义:
- 设 \(\rho=\{R_1(U_1, F_1), R_2(U_2, F_2), \cdots, R_k(U_k, F_k)\}\) 是 \(R(U, F)\) 的一个分解,\(r\) 是 \(R(U, F)\) 的一个关系
- \(r_i=\pi_{R_i}(r)=\{t.U_i \mid t \in r\}=\{t[U_i] \mid t \in r\}\) 是关系 \(r\) 在关系模式 \(R_i\) 上的投影
- 定义 \(m_\rho(r)=\pi_{R_1}(r) \bowtie \pi_{R_2}(r) \bowtie \cdots \bowtie \pi_{R_k}(r)\),即 \(m_\rho(r)\) 是 \(r\) 在 \(\rho\) 中各关系模式上投影的连接
设 \(\rho = \{R_1(U_1, F_1), R_2(U_2, F_2), \cdots, R_k(U_k, F_k)\}\) 是 \(R(U, F)\) 的一个分解,若对 \(R(U, F)\) 的任何一个关系 \(r\) 均有 \(r = m_{\rho}(r)\) 成立,则称分解 \(\rho\) 具有无损连接性,简称 \(\rho\) 为无损分解
若 \(F^+ = (F_1 \cup F_2 \cup \cdots \cup F_k)^+\),则 \(R(U, F)\) 的分解 \(\rho = \{R_1(U_1, F_1), R_2(U_2, F_2), \cdots, R_k(U_k, F_k)\}\) 保持函数依赖
【补充算法2】候选码的计算
设有关系模式 \(R(U, F)\),\(U\) 是关系 \(R\) 的属性集合,\(F\) 是关系上的极小函数依赖集。将属性集合 \(U\) 划分为以下的三个子集:
- 只在函数依赖的左边出现过的属性的集合 \(U_L\) (包括没有出现在任何函数依赖中的属性)
- 只在函数依赖的右边出现过的属性的集合 \(U_R\)
- 在两边都出现过的属性的集合 \(U_A\)
- 在候选码计算中,只需要对 \(U_A\) 中的属性进行 FOR 循环检查
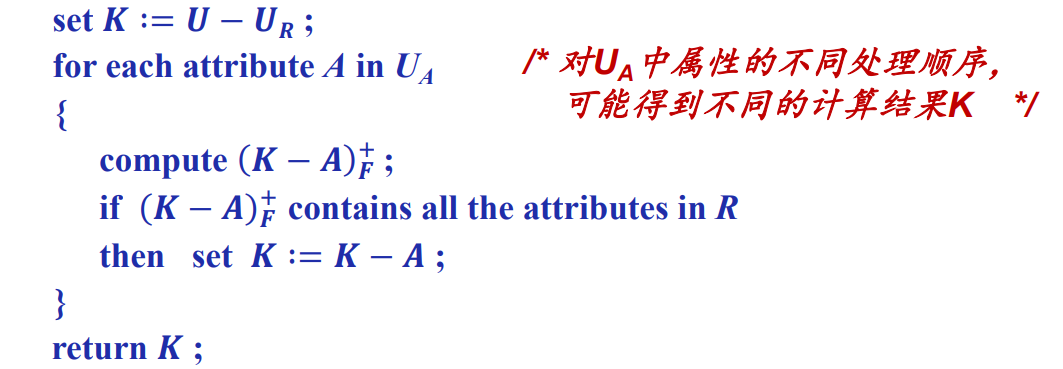
【计算示例】 \(R(A, B, C, D, E, F)\) 及其极小函数依赖集:\(\{ B \to F,\ AD \to BE,\ E \to CD \}\)
只在函数依赖左边出现的属性 \(U_L = \{A\}\)
只在函数依赖右边出现的属性 \(U_R = \{C, F\}\)
在函数依赖两边出现的属性 \(U_A = \{B, D, E\}\)
故 \(A\) 是每一个候选码的组成部分
记 \(F = \{B \to F, AD \to BE, E \to CD\}\),\(U = \{A, B, C, D, E, F\}\)
令 \(K = U - U_R = \{A, B, D, E\}\)
由 \((K - B)^+_F = \{A, B, C, D, E, F\} = U\)
故 \(K = K - B = \{A, D, E\}\)
由 \((K - D)^+_F = \{A, B, C, D, E, F\} = U\)
故 \(K = K - D = \{A, E\}\)
由 \((K - E)^+_F = \{A\} \neq U\)
故 \(R\) 的一个候选码为 \(\{A, E\}\)
同理,继续按 \(U_A = \{B, D, E\}\) 的不同顺序计算 \(K\),得到 \(R\) 的所有候选码为 \(\{A, E\}, \{A, D\}\)
【算法】转换为 3NF 既有无损连接性又保持函数依赖的分解
- 计算 \(F\) 的极小函数依赖集,并用来代替 \(F\) 进行后续的模式分解
- \(\rho = \varnothing\); // 初始化分解 \(\rho\) 为空集
- 对 \(F\) 中的每一个函数依赖 \(X \rightarrow Y\) 做如下处理:
- 如果在分解 \(\rho\) 中找不到满足下述条件的关系模式 \(Z(U_Z, F_Z)\):\(XY \subseteq U_Z\)
- 则由 \(X\) 和 \(Y\) 合并构成一个新的子关系模式并加入到分解 \(\rho\) 中;
- 如果关系 \(R\) 的所有候选码都没有出现在分解 \(\rho\) 的关系模式中,即:找不到一个原关系 \(R\) 的候选码 \(K\) 和一个关系模式 \(Z(U_Z, F_Z)\) (\(Z \in \rho\)),满足 \(K \subseteq U_Z\) 那么,就从关系 \(R\) 中任选一个候选码 \(K\),由 \(K\) 中的属性单独构成一个关系模式并加入到分解 \(\rho\) 中去。
【计算示例】 有关系模式 \(R(A, B, C, D, E, F)\) 及其极小函数依赖集:\(\{ B \to F,\ AD \to BE,\ E \to CD \}\)
令 \(\rho = \varnothing\),
\(Z_1(U_1, F_1) = Z_1(\{B, F\}, \{B \to F\})\),
\(Z_2(U_2, F_2) = Z_2(\{A, B, D, E\}, \{AD \to BE\})\),
\(Z_3(U_3, F_3) = Z_3(\{C, D, E\}, \{E \to CD\})\),
则 \(\rho = \{Z_1, Z_2, Z_3\}\)
对于关系 \(R\) 的所有候选码 \(\{A, E\}, \{A, D\}\) (已计算)
\(\{A, E\} \subseteq U_2\), \(\{A, D\} \subseteq U_2\)
故 \(\rho = \{Z_1, Z_2, Z_3\}\)
故关系 \(R\) 满足 \(3NF\) 且具有无损连接性和保持函数依赖的分解为
\(\{Z_1(\{B, F\}, \{B \to F\}),~ Z_2(\{A, B, D, E\}, \{AD \to BE\}),~ Z_3(\{C, D, E\}, \{E \to CD\})\}\)
【算法】转换为 BCNF 的无损连接分解
❑ 输入:关系模式 \(R(U, F)\) ❑ 输出:到 BCNF 且具有无损连接性的分解 \(\rho\) ❑ 算法: ① 令 \(\rho = \{ R(U, F) \}\) ② 检查 \(\rho\) 中各关系模式是否均属于 BCNF。若是,则算法终止。 ③ 设 \(\rho\) 中 \(R_i(U_i, F_i) \notin BCNF\),那么必有 \(X \to A \in F_i^+\) \((A \notin X)\),且 \(X\) 非 \(R_i\) 的候选码。对 \(R_i(U_i, F_i)\) 进行如下分解:
- \(\sigma = \{S_1, S_2\}\),\(U_{S_1} = XA\),\(U_{S_2} = U_i - A\)(只砍 A)
- 以 \(\sigma\) 代替 \(\rho\) 中的 \(R_i(U_i, F_i)\)
- 返回步骤 ②
【计算示例】有关系模式 \(R(A, B, C, D, E, F)\) 及其极小函数依赖集:\(\{ B \to F,\ AD \to BE,\ E \to CD \}\)
令 \(\rho = \{ R(U, F) \}\)
对 \(R\) 中的 \(B \to F\),\(B\) 不是 \(R\) 的候选码
令 \(U_{S_1} = \{B, F\}\),\(F_{S_1} = \{B \to F\}\)
\(U_{S_2} = U - F = \{A, B, C, D, E\}\),\(F_{S_2} = \{AD \to BE, E \to CD\}\)
令 \(\sigma = \{S_1, S_2\}\),以 \(\sigma\) 代替 \(\rho\) 中的 \(R\) 得
\(\rho = \{ S_1(\{B, F\}, \{B \to F\}), S_2(\{A, B, C, D, E\}, \{AD \to BE, E \to CD\}) \}\)
经计算,\(S_2\) 的候选码为 \(\{A, D\}, \{A, E\}\)
对 \(S_2\) 中的 \(E \to CD\),\(E\) 不是 \(S_2\) 的候选码
令 \(U_{S_3} = \{C, D, E\}\),\(F_{S_3} = \{E \to CD\}\)
\(U_{S_4} = S_2 - \{C, D\} = \{A, B, E\}\)
由 \(E \to CD\) 得 \(AE \to ACD \to AD \to BE \to B\)
故 \(F_{S_4} = \{AE \to B\}\)
令 \(\sigma = \{S_3, S_4\}\),以 \(\sigma\) 代替 \(\rho\) 中的 \(S_2\) 得
\(\rho = \{ S_1(\{B, F\}, \{B \to F\}), S_3(\{C, D, E\}, \{E \to CD\}), S_4(\{A, B, E\}, \{AE \to B\}) \}\)
经检验,此时 \(\rho\) 中各关系模式均属于 \(BCNF\)
故关系 \(R\) 满足 \(BCNF\) 的分解结果为
\(\rho = \{ S_1(\{B, F\}, \{B \to F\}), S_3(\{C, D, E\}, \{E \to CD\}), S_4(\{A, B, E\}, \{AE \to B\}) \}\)
标题:第6章 关系数据理论
作者:Zwing
创建于:2026-08-08 19:01:00
更新于:2026-08-08 12:06:24
链接:https://zanytriumph.github.io/posts/关系数据理论.html
版权声明:本文章采用 CC BY-NC-SA 4.0 进行许可